
Tout en travaillant sur le problème de réglage de l'application Spark, J'ai passé beaucoup de temps à essayer de comprendre les visualisations de l'interface utilisateur Web Spark. Spark Web UI est un outil très utile pour cette tâche. Pour les débutants, il devient très difficile d'avoir un aperçu d'un problème uniquement à partir de ces visualisations. Bien qu'il existe de très bonnes ressources sur les performances de Spark, l'information était dispersée. Donc, J'ai ressenti le besoin de documenter et de partager mes apprentissages.
Public cible et conclusions
Cet article suppose que les lecteurs ont une compréhension de base des concepts Spark.. Cet article aidera les débutants à identifier les problèmes de performances potentiels dans leurs applications exécutées à partir d'une interface utilisateur Web Spark.. L'accent est mis uniquement sur les informations qui ne sont pas évidentes à partir de l'interface utilisateur et les déductions qui peuvent être tirées de ces informations non évidentes. Notez qu'il ne contient pas une liste exhaustive d'informations à interpréter à partir de Spark Web UI, mais seulement ceux que j'ai trouvé pertinents pour mon projet et, cependant, assez général pour que le public sache.
Interface utilisateur Web Spark
L'interface utilisateur Web de Spark n'est disponible que lorsque l'application est en cours d'exécution. Pour analyser les exécutions passées, les serveur d'historique doit être activé pour stocker les journaux d'événements qui peuvent ensuite être utilisés pour remplir l'interface utilisateur Web.
Spark Web UI affiche des informations utiles sur votre application dans des onglets, a savoir
- Exécuteurs
- Environnement
- Travaux
- Etapas
- Stockage
Le post restant décrit les intuitions de chacun des onglets, dans l'ordre mentionné.
Onglet Exécuteurs
Donne des informations sur les tâches exécutées par chaque exécuteur.
Figure 1: Résumé de l'onglet Exécuteur
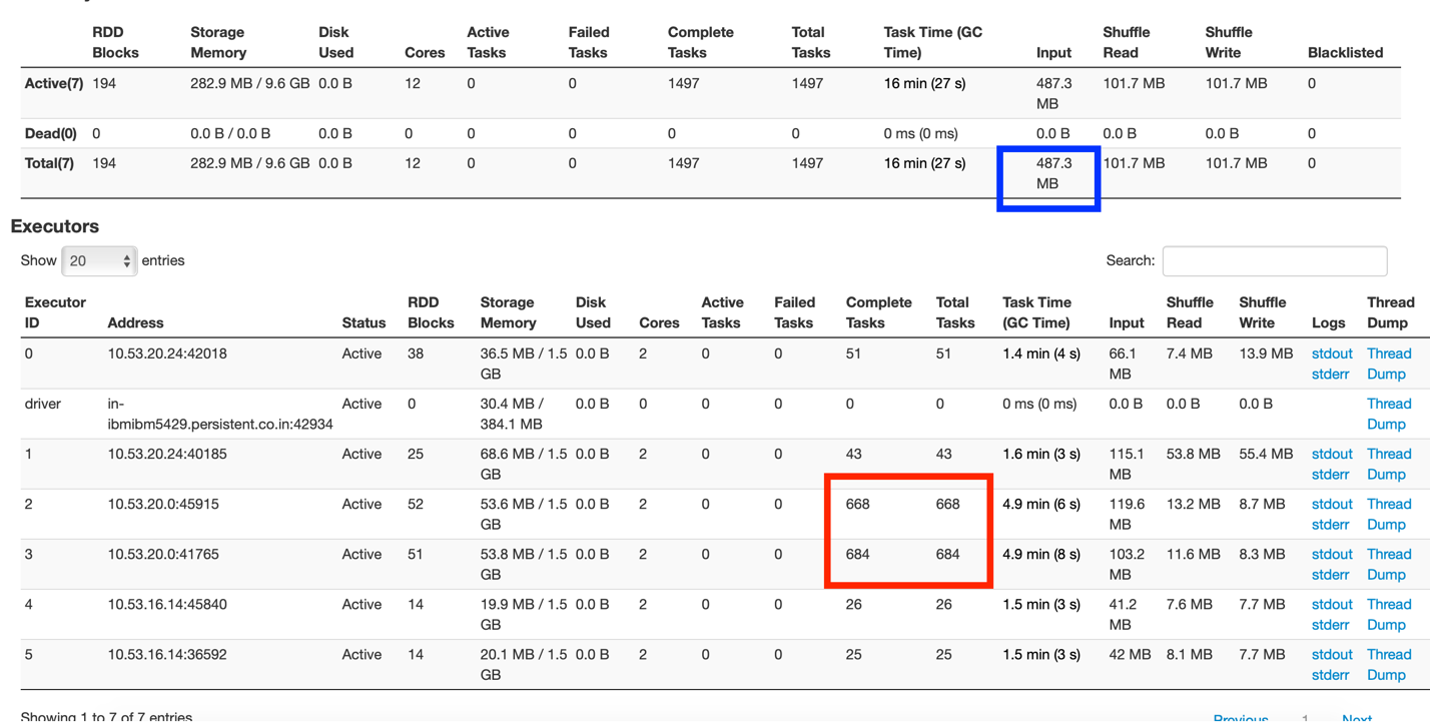
A partir de la chiffre"Chiffre" est un terme utilisé dans divers contextes, De l’art à l’anatomie. Dans le domaine artistique, fait référence à la représentation de formes humaines ou animales dans des sculptures et des peintures. En anatomie, désigne la forme et la structure du corps. En outre, en mathématiques, "chiffre" Il est lié aux formes géométriques. Sa polyvalence en fait un concept fondamental dans de multiples disciplines.... 1, on peut comprendre qu'il y a un contrôleur et 5 exécuteurs testamentaires, dont chacun fonctionne avec 2 noyaux et 3 Go de mémoire.
La case marquée en rouge muestra la distribución desigual de las tareas en las que un nœudNodo est une plateforme digitale qui facilite la mise en relation entre les professionnels et les entreprises à la recherche de talents. Grâce à un système intuitif, Permet aux utilisateurs de créer des profils, Partager des expériences et accéder à des opportunités d’emploi. L’accent mis sur la collaboration et le réseautage fait de Nodo un outil précieux pour ceux qui souhaitent élargir leur réseau professionnel et trouver des projets qui correspondent à leurs compétences et à leurs objectifs.... du grappeUn cluster est un ensemble d’entreprises et d’organisations interconnectées qui opèrent dans le même secteur ou la même zone géographique, et qui collaborent pour améliorer leur compétitivité. Ces regroupements permettent le partage des ressources, Connaissances et technologies, favoriser l’innovation et la croissance économique. Les grappes peuvent couvrir une variété d’industries, De la technologie à l’agriculture, et sont fondamentaux pour le développement régional et la création d’emplois.... está exagerando las tareas, tandis que d'autres sont relativement inactifs.
La case marquée en bleu montre que la taille des données d'entrée était 487,3 Mo. À présent, cette application a fonctionné sur une taille de jeu de données de 83 Mo. La taille des données d'entrée comprend la lecture de l'ensemble de données d'origine et les transferts de données aléatoires entre les nœuds. Cela montre que beaucoup de données ont été mélangées (environ 400+ Mo) dans l'appli.
Onglet Environnement
Il y a beaucoup de propriétés de l'étincelle pour contrôler et ajuster l'application. Ces propriétés peuvent être définies lors de la soumission du travail ou de la création de l'objet de contexte. Sauf si la propriété est explicitement ajoutée, Ne s'applique pas. Nous avons tort de supposer que les propriétés sont appliquées avec leurs valeurs par défaut, lorsqu'il n'est pas explicitement indiqué. Toutes les propriétés appliquées sont visibles dans l'onglet Environnement. Si la propriété n'y est pas vue, signifie que la propriété n'a pas été appliquée du tout.
Onglet Tâches
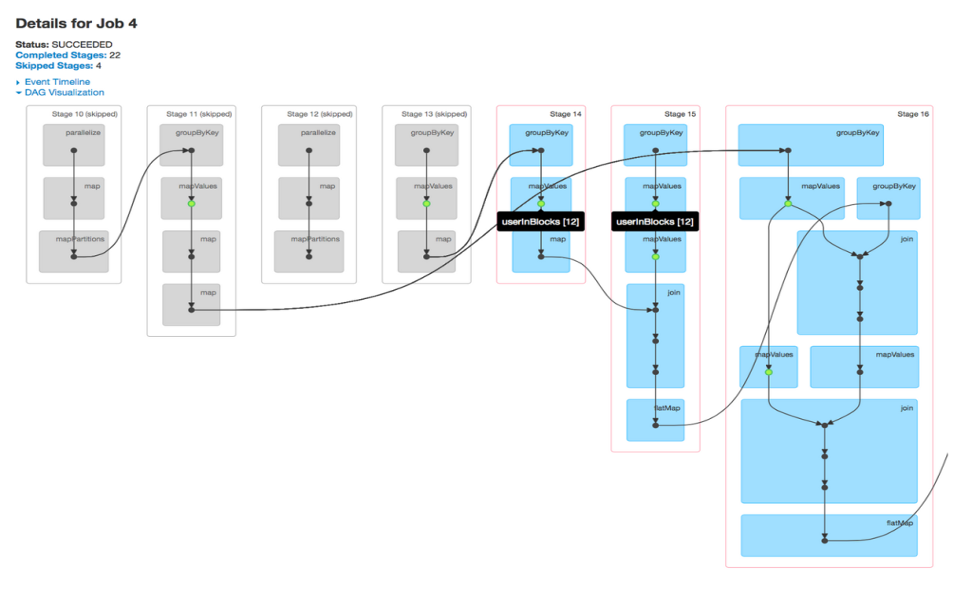
Un trabajo está asociado con una cadena de dependencias Resilient Distributed Jeu de donnéesUn "base de données" ou ensemble de données est une collection structurée d’informations, qui peut être utilisé pour l’analyse statistique, Apprentissage automatique ou recherche. Les ensembles de données peuvent inclure des variables numériques, catégorique ou textuelle, Et leur qualité est cruciale pour des résultats fiables. Son utilisation s’étend à diverses disciplines, comme la médecine, Économie et sciences sociales, faciliter la prise de décision éclairée et l’élaboration de modèles prédictifs.... organizadas en un diagramme acyclique direct (JOURNÉE) qui ressemble à la figue. 2. À partir des visualisations DAG, vous pouvez trouver les étapes exécutées et le nombre d'étapes sautées. Par défaut, Spark ne réutilise pas ses étapes calculées par étapes, sauf si persisté ou explicitement mis en cache. Les étapes ignorées sont des étapes mises en cache marquées en gris, donde los valores de cálculo se almacenan en la memoria y no se vuelven a calcular después de acceder a HDFSHDFS, o Système de fichiers distribués Hadoop, Il s’agit d’une infrastructure clé pour stocker de gros volumes de données. Conçu pour fonctionner sur du matériel commun, HDFS permet la distribution des données sur plusieurs nœuds, Garantir une disponibilité élevée et une tolérance aux pannes. Son architecture est basée sur un modèle maître-esclave, où un nœud maître gère le système et les nœuds esclaves stockent les données, faciliter le traitement efficace de l’information... Un coup d'œil à la visualisation du DAG suffit pour savoir si les calculs RDD sont effectués à plusieurs reprises ou si des étapes mises en cache sont utilisées.
Figure 2: Affichage DAG d'un travail
Onglet Étapes
Fournit un aperçu plus approfondi de l'application en cours d'exécution au niveau de la tâche. Une étape représente un segment de travail effectué en parallèle par des tâches individuelles. Il existe une cartographie 1-1 entre les tâches et les partitions de données, c'est-à-dire, 1 tâche par partition de données. On peut se plonger dans un travail, dans des étapes spécifiques et jusqu'à chaque tâche dans une étape à partir de l'interface utilisateur Web Spark.
La scène donne un bon aperçu des exécutions: Afficheurs DAG, chronologie des événements, métriques récapitulatives / agrégation de vos tâches.
Je préfère regarder la chronologie des événements pour analyser les tâches. Ils donnent une représentation picturale des détails du temps investi dans l'exécution de la scène. D'un seul regard, nous pourrions faire des inférences rapides sur la performance de la scène et sur la façon dont nous pourrions encore améliorer le temps d'exécution.
Figure 3 – Exemple de chronologie d'événement
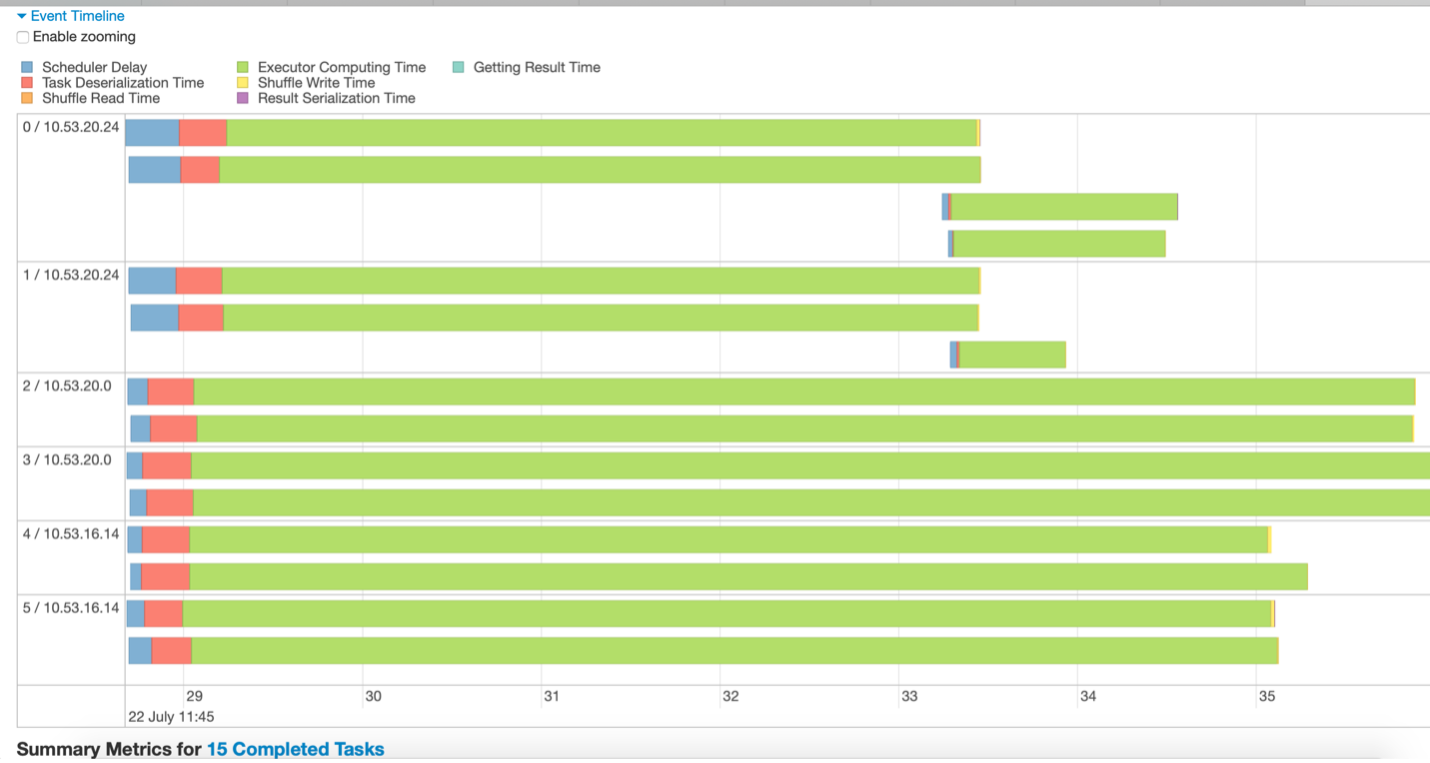
Par exemple, les déductions tirées de la figure 3 pourraient être:
- Les données sont divisées en 15 partitions. Donc, Ils sont en cours d'exécution 15 devoirs (représenté avec 15 lignes vertes).
- Les tâches s'exécutent dans 3 nœuds, chacun avec 2 exécuteurs testamentaires
- L'étape ne se termine que lorsque la tâche la plus longue se termine. Les autres exécuteurs restent inactifs jusqu'à ce que la tâche la plus longue soit terminée.
- Peu de tâches de longue haleine, alors que peu de tâches s'exécutent pendant très peu de temps, indiquant que les données ne sont pas bien partitionnées.
- Peu de temps a été consacré à retarder le planificateur ou la sérialisation à ce stade, ce qui est bon.
Figure. 4 – Chronologie des événements en une étape avec de nombreuses partitions de données.
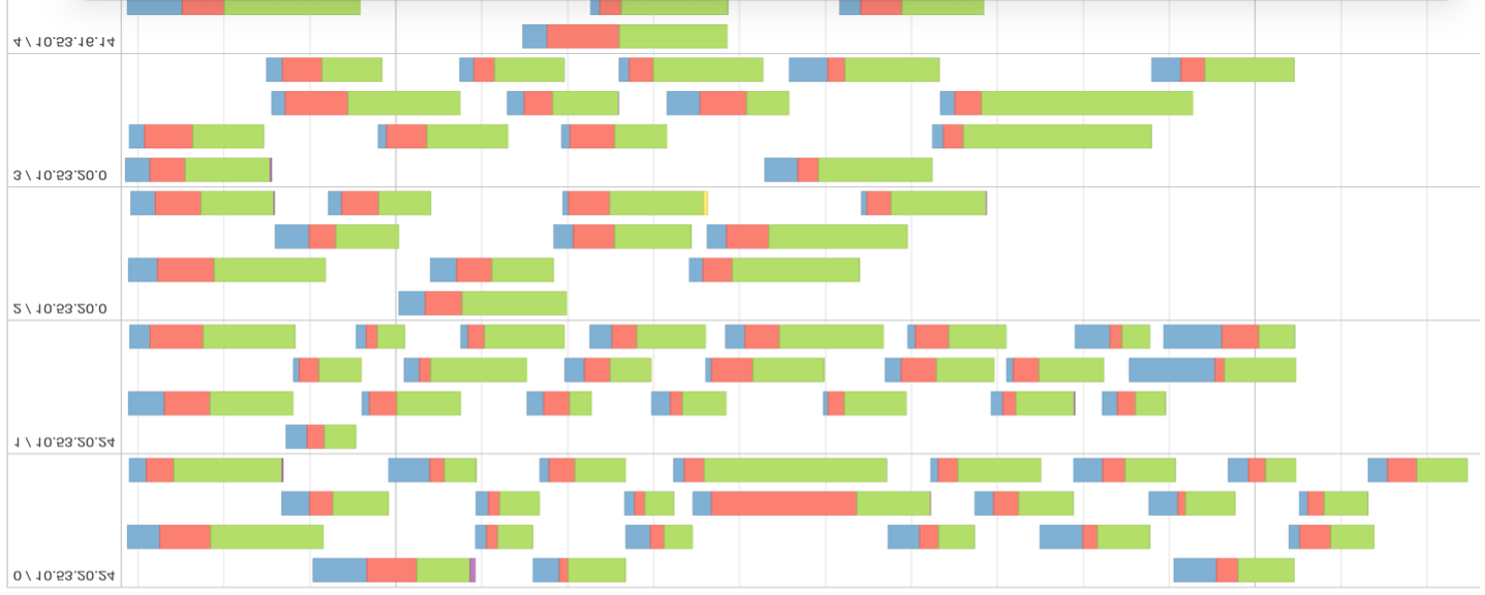
Observer la figure 4, on peut en déduire que les données ne sont pas bien réparties et inutilement partitionnées. De la métrique d'évaluation, il peut être confirmé que la planification de la tâche a pris plus de temps que le temps d'exécution réel. Plus le pourcentage de vert dans la chronologie est élevé, plus le calcul du palier sera efficace.
Il est souhaitable d'avoir moins d'étapes dans le travail. Chaque fois que les données sont mélangées, une nouvelle étape est créée. Le brassage coûte cher et, donc, essayez de réduire le nombre d'étapes dont votre programme a besoin.
Taille des données d'entrée
Une autre information importante est d'observer la taille d'entrée des données qui ont été mélangées. L'un des objectifs est également de réduire la taille de ces données aléatoires.
Figure. 5 – Présentation de l'onglet Étapes.
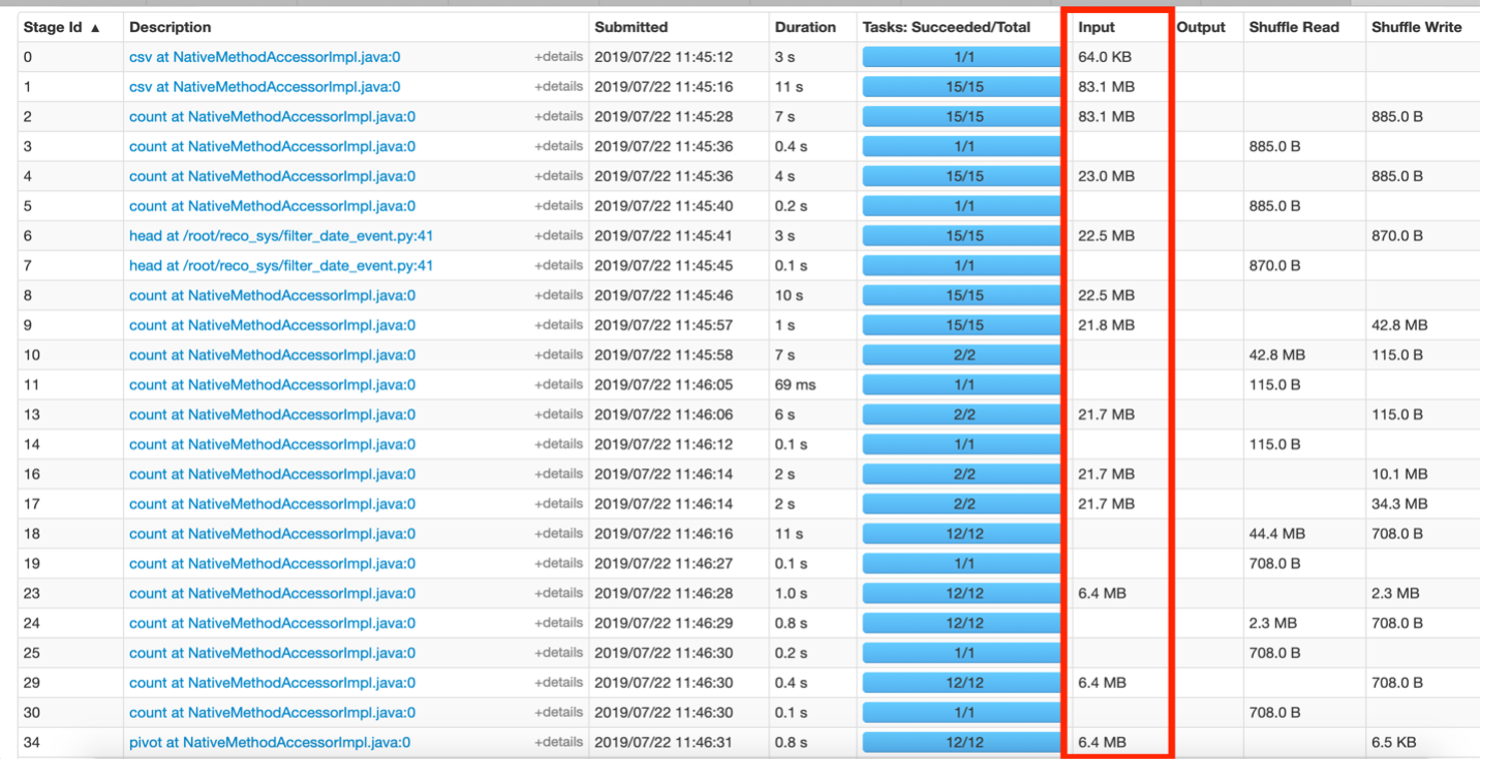
La figure 5 ci-dessus montre les étapes dans lesquelles les données se déplacent en Mo. Cela suggère que le code peut être amélioré pour réduire la taille des données qui ont été échangées entre les étapes. Par exemple, digamos que si se aplicó un filtro en algunos datos para un evento ‘X’ dé, puis dans le RDD résultant, la columna “evento” se vuelve redundante ya que técnicamente todas las filas son del evento ‘X’. Cette colonne pourrait être supprimée des futurs RDD créés à partir de ces données filtrées pour enregistrer des informations supplémentaires transférées lors des opérations de lecture aléatoire.
JetonLa "Jeton" C’est un terme utilisé dans divers contextes, Il s’agit généralement d’un document ou d’une carte qui contient des informations spécifiques sur un sujet, personne ou produit. Dans les milieux universitaires, Il est utilisé pour enregistrer des données pertinentes sur des sources de recherche ou bibliographiques. Dans le milieu des affaires, Les cartes peuvent être des outils utiles pour organiser les données des clients ou des produits, faciliter la gestion et l’accès à l’information.... de almacenamiento
Affiche uniquement les RDD qui ont été conservés, c'est-à-dire, qui utilisent persister () o cache (). Pour le rendre plus lisible, vous pouvez nommer le RDD tout en le stockant en utilisant setName (). Seuls les RDD que vous souhaitez conserver doivent être affichés dans l'onglet Stockage et pourraient être facilement reconnaissables avec les noms personnalisés fournis.
résumé
Cet article fournit des informations pour identifier les problèmes d'interface utilisateur Web Spark, comme la taille des données qui ont été mélangées, le temps d'exécution des étapes, Recalcul RDD en raison d'un manque de mise en cache. Si l'on comprend ses données et son application, alors la distribution idéale des données et le nombre souhaité de partitions pourraient être mesurés en déduisant de l'interface utilisateur en cours d'exécution. La surcharge d'un nœud par rapport aux autres dans le cluster est un autre domaine à améliorer qui pourrait être vu dans cette interface utilisateur. La résolutionLa "résolution" fait référence à la capacité de prendre des décisions fermes et d’atteindre les objectifs fixés.. Dans des contextes personnels et professionnels, Il s’agit de définir des objectifs clairs et d’élaborer un plan d’action pour les atteindre. La résolution est essentielle à la croissance personnelle et à la réussite dans divers domaines de la vie, car cela vous permet de surmonter les obstacles et de rester concentré sur ce qui compte vraiment.... de algunos de estos problemas se discute más en el Article sur le réglage des performances d'Apache Spark.
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





