
Tableaux dynamiques: le couteau suisse de l'analyse des données
J'aime la rapidité avec laquelle je peux analyser les données à l'aide de tableaux croisés dynamiques. Avec un clic de ma souris, Je peux accéder aux détails granulaires d'une certaine catégorie de produits, ou effectuez un zoom arrière et obtenez un aperçu de haut niveau des données disponibles.
Les tableaux croisés dynamiques m'offrent beaucoup de flexibilité en tant que data scientist. Je vais être honnête: Je m'appuie fortement sur eux lors de la phase d'analyse exploratoire des données d'un projet de science des données.
Les utilisateurs d'Excel connaîtront intimement ces tableaux croisés dynamiques. Ils sont la fonctionnalité la plus utilisée d'Excel, Et il est facile de voir pourquoi! Mais saviez-vous que vous pouvez créer ces tableaux croisés dynamiques en utilisant Pandas en Python?

C'est correct! La merveilleuse bibliothèque Pandas propose une fonction appelée pivot_table qui résume les valeurs d'une fonctionnalité dans un tableau à deux dimensions soigné.. Nous allons voir comment construire un table dynamiqueLe tableau croisé dynamique est un outil puissant dans les tableurs, tels que Microsoft Excel et Google Sheets. Vous permet de résumer, Analysez et visualisez efficacement de grands volumes de données. Grâce à son interface intuitive, Les utilisateurs peuvent réorganiser les informations, Appliquez des filtres et créez des rapports personnalisés, faciliter la prise de décisions éclairées dans divers contextes, Du domaine de l’entreprise à la recherche académique.... de ce type en Python ici.
crème, très bientôt vous utiliserez ces tableaux croisés dynamiques dans vos propres projets. Veuillez noter que ce tutoriel suppose des connaissances de base sur Pandas et Python. Si vous êtes nouveau sur ces sujets, vous pouvez les récupérer dans les cours gratuits ci-dessous:
Table des matières
- Explorer l'ensemble de données Titanic avec Pandas en Python
- Construire un tableau croisé dynamique à l'aide de Pandas
- Comment regrouper des données à l’aide de la commande indiceLe "Indice" C’est un outil fondamental dans les livres et les documents, qui vous permet de localiser rapidement les informations souhaitées. Généralement, Il est présenté au début d’une œuvre et organise les contenus de manière hiérarchique, y compris les chapitres et les sections. Sa préparation correcte facilite la navigation et améliore la compréhension du matériau, ce qui en fait une ressource incontournable tant pour les étudiants que pour les professionnels dans divers domaines.... dans le tableau croisé dynamique?
- Comment exécuter un pivot avec un index multiple?
- Fonction d'agrégation différente pour différentes caractéristiques.
- Ajoutez des fonctionnalités spécifiques avec paramètresLes "paramètres" sont des variables ou des critères qui sont utilisés pour définir, mesurer ou évaluer un phénomène ou un système. Dans divers domaines tels que les statistiques, Informatique et recherche scientifique, Les paramètres sont essentiels à l’établissement de normes et de standards qui guident l’analyse et l’interprétation des données. Leur sélection et leur manipulation correctes sont cruciales pour obtenir des résultats précis et pertinents dans toute étude ou projet.... des valeurs
- Trouver la relation entre les caractéristiques avec le paramètre colonnes
- Traitement des données manquantes
Explorer l'ensemble de données Titanic à l'aide de Pandas en Python
Je suis sûr que vous avez rencontré l'ensemble de données Titanic lors de votre parcours en science des données. C'est l'un des premiers ensembles de données que nous collectons lorsque nous sommes prêts à explorer un projet.. Je vais l'utiliser pour vous montrer l'efficacité de table dynamique une fonction.
Nous importons les bibliothèques pertinentes:
importer des pandas au format pd
importer numpy en tant que np
importer matplotlib.pyplot en tant que plt
plt.style.use('ggplot')
Pour tous ceux qui ont oublié à quoi ressemble le jeu de données Titanic, je vous présente le jeu de données!
df = pd.read_csv('drive/Ma Drive/AV/train.csv')
df.head()

Je laisserai quelques fonctions pour faciliter l'analyse des données et démontrer les capacités du table dynamique une fonction:
df.drop(['PassengerId','Ticket','Nom'],inplace=Vrai,axe=1)
Il est temps de créer un tableau croisé dynamique en Python à l'aide de l'incroyable bibliothèque Pandas !! Nous allons explorer les différentes facettes d'un tableau croisé dynamique dans cet article et créer un tableau croisé dynamique étonnant et flexible à partir de zéro.
Comment regrouper des données à l'aide d'un index sur un tableau croisé dynamique?
- table dynamique nécessite un Les données et un indice paramètre
- Les données est la trame de données Pandas qui passe à la fonction
- indice est la fonction qui vous permet de regrouper vos données. La fonction d'index apparaîtra comme un index sur la table résultante.
j'utiliserai le ‘Sexe’ colonne comme le indice pour l'instant:
#a single index
table = pd.pivot_table(données=df,indice=['Sexe'])
tableau

Nous pouvons comparer instantanément toutes les valeurs caractéristiques pour les deux sexes. À présent, visualisons la découverte:

Bon, les passagères ont payé beaucoup plus pour les billets que les hommes.
Vous pouvez obtenir plus d'informations sur la façon d'afficher vos données ici.
Comment exécuter un pivot avec un index multiple?
Vous pouvez même utiliser plusieurs fonctions comme index pour regrouper vos données. Cela augmente le niveau de granularité dans le tableau résultant et vous pouvez être plus précis avec vos résultats:
#multiple indexes
table = pd.pivot_table(df,indice=['Sexe','Pclass'])
tableau

L'utilisation de plusieurs indices dans l'ensemble de données nous permet de convenir que la disparité dans le prix du billet pour Femme Oui masculin passagers était valable dans tous Classe P sur le titanesque.
Fonction d'agrégation différente pour différentes caractéristiques.
Les valeurs indiquées dans le tableau sont le résultat du résumé qui aggfunc s'applique aux données de fonction. aggfunc c'est une Función AgregadaLa fonction d’agrégation est un concept clé en économie qui représente la relation entre la production totale de biens et de services dans une économie et le niveau des prix. Cette fonction permet de comprendre comment l’offre et la demande globales varient en réponse à des changements dans des facteurs tels que les politiques budgétaire et monétaire. Son analyse est essentielle pour la formulation de stratégies économiques et la prédiction des cycles économiques.... Quoi table dynamique s'applique à vos données regroupées.
Par défaut, il est np.moyenne (), Mais vous pouvez également utiliser différentes fonctions complémentaires pour différentes fonctionnalités !! Fournissez simplement un dictionnaire en entrée du aggfunc paramètre avec le nom de la fonction comme clé et la fonction d'agrégat correspondante comme valeur.
j'utiliserai np.moyenne () Pour lui ‘L'âge’ caractéristique et np.sum () Pour lui ‘Sobrevivió’ caractéristique:
#different aggregate functions
table = pd.pivot_table(df,indice=['Sexe','Pclass'],aggfunc={'Âge':np.moyenne,'Survécu':np.sum})
tableau

Le tableau résultant est plus logique lors de l'utilisation de différentes fonctions d'agrégation pour différentes caractéristiques.
Ajouter des fonctionnalités spécifiques avec des paramètres de valeur
Mais, Qu'est-ce que tu ajoutes? Vous pouvez indiquer à Pandas les caractéristiques sur lesquelles appliquer la fonction d'agrégation, dans le valeur paramètre.
valeur Le paramètre est l'endroit où il indique à la fonction dans quelles fonctionnalités ajouter. C'est un champ facultatif et si vous ne spécifiez pas cette valeur, la fonction ajoutera toutes les caractéristiques numériques de l'ensemble de données:
table = pd.table_pivot(df,indice=['Sexe','Pclass'],valeurs=['Survécu'], aggfunc=np.mean)
tableau
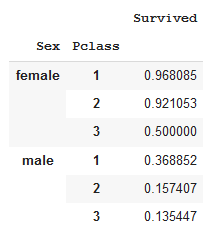
table.plot(type='bar');
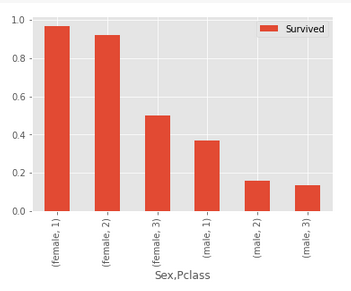
Le taux de survie des passagers à bord du Titanic a diminué avec une classe P dégradante entre les deux sexes. En outre, le taux de survie des passagers masculins était inférieur à celui des femmes dans une classe P donnée.
Trouver la relation entre les caractéristiques avec le paramètre colonnes
L'utilisation de plusieurs fonctions comme index est très bien, mais l'utilisation de certaines fonctions en tant que colonnes vous aidera à comprendre intuitivement la relation entre elles. En outre, le tableau résultant peut toujours être mieux visualisé en incorporant le Colonnes paramètre de la table dynamique.
Ce Colonnes Le paramètre est facultatif et affiche les valeurs horizontalement en haut du tableau résultant.
Les deux Colonnes et le indice Les paramètres sont facultatifs, mais son utilisation efficace vous aidera à comprendre intuitivement la relation entre les fonctions.
#columns
table = pd.pivot_table(df,indice=['Sexe'],colonnes=['Pclass'],valeurs=['Survécu'],aggfunc=np.sum)
tableau
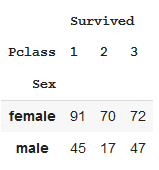
À l'aide de Classe P en tant que colonne est plus facile à comprendre que de l'utiliser comme index:
table.plot(type='bar');
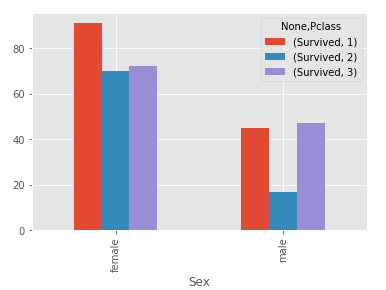
table dynamique il permet même de traiter les valeurs manquantes via des paramètres tomber Oui valeur_remplissage:
- tomber permet de supprimer les valeurs nulles dans une table en cluster dont les valeurs sont nulles
- valeur_remplissage Le paramètre peut être utilisé pour remplacer les valeurs NaN dans le tableau groupé par les valeurs que vous fournissez ici.
#afficher les valeurs nulles
table = pd.table_pivot(df,indice=['Sexe','Survécu','Pclass'],colonnes=['Embarquement'],valeurs=['Âge'],aggfunc=np.mean)
tableau

Je remplacerai les valeurs NaN par la valeur moyenne du ‘L'âge’ colonne:
#handling null values
table = pd.pivot_table(df,indice=['Sexe','Survécu','Pclass'],colonnes=['Embarquement'],valeurs=['Âge'],aggfunc=np.mean,fill_value=np.mean(df['Âge']))
tableau

Dans cet article, nous explorons les différents paramètres de l'incroyable table dynamique fonction et comment elle vous permet de résumer facilement les caractéristiques de votre ensemble de données via une seule ligne de code.
Si vous débutez dans la programmation Python et que vous souhaitez en savoir plus sur l'analyse de données avec Python, Je vous recommande d'explorer notre Python pour la science des données Oui Pandas pour l'analyse de données en Python cours.





