
« La prédiction est très difficile, surtout s'il s'agit du futur ».
des idées après avoir lu la belle citation ci-dessus. J'ai expliqué différentes bibliothèques automatisées pour automatiser l'apprentissage automatique et la tâche de PNL dans mes articles précédents. de la même manière, dans cet article, Je vais expliquer "Comment automatiser la prédiction de séries temporelles à l'aide d'Auto-TS".
Auto-TS fait partie d'AutoML qui automatisera certains des composants du processus d'apprentissage automatique. Cela automatise les bibliothèques et aide les non-experts à former un modèle d'apprentissage automatique de base sans avoir beaucoup de connaissances dans le domaine. Ici Dans cet article, Je vais discuter de la façon d'automatiser la mise en œuvre d'un modèle de prévision de séries chronologiques à l'aide de la bibliothèque Auto-TS.
Qu'est-ce qu'Auto-TS?
Il s'agit d'une bibliothèque Python open source qui est essentiellement utilisée pour automatiser la prévision des séries chronologiques. Il entraînera automatiquement plusieurs modèles de séries temporelles à l'aide d'une seule ligne de code, qui nous aidera à choisir le meilleur pour notre énoncé de problème.
Dans la bibliothèque Python open source, Auto-TS, auto-ts.Auto_TimeSeries () est la fonction principale que vous appellerez avec vos données de train. Alors, nous pouvons choisir le type de modèles que vous voulez, en tant que modèles statistiques, ml ou FB. También podemos ajustar los paramètresLes "paramètres" sont des variables ou des critères qui sont utilisés pour définir, mesurer ou évaluer un phénomène ou un système. Dans divers domaines tels que les statistiques, Informatique et recherche scientifique, Les paramètres sont essentiels à l’établissement de normes et de standards qui guident l’analyse et l’interprétation des données. Leur sélection et leur manipulation correctes sont cruciales pour obtenir des résultats précis et pertinents dans toute étude ou projet.... que seleccionarán automáticamente el mejor modelo en función del parámetro de puntuación en el que queremos que se base. Il renverra le meilleur modèle et un dictionnaire contenant des prédictions pour le nombre de Forecast_periods que vous avez mentionné (par défaut = 2).
Fonctionnalités de la bibliothèque Auto-TS:
- Trouvez le modèle de prédiction de séries chronologiques optimal en optimisant la programmation génétique.
- Former des modèles naïfs, statistiques, de aprendizaje automático y de l'apprentissage en profondeurL'apprentissage en profondeur, Une sous-discipline de l’intelligence artificielle, s’appuie sur des réseaux de neurones artificiels pour analyser et traiter de grands volumes de données. Cette technique permet aux machines d’apprendre des motifs et d’effectuer des tâches complexes, comme la reconnaissance vocale et la vision par ordinateur. Sa capacité à s’améliorer continuellement au fur et à mesure que de nouvelles données lui sont fournies en fait un outil clé dans diverses industries, de la santé..., avec tous les réglages d'hyperparamètres possibles et validation croisée.
- Effectuez des transformations de données pour gérer les données désordonnées en apprenant l'imputation NaN optimale et la suppression des valeurs aberrantes.
- Choix de combinaison de métriques pour la sélection de modèle.
Installation:
autots d'installation de pip  OU
pip3 installer auto-ts   OU
pip installer git+git://github.com/AutoViML/Auto_TS
Exigences:
crépuscule
scikit-apprendre
FB Prophète
modèles de statistiques
pmdarima
XGBoost
Importer une bibliothèque à l'aide:
de auto_ts importer auto_timeseries
Paramètres disponibles dans auto_timeseries:
modèle = auto_timeseries( score_type="rmse", intervalle_temps="Mois", non_seasonal_pdq=Aucun, saisonnalité=Faux, saison_période=12, type_modèle=['Prophet'], verbeux=2)
Vous pouvez régler les paramètres et analyser l'évolution des performances du modèle. Pour plus de détails sur les paramètres, cliquez sur ici.
Ensemble de données utilisé:
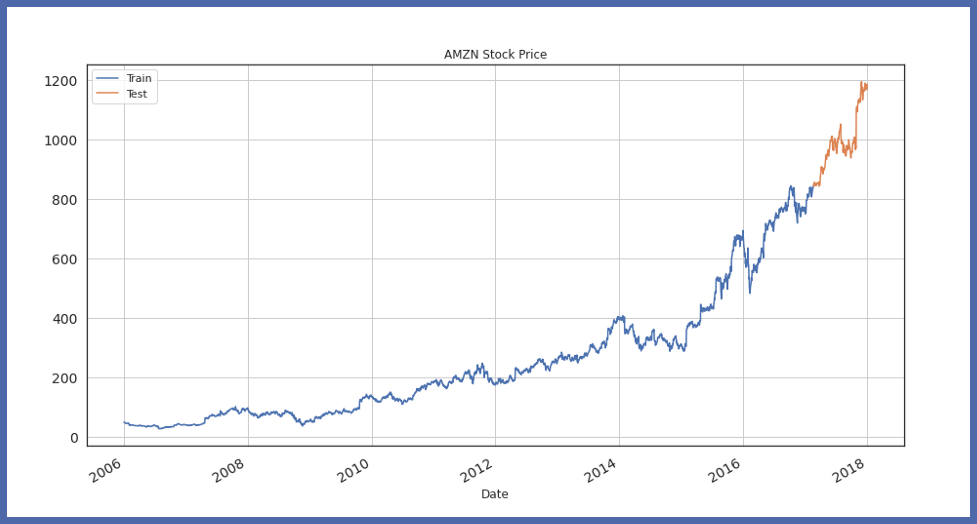
Ici, j'ai utilisé le Cours de l'action Amazon ensemble de données pour janvier 2006 à janvier 2018, qui est téléchargé à partir de Kaggle. Cette bibliothèque ne propose que des modèles de prédiction de séries temporelles de train. L'ensemble de données doit avoir une colonne de format de date ou d'heure.
Initialement, cargue el conjunto de datos de la Séries chronologiquesUne série chronologique est un ensemble de données collectées ou mesurées à des moments successifs, généralement à intervalles réguliers. Ce type d’analyse vous permet d’identifier des modèles, Tendances et cycles des données au fil du temps. Son application est large, couvrant des domaines tels que l’économie, Météorologie et santé publique, faciliter la prédiction et la prise de décision sur la base d’informations historiques.... con una columna de fecha y hora:
df = pd.read_csv("Amazon_Stock_Price.csv", usecols =['Date', 'Clôture'])
df['Date'] = pd.to_datetime(df['Date'])
df = df.sort_values('Date')
À présent, diviser toutes les données en données de test et d'entraînement:
train_df = df.iloc[:2800]
test_df = df.iloc[2800:]
À présent, nous visualiserons la division d'essai du train:
train_df.Fermer.plot(taille de la figue=(15,8), titre="Cours de l'action AMZN", taille de police=14, étiquette="Former")
test_df.Fermer.plot(taille de la figue=(15,8), titre="Cours de l'action AMZN", taille de police=14, étiquette="Test")
plt.légende()
plt.grid()
plt.show()
À présent, inicialicemos el objeto del modelo Auto-TS y ajustemos los datos de entraînementLa formation est un processus systématique conçu pour améliorer les compétences, connaissances ou aptitudes physiques. Il est appliqué dans divers domaines, Comme le sport, Éducation et développement professionnel. Un programme d’entraînement efficace comprend la planification des objectifs, Pratique régulière et évaluation des progrès. L’adaptation aux besoins individuels et la motivation sont des facteurs clés pour obtenir des résultats réussis et durables dans toutes les disciplines....:
modèle = auto_timeseries(prévision_période=219, score_type="rmse", intervalle_temps="ré", type_modèle="meilleur")
model.fit(traindata= train_df, ts_column="Date", cible="proche")
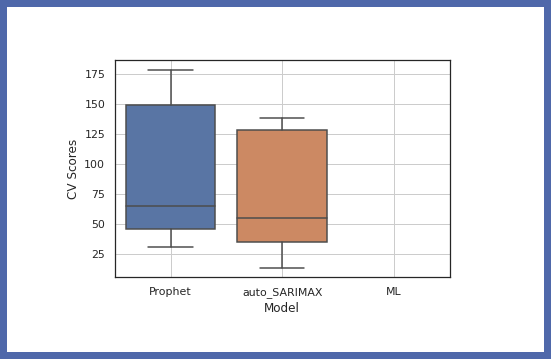
Comparons maintenant la précision de différents modèles:
model.get_leaderboard()
model.plot_cv_scores()
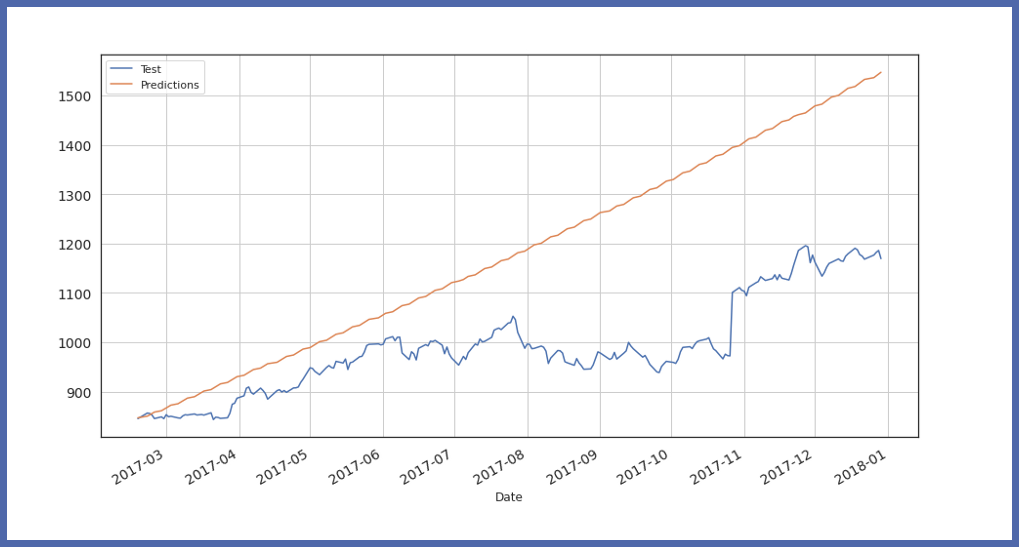
Testons maintenant notre modèle avec des données de test:
futures_predictions = model.predict(données de test=219)
Finalement, afficher la valeur et la prédiction des données de test:
Paramètres disponibles dans auto_timeseries:
modèle = auto_timeseries( score_type="rmse", intervalle_temps="Mois", non_seasonal_pdq=Aucun, saisonnalité=Faux, saison_période=12, type_modèle=['Prophet'], verbeux=2)
Paramètres disponibles dans model.fit ():
model.fit( traindata=train_data, ts_column=ts_column, cible=cible, cv=5, sep="," )
Paramètres disponibles dans model.predict ():
prédictions = model.predict( testdata = peut être soit une trame de données, soit un entier représentant la prévision_période, modèle="meilleur" ou toute autre chaîne représentant le modèle entraîné )
Vous pouvez jouer avec tous ces paramètres et analyser les performances de notre modèle, puis vous pouvez sélectionner le modèle le plus adapté à votre énoncé de problème.. Vous pouvez vérifier tous ces paramètres en détail en cliquant sur ici.
conclusion:
Dans cet article, J'ai expliqué comment le modèle de série chronologique peut être automatisé en une seule ligne de code Python. Auto-TS effectue le prétraitement des données, car il supprime les valeurs aberrantes des données et gère les données désordonnées en apprenant l'imputation NaN optimale. Utiliser une seule ligne de code, initialiser l'objet Auto-TS et ajuster les données du train, entraînera automatiquement plusieurs modèles de séries temporelles comme ARIMA, SARIMAX, FB Prophète, OÙ, et générera le modèle le plus performant qui convient à notre énoncé de problème. Le résultat du modèle semble dépendre de la taille de l'ensemble de données. Si nous essayons d'augmenter la taille de l'ensemble de données, le résultat peut certainement s'améliorer.
Note de fin
J'espère que cet article vous a plu. N'importe quelle question? Ai-je raté quelque chose? S'il vous plait, Contactez moi LinkedIn Ou laissez un commentaire ci-dessous. Et finalement, … Pas besoin de dire,
Merci pour la lecture!
Santé!!
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





