
Vue d'ensemble
- En savoir plus sur le modèle de pointe qu'est Transformers.
- Veuillez comprendre comment nous pouvons implémenter Transformers dans le problème de légende d'image déjà vu avec Tensorflow
- Comparaison des résultats des modèles Transformers vs Attention.
introduction
Nous avons vu que les mécanismes de l'attention (dans l'article précédent) sont devenus une partie intégrante de la modélisation de séquences convaincante et des modèles de transduction dans diverses tâches (comme légende des photos), permettant la modélisation des dépendances quelle que soit leur distance dans les séquences d'entrée ou de sortie.
Le transformateur, une architecture modèle qui évite la récurrence et, en échange, repose entièrement sur un mécanisme de soins pour établir des dépendances globales entre l'entrée et la sortie. L'architecture Transformer permet une parallélisation nettement supérieure et peut obtenir de nouveaux résultats de pointe en matière de qualité de traduction.
Dans cet article, voyons comment peut Mettre en œuvre le mécanisme d'attention pour générer des sous-titres avec Transformers à l'aide de TensorFlow.
Prérequis avant de commencer: –
Je vous recommande de lire cet article avant de commencer:
Table des matières
- Architecture de transformateur
- Mise en place du mécanisme d'attention pour la génération de sous-titres avec Transformers à l'aide de Tensorflow
- Importer les bibliothèques requises
- Chargement et prétraitement des données
- Définition du modèle
- Codage positionnel
- Soins multi-têtes
- Couche encodeur-décodeur
- Transformateur
- Hyperparamètres du modèle
- EntraînementLa formation est un processus systématique conçu pour améliorer les compétences, connaissances ou aptitudes physiques. Il est appliqué dans divers domaines, Comme le sport, Éducation et développement professionnel. Un programme d’entraînement efficace comprend la planification des objectifs, Pratique régulière et évaluation des progrès. L’adaptation aux besoins individuels et la motivation sont des facteurs clés pour obtenir des résultats réussis et durables dans toutes les disciplines.... de modèles
- Évaluation de l'UEBL
- Comparaison
- Suivant?
- Remarques finales
Architecture de transformateur
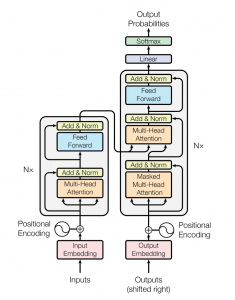
Le réseau de transformateurs utilise une architecture encodeur-décodeur similaire à celle d'un RNN. La principale différence est que les transformateurs peuvent recevoir la prière / séquence d'entrée parallèle, c'est-à-dire, il n'y a pas de pas de temps associé à l'entrée et tous les mots de la phrase peuvent être passés simultanément.
Commençons par comprendre l'entrée du transformateur.
Envisagez une traduction de l'anglais vers l'allemand. Nous alimentons la phrase entière en anglais à l'insert d'entrée. Une couche d'insertion d'entrée peut être considérée comme un point dans l'espace où des mots de sens similaire sont physiquement plus proches les uns des autres., c'est-à-dire, chaque mot est affecté à un vecteur avec des valeurs continues pour représenter ce mot.
À présent, un problème avec ceci est que le même mot dans différentes phrases peut avoir des significations différentes, c'est là qu'intervient l'encodage de position. Étant donné que les transformateurs ne contiennent pas de récurrence ou de convolution, pour que le modèle utilise l'ordre de la séquence, doit utiliser certaines informations sur la position relative ou absolue des mots dans une séquence. L'idée est d'utiliser des poids fixes ou appris qui codent des informations liées à une position spécifique d'un jeton dans une phrase.
de la même manière, le mot allemand cible est transmis à la modulation de sortie et son vecteur de codage positionnel est transmis au bloc décodeur.
Le bloc codeur a deux sous-couches. Le premier est un mécanisme d'auto-soins multi-têtes, et le second est un simple réseau d'alimentation directe, entièrement connecté selon la position. Pour chaque mot, nous pouvons générer un vecteur d'attention qui capture les relations contextuelles entre les mots d'une phrase. L'attention multidirectionnelle sur l'encodeur applique un mécanisme d'attention spécifique appelé auto-attention. L'auto-attention permet aux modèles d'associer chaque mot de l'entrée avec d'autres mots.
En plus des deux sous-couches dans chaque couche d'encodeur, le décodeur insère une troisième sous-couche, qui effectue une attention multi-têtes sur la sortie de la pile d'encodeurs. Similaire à l'encodeur, nous utilisons des connexions résiduelles autour de chacune des sous-couches, suivi de la normalisation des calques. Les vecteurs d'attention des mots allemands et les vecteurs d'attention des phrases anglaises de l'encodeur sont passés à la deuxième attention multicéphale.
Ce bloc d'attention déterminera à quel point chaque vecteur de mots est lié les uns aux autres.. C'est là que le mappage de mots anglais-allemand est effectué. Le décodeur est surmonté d'une couche linéaire qui agit comme un classificateur et un softmax pour obtenir les probabilités du mot.
Maintenant que vous avez une vue d'ensemble du fonctionnement des transformateurs, Voyons comment nous pouvons l'implémenter pour la tâche de légende d'image à l'aide de Tensorflow et comparer nos résultats avec d'autres méthodes.
Mise en place du mécanisme d'attention pour la génération de sous-titres avec Transformers à l'aide de TensorFlow
Vous pouvez trouver le code source complet dans mon Github profil.
Paso 1: – Importez les bibliothèques requises
Ici, nous allons utiliser Tensorflow pour créer notre modèle et l'entraîner. La majeure partie du crédit de code va à TensorFlow tutoriels. Vous pouvez utiliser les notebooks Google Colab ou Kaggle si vous souhaitez qu'un GPU vous entraîne.
chaîne d'importation
importer numpy en tant que np
importer des pandas au format pd
à partir du tableau d'importation numpy
à partir de l'image d'importation PIL
importer des cornichons

importer matplotlib.pyplot en tant que plt
importer le système, temps, tu, mises en garde
warnings.filterwarnings("ignorer")
importation re

importation dure
importer tensorflow en tant que tf
de tqdm importer tqdm
de nltk.translate.bleu_score importer phrase_bleu

de keras.preprocessing.sequence importer pad_sequences
de keras.utils importer vers_categorical
depuis keras.utils importer plot_model
à partir de keras.models importer le modèle
à partir de keras.layers importer Entrée
de keras.layers importer Dense, LotNormalisation
à partir de keras.layers importer LSTM
à partir de keras.layers importer
à partir de keras.layers import Dropout
de keras.layers.merge importer ajouter
à partir de keras.callbacks importer ModelCheckpoint
à partir de keras.preprocessing.image importer load_img, img_to_array
de keras.preprocessing.text import Tokenizer

depuis sklearn.utils import shuffle
de sklearn.model_selection importer train_test_split
Paso 2: – Chargement et prétraitement des données
Définir notre chemin d'image et de légende et vérifier combien d'images au total sont présentes dans l'ensemble de données.
chemin_image = "/content/gdrive/Mon Drive/FLICKR8K/Flicker8k_Dataset"
dir_Flickr_text = "/content/gdrive/Mon Drive/FLICKR8K/Flickr8k_text/Flickr8k.token.txt"
jpgs = os.listdir(chemin_image)

imprimer("Nombre total d'images dans l'ensemble de données = {}".format(longueur(jpg)))
Production:

Nous créons un bloc de données pour stocker l'identifiant et les légendes de l'image pour une utilisation facile.
fichier = ouvrir(dir_Flickr_text,'r')
texte = fichier.lire()
fichier.fermer()

txtdonnées = []
pour la ligne dans text.split('n'):
   col = ligne.split('t')
   si len(col) == 1:
       Continuez
   w = col[0].diviser("#")
   datatxt.append(w + [col[1].inférieur()])

données = pd.DataFrame(txt de données,colonnes=["nom de fichier","indice","légende"])
données = données.reindex(colonnes =['index','nom de fichier','légende'])
données = données[data.nom_fichier != '2258277193_586949ec62.jpg.1']
uni_filenames = np.unique(data.filename.values)

data.head()
Production: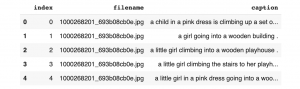
Ensuite, Visualisons quelques images et leurs 5 légendes:
npic = 5
npix = 224
taille_cible = (npix,npix,3)
compter = 1

fig = plt.figure(taille de la figue=(10,20))
pour jpgfnm dans uni_filenames[10:14]:
   nom_fichier = chemin_image + '/' + jpgfnm
   légendes = liste(Les données["légende"].endroit[Les données["nom de fichier"]== jpgfnm].valeurs)
   image_load = load_img(nom de fichier, target_size=target_size)
   ax = fig.add_subplot(npic,2,compter,xticks=[],yticks=[])
   ax.imshow(image_load)
   compte += 1

   ax = fig.add_subplot(npic,2,compter)
   plt.axis('désactivé')
   ax.plot()
   ax.set_xlim(0,1)
   ax.set_ylim(0,longueur(légendes))
   pour moi, légende dans énumérer(légendes):
       ax.texte(0,je,légende,taille de police=20)
   compte += 1
plt.show()
Production:
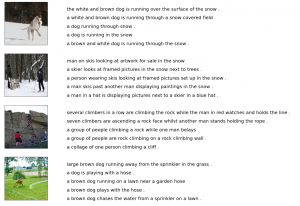
Ensuite, Voyons quelle est la taille de notre vocabulaire actuel: –
vocabulaire = []
pour txt dans data.caption.values:
   vocabulaire.étendre(txt.split())
imprimer('Taille du vocabulaire': %d' % longueur(ensemble(vocabulaire)))
Production:
 Ensuite, effectuer un nettoyage de texte, comment supprimer la ponctuation, caractères individuels et valeurs numériques:
def remove_ponctuation(text_original):
   text_no_punctuation = text_original.translate(chaîne.ponctuation)
   revenir(text_no_ponctuation)

def remove_single_character(texte):
   text_len_more_than1 = ""
   pour mot dans text.split():
       si len(mot) > 1:
           text_len_more_than1 += " " + mot
   revenir(text_len_more_than1)

def remove_numeric(texte):
   text_no_numeric = ""
   pour mot dans text.split():
       isalpha = mot.isalpha()
       si isalpha:
           text_no_numeric += " " + mot
   revenir(text_no_numeric)

def text_clean(text_original):
   texte = remove_ponctuation(text_original)
   texte = remove_single_character(texte)
   texte = remove_numeric(texte)
   revenir(texte)

pour moi, légende dans énumérer(data.caption.values):
   newcaption = text_clean(légende)
   Les données["légende"].iloc[je] = nouvelle légende
Voyons maintenant la taille de notre vocabulaire après le nettoyage.
propre_vocabulaire = []
pour txt dans data.caption.values:
   clean_vocabulary.extend(txt.split())
imprimer('Taille du vocabulaire nettoyée': %d' % longueur(ensemble(propre_vocabulaire)))
Production:
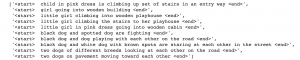
 Ensuite, nous sauvegardons tous les titres et chemins des images dans deux listes afin de pouvoir charger les images en même temps en utilisant le chemin établi. Nous ajoutons également des balises » Oui » à chaque titre pour que le modèle comprenne le début et la fin de chaque titre.
CHEMIN = "/content/gdrive/Mon Drive/FLICKR8K/Flicker8k_Dataset/"
all_captions = []
pour la légende dans les données["légende"].astype(str):
   légende = '<début> ' + légende + ' <finir>'
   all_captions.append(légende)

toutes_légendes[:10]
Production:
all_img_name_vector = []
pour annot dans les données["nom de fichier"]:
   full_image_path = CHEMIN + annot
   all_img_name_vector.append(chemin_image_complet)

all_img_name_vector[:10]
Production:
Maintenant, vous pouvez voir que nous avons 40455 chemins et légendes des images.
imprimer(F"longueur(all_img_name_vector) : {longueur(all_img_name_vector)}")
imprimer(F"longueur(toutes_légendes) : {longueur(toutes_légendes)}")
Production:

Nous prendrons seul 40000 de chacun afin que nous puissions sélectionner la taille du lot correctement, c'est-à-dire, 625 lots si taille du lot = 64. Pour faire ceci, nous définissons une fonction pour limiter l'ensemble de données à 40000 images et légendes.
def data_limiter(sur une,total_captions,all_img_name_vector):
   train_captions, img_name_vector = aléatoire(total_captions,all_img_name_vector,état_aléatoire=1)
   train_captions = train_captions[:sur une]
   img_name_vector = img_name_vector[:sur une]
   retour train_captions,img_name_vector

train_captions,img_name_vector = data_limiter(40000,total_captions,all_img_name_vector)
Paso 3: – Définition du modèle
Définissons le modèle d'extraction de caractéristiques d'image à l'aide d'InceptionV3. Nous devons nous rappeler que nous n'avons pas besoin de classer les images ici, nous avons juste besoin d'extraire un vecteur d'image pour nos images. Donc, nous supprimons la couche softmax du modèle. Nous devons tous prétraiter toutes les images à la même taille, c'est-à-dire, 299 × 299 avant de les insérer dans le modèle, et la forme de sortie de cette couche est 8x8x2048.
def load_image(chemin_image):
   img = tf.io.read_file(chemin_image)
   img = tf.image.decode_jpeg(img, canaux=3)
   img = tf.image.resize(img, (299, 299))
   img = tf.keras.applications.inception_v3.preprocess_input(img)
   retourner img, image_path

image_model = tf.keras.applications.InceptionV3(include_top=Faux, poids="imagenet")
new_input = image_model.input
hidden_layer = image_model.layers[-1].output
image_features_extract_model = tf.keras.Model(nouvelle_entrée, hidden_layer)
Ensuite, attribuons le nom de chaque image à la fonction pour charger l'image. Nous allons prétraiter chaque image avec InceptionV3 et mettre en cache la sortie sur le disque et les caractéristiques de l'image seront reformatées pour 64 × 2048.
encode_train = trié(ensemble(img_name_vector))
image_dataset = tf.data.Dataset.from_tensor_slices(encoder_train)
image_dataset = image_dataset.map(load_image, num_parallel_calls=tf.data.experimental.AUTOTUNE).grouper(64)
Nous extrayons les caractéristiques et les stockons dans les .npy puis transmettre ces caractéristiques à l'encodeur.Les fichiers NPY stockent toutes les informations nécessaires pour reconstruire un tableau sur n'importe quel ordinateur, y compris les informations sur le type et la forme.
pour img, chemin dans tqdm(image_dataset):
   batch_features = image_features_extract_model(img)
   batch_features = tf.reshape(batch_features,
                              (batch_features.shape[0], -1, batch_features.shape[3]))

 pour bf, p en zip(batch_features, chemin):
   path_of_feature = p.numpy().décoder("utf-8")
   np.save(chemin_de_fonction, bf.numpy())
Ensuite, nous convertissons les sous-titres en jetons et créons un vocabulaire de tous les mots uniques dans les données. Nous limiterons également la taille du vocabulaire à 5000 mots principaux pour économiser de la mémoire. Nous remplacerons les mots qui ne sont pas dans le vocabulaire par le jeton
top_k = 5000
tokenizer = tf.keras.preprocessing.text.Tokenizer(nombre_mots=top_k,
                                                 oov_token="<unk>",
                                                 filtres="!"#$%&()*+.,-/:;[email protégé][]^_`{|}~ ")

tokenizer.fit_on_texts(train_captions)
train_seqs = tokenizer.texts_to_sequences(train_captions)
tokenizer.word_index['<tampon>'] = 0
tokenizer.index_word[0] = '<tampon>'

train_seqs = tokenizer.texts_to_sequences(train_captions)
cap_vector = tf.keras.preprocessing.sequence.pad_sequences(train_seqs, remplissage='post')
Ensuite, créer des ensembles d'entraînement et de validation à l'aide d'un fractionnement 80-20:
img_name_train, img_name_val, cap_train, cap_val = train_test_split(img_name_vector,cap_vector, taille_test=0.2, état_aléatoire=0)
Ensuite, créons un ensemble de données tf.data à utiliser pour entraîner notre modèle.
TAILLE_LOT = 64
TAILLE_TAMPON = 1000
nombre_pas = longueur(img_name_train) // TAILLE DU LOT

déf map_func(nom_img, casquette):
   img_tensor = np.load(nom_img.decode('utf-8')+'.npy')
   revenir img_tenseur, casquette

dataset = tf.data.Dataset.from_tensor_slices((img_name_train, cap_train))
jeu de données = jeu de données.carte(lambda objet 1, élément2: tf.numpy_function(map_func, [objet 1, élément2], [tf.float32, tf.int32]),num_parallel_calls=tf.data.experimental.AUTOTUNE)
ensemble de données = ensemble de données.shuffle(BUFFER_SIZE).grouper(TAILLE DU LOT)
ensemble de données = ensemble de données.prefetch(buffer_size=tf.data.experimental.AUTOTUNE)
Paso 4: – Codage positionnel
Le codage positionnel utilise des fonctions sinus et cosinus de différentes fréquences. Pour chaque indiceLe "Indice" C’est un outil fondamental dans les livres et les documents, qui vous permet de localiser rapidement les informations souhaitées. Généralement, Il est présenté au début d’une œuvre et organise les contenus de manière hiérarchique, y compris les chapitres et les sections. Sa préparation correcte facilite la navigation et améliore la compréhension du matériau, ce qui en fait une ressource incontournable tant pour les étudiants que pour les professionnels dans divers domaines.... impair dans le vecteur d'entrée, créer un vecteur en utilisant la fonction cos, pour chaque indice pair, créer un vecteur en utilisant la fonction sin. Alors, ajouter ces vecteurs à leurs intégrations d'entrée correspondantes, qui donne au réseau des informations sur la position de chaque vecteur.
déf obtenir_angles(position, je, d_modèle):
   angle_rates = 1 / np.puissance(10000, (2 * (je//2)) / par exemple float32(d_modèle))
   revenir position * taux_angle

déf positional_encoding_1d(position, d_modèle):
   angle_rads = get_angles(np.arange(position)[:, par exemple, nouvel axe],
                           np.arange(d_modèle)[par exemple, nouvel axe, :],
                           d_modèle)

   angle_rads[:, 0::2] = np.sin(angle_rads[:, 0::2])
   angle_rads[:, 1::2] = par exemple cos(angle_rads[:, 1::2])
   pos_encoding = angle_rads[par exemple, nouvel axe, ...]
   revenir tf.cast(pos_encoding, dtype=tf.float32)

déf positional_encoding_2d(ligne,col,d_modèle):
   affirmer d_modèle % 2 == 0
   row_pos = np.repeat(np.arange(ligne),col)[:,par exemple, nouvel axe]
   col_pos = np.repeat(np.expand_dims(np.arange(col),0),ligne,axe=0).remodeler(-1,1)

   angle_rads_row = get_angles(ligne_pos,np.arange(d_modèle//2)[par exemple, nouvel axe,:],d_modèle//2)
   angle_rads_col = get_angles(col_pos,np.arange(d_modèle//2)[par exemple, nouvel axe,:],d_modèle//2)

   angle_rads_row[:, 0::2] = np.sin(angle_rads_row[:, 0::2])
   angle_rads_row[:, 1::2] = par exemple cos(angle_rads_row[:, 1::2])
   angle_rads_col[:, 0::2] = np.sin(angle_rads_col[:, 0::2])
   angle_rads_col[:, 1::2] = par exemple cos(angle_rads_col[:, 1::2])
   pos_encoding = np.concaténate([angle_rads_row,angle_rads_col],axe=1)[par exemple, nouvel axe, ...]
   revenir tf.cast(pos_encoding, dtype=tf.float32)
Paso 5: – Soins multi-têtes
Calculer les poids d'attention. q, k, v doit avoir des dimensions principales correspondantes. k, v doit avoir l'avant-dernière dimension correspondante, c'est-à-dire: seq_len_k = seq_len_v. Le masque a différentes formes selon son type (rembourré ou hâte) mais il doit être transmissible pour l'addition.
déf create_padding_mask(seq):
   seq = tf.cast(tf.math.equal(seq, 0), tf.float32)
   revenir seq[:, tf.newaxis, tf.newaxis, :]  # (taille du lot, 1, 1, seq_len)

déf create_look_ahead_mask(Taille):
   masque = 1 - tf.linalg.band_part(tf.ones((Taille, Taille)), -1, 0)
   revenir masque  # (seq_len, seq_len)

déf scaled_dot_product_attention(q, k, v, masque):
   matmul_qk = tf.matmul(q, k, transpose_b=Vrai)  # (..., seq_len_q, seq_len_k)
   dk = tf.cast(tf.forme(k)[-1], tf.float32)
   scaled_attention_logits = matmul_qk / tf.math.sqrt(dk)
.
   si le masque n'est pas Aucun:
      scaled_attention_logits += (masque * -1e9)

   attention_weights = tf.nn.softmax(scaled_attention_logits, axe=-1)
   sortie = tf.matmul(attention_poids, v)  # (..., seq_len_q, profondeur_v)

   revenir sortir, attention_poids

classer MultiHeadAttention(tf.dur.couches.Couche):
   déf __init__(soi, d_modèle, nombre_têtes):
      super(MultiHeadAttention, soi).__init__()
      soi.num_heads = num_heads
      soi.d_modèle = d_modèle
      affirmer d_modèle % soi.nombre_têtes == 0
      soi.profondeur = d_modèle // soi.nombre_têtes
      soi.wq = tf.keras.layers.Dense(d_modèle)
      soi.sem = tf.keras.layers.Dense(d_modèle)
      soi.wv = tf.keras.layers.Dense(d_modèle)
      soi.dense = tf.keras.layers.Dense(d_modèle)

   déf split_heads(soi, X, taille du lot):
      x = tf.reshape(X, (taille du lot, -1, soi.nombre_têtes, soi.profondeur))
      revenir tf.transposer(X, permanente=[0, 2, 1, 3])

   déf appel(soi, v, k, q, masque=Aucun):
      batch_size = tf.shape(q)[0]
      q = soi.qq(q)  # (taille du lot, seq_len, d_modèle)
      k = soi.semaine(k)  # (taille du lot, seq_len, d_modèle)
      v = soi.wv(v)  # (taille du lot, seq_len, d_modèle)

      q = soi.split_heads(q, taille du lot)  # (taille du lot, nombre_têtes, seq_len_q, profondeur)
      k = soi.split_heads(k, taille du lot)  # (taille du lot, nombre_têtes, seq_len_k, profondeur)
      v = soi.split_heads(v, taille du lot)  # (taille du lot, nombre_têtes, seq_len_v, profondeur)

      attention_échelle, attention_weights = scaled_dot_product_attention(q, k, v, masque)
      scaled_attention = tf.transpose(attention_échelle, permanente=[0, 2, 1, 3])  # (taille du lot, seq_len_q,      nombre_têtes, profondeur)

      concat_attention = tf.reshape(attention_échelle,
                                 (taille du lot, -1, soi.d_modèle))  # (taille du lot, seq_len_q, d_modèle)

      sortie = soi.dense(concat_attention)  # (taille du lot, seq_len_q, d_modèle)
      revenir sortir, attention_poids

déf point_wise_feed_forward_network(d_modèle, dff):
   revenir tf.keras.Séquentielle([
                tf.hard.layers.Dense(dff, activation='relu'),  # (taille du lot, seq_len, dff)
                tf.hard.layers.Dense(d_modèle)  # (taille du lot, seq_len, d_modèle)])
Paso 6: – Couche encodeur-décodeur
classer EncoderLayer(tf.dur.couches.Couche):
   déf __init__(soi, d_modèle, nombre_têtes, dff, taux=0.1):
      super(EncoderLayer, soi).__init__()
      soi.mha = MultiHeadAttention(d_modèle, nombre_têtes)
      soi.ffn = point_wise_feed_forward_network(d_modèle, dff)

      soi.layernorm1 = tf.hard.layers.LayerNormalisation(epsilon=1e-6)
      soi.layernorm2 = tf.hard.layers.LayerNormalisation(epsilon=1e-6)

      soi.dropout1 = tf.keras.layers.Dropout(taux)
      soi.dropout2 = tf.keras.layers.Dropout(taux)


   déf appel(soi, X, entraînement, masque=Aucun):
      attn_sortie, _ = soi.mha(X, X, X, masque)  # (taille du lot, input_seq_len, d_modèle)
      attn_output = soi.abandon1(attn_sortie, formation=formation)
      out1 = soi.couchenorm1(X + attn_sortie)  # (taille du lot, input_seq_len, d_modèle)

      ffn_sortie = soi.ffn(out1)  # (taille du lot, input_seq_len, d_modèle)
      ffn_sortie = soi.abandon2(ffn_sortie, formation=formation)
      out2 = soi.layerernorm2(out1 + ffn_sortie)  # (taille du lot, input_seq_len, d_modèle)
      revenir out2
classer DécodeurCouche(tf.dur.couches.Couche):
   déf __init__(soi, d_modèle, nombre_têtes, dff, taux=0.1):
      super(DécodeurCouche, soi).__init__()
      soi.mha1 = MultiHeadAttention(d_modèle, nombre_têtes)
      soi.mha2 = MultiHeadAttention(d_modèle, nombre_têtes)

      soi.ffn = point_wise_feed_forward_network(d_modèle, dff)

      soi.layernorm1 = tf.hard.layers.LayerNormalisation(epsilon=1e-6)
      soi.layernorm2 = tf.hard.layers.LayerNormalisation(epsilon=1e-6)
      soi.layernorm3 = tf.hard.layers.LayerNormalisation(epsilon=1e-6)

      soi.dropout1 = tf.keras.layers.Dropout(taux)
      soi.dropout2 = tf.keras.layers.Dropout(taux)
      soi.dropout3 = tf.keras.layers.Dropout(taux)

   déf appel(soi, X, enc_output, entraînement,look_ahead_mask=Aucun, padding_mask=Aucun):
      attn1, attn_weights_block1 = soi.mha1(X, X, X, look_ahead_mask)  # (taille du lot, cible_seq_len, d_modèle)
      attn1 = soi.abandon1(attn1, formation=formation)
      out1 = soi.couchenorm1(attn1 + X)

      attn2, attn_weights_block2 = soi.mha2(enc_output, enc_output, out1, padding_mask)
      attn2 = soi.abandon2(attn2, formation=formation)
      out2 = soi.layerernorm2(attn2 + out1)  # (taille du lot, cible_seq_len, d_modèle)

      ffn_sortie = soi.ffn(out2)  # (taille du lot, cible_seq_len, d_modèle)
      ffn_sortie = soi.abandon3(ffn_sortie, formation=formation)
      out3 = soi.layerernorm3(ffn_sortie + out2)  # (taille du lot, cible_seq_len, d_modèle)

      revenir out3, attn_weights_block1, attn_weights_block2
classer Encodeur(tf.dur.couches.Couche):
   déf __init__(soi, nombre_couches, d_modèle, nombre_têtes, dff, taille_ligne,taille_col,taux=0.1):
      super(Encodeur, soi).__init__()
      soi.d_modèle = d_modèle
      soi.nombre_couches = nombre_couches

      soi.intégration = tf.keras.layers.Dense(soi.d_modèle,activation='relu')
      soi.pos_encoding = positional_encoding_2d(taille_ligne,taille_col,soi.d_modèle)

      soi.enc_layers = [EncoderLayer(d_modèle, nombre_têtes, dff, taux) pour _ dans gamme(nombre_couches)]
      soi.dropout = tf.keras.layers.Dropout(taux)

   déf appel(soi, X, entraînement, masque=Aucun):
      seq_len = tf.forme(X)[1]
      x = soi.encastrement(X)  # (taille du lot, input_seq_len(H*W), d_modèle)
      x += soi.pos_encoding[:, :seq_len, :]
      x = soi.abandonner(X, formation=formation)

      pour je suis dans gamme(soi.nombre_couches):
         x = soi.enc_layers[je](X, entraînement, masque)

      revenir X  # (taille du lot, input_seq_len, d_modèle)
classer Décodeur(tf.dur.couches.Couche):
   déf __init__(soi, nombre_couches,d_modèle,nombre_têtes,dff, target_vocab_size, maximum_position_encoding,   taux=0.1):
      super(Décodeur, soi).__init__()
      soi.d_modèle = d_modèle
      soi.nombre_couches = nombre_couches

      soi.incorporation = tf.keras.layers.Embedding(target_vocab_size, d_modèle)
      soi.pos_encoding = positional_encoding_1d(maximum_position_encoding, d_modèle)

      soi.déc_couches = [DécodeurCouche(d_modèle, nombre_têtes, dff, taux)
                         pour _ dans gamme(nombre_couches)]
      soi.dropout = tf.keras.layers.Dropout(taux)

   déf appel(soi, X, enc_output, entraînement,look_ahead_mask=Rien, padding_mask=Rien):
      seq_len = tf.forme(X)[1]
      poids_attention = {}

      x = soi.encastrement(X)  # (taille du lot, cible_seq_len, d_modèle)
      x *= tf.math.sqrt(tf.cast(soi.d_modèle, tf.float32))
      x += soi.pos_encoding[:, :seq_len, :]
      x = soi.abandonner(X, formation=formation)

      pour je dans gamme(soi.nombre_couches):
         X, bloc1, bloc2 = soi.déc_couches[je](X, enc_output, entraînement,
                                            look_ahead_mask, padding_mask)

         attention_poids['couche_décodeur'{}_bloc1'.format(je+1)] = bloc1
         attention_poids['couche_décodeur'{}_bloc2'.format(je+1)] = bloc2

      revenir X, attention_poids
Paso 7: – Transformateur
classer Transformateur(tf.dur.Modèle):
   déf __init__(soi, nombre_couches, d_modèle, nombre_têtes, dff,taille_ligne,taille_col,
              target_vocab_size,max_pos_encoding, taux=0.1):
      super(Transformateur, soi).__init__()
      soi.encodeur = Encodeur(nombre_couches, d_modèle, nombre_têtes, dff,taille_ligne,taille_col, taux)
      soi.décodeur = décodeur(nombre_couches, d_modèle, nombre_têtes, dff,
                          target_vocab_size,max_pos_encoding, taux)
      soi.couche_finale = tf.keras.layers.Dense(target_vocab_size)

   déf appel(soi, entrée, le goudron, entraînement,look_ahead_mask=Rien,dec_padding_mask=Rien,enc_padding_mask=Rien   ):
      enc_output = soi.encodeur(entrée, entraînement, enc_padding_mask)  # (taille du lot, inp_seq_len, d_modèle      )
      dec_sortie, poids_attention = soi.décodeur(
      le goudron, enc_output, entraînement, look_ahead_mask, dec_padding_mask)
      sortie_finale = soi.couche_finale(dec_sortie)  # (taille du lot, tar_seq_len, target_vocab_size)
      revenir sortie_finale, attention_poids
Paso 8: – Modèle d'hyperparamètres
Définir les paramètres de l'entraînement:
num_couche = 4
d_modèle = 512
dff = 2048
nombre_têtes = 8
taille_ligne = 8
taille_col = 8
target_vocab_size = top_k + 1
dropout_rate = 0.1
classer ProgrammePersonnalisé(tf.dur.optimiseurs.des horaires.Calendrier d'apprentissage):
   déf __init__(soi, d_modèle, warmup_steps=4000):
      super(ProgrammePersonnalisé, soi).__init__()
      soi.d_modèle = d_modèle
      soi.d_model = tf.cast(soi.d_modèle, tf.float32)
      soi.warmup_steps = warmup_steps

   déf __appel__(soi, étape):
      arg1 = tf.math.rsqrt(étape)
      arg2 = étape * (soi.warmup_steps ** -1.5)
      revenir tf.math.rsqrt(soi.d_modèle) * tf.math.minimum(argument1, arg2)
learning_rate = CustomSchedule(d_modèle)
optimiseur = tf.hard.optimizers.Adam(taux d'apprentissage, bêta_1=0.9, beta_2=0.98,
                                    epsilon=1e-9)
loss_object = tf.keras.losses.SparseCategoricalCrossentropy(from_logits=Vrai, réduction='aucun')

déf loss_function(réel, pred):
   masque = tf.math.logical_not(tf.math.equal(réel, 0))
   loss_ = loss_object(réel, pred)
   masque = tf.cast(masque, dtype=loss_.dtype)
   perte_ *= masque
  revenir tf.reduce_sum(perte_)/tf.reduce_sum(masque)
train_loss = tf.keras.metrics.Mean(nom="train_loss")
train_accuracy = tf.keras.metrics.SparseCategoricalAccuracy(nom="train_précision")
transformateur = Transformateur(num_couche,d_modèle,nombre_têtes,dff,taille_ligne,taille_col,target_vocab_size,                                 max_pos_encoding=target_vocab_size,taux=taux_d'abandon)
Paso 9: – Formation de modèle
déf create_masks_decoder(le goudron):
   look_ahead_mask = create_look_ahead_mask(tf.forme(le goudron)[1])
   dec_target_padding_mask = create_padding_mask(le goudron)
   masque_combiné = tf.maximum(dec_target_padding_mask, look_ahead_mask)
   revenir masque_combiné
@tf.fonction
déf train_pas(img_tenseur, le goudron):
   tar_inp = goudron[:, :-1]
   tar_real = goudron[:, 1:]
   dec_mask = create_masks_decoder(tar_inp)
   avec tf.GradientTape() comme ruban:
      prédictions, _ = transformateur(img_tenseur, tar_inp,Vrai, dec_mask)
      perte = loss_function(tar_real, prédictions)

   gradients = tape.gradient(perte, transformer.trainable_variables)
   optimiseur.apply_gradients(Zip *: français(dégradés, transformer.trainable_variables))
   train_loss(perte)
   train_précision(tar_real, prédictions)
pour époque dans gamme(30):
   début = heure.heure()
   train_loss.reset_states()
   train_accuracy.reset_states()
   pour (grouper, (img_tenseur, le goudron)) dans énumérer(base de données):
      train_pas(img_tenseur, le goudron)
      si grouper % 50 == 0:
         imprimer ('Epoch {} Grouper {} Perte {:.4F} Précision {:.4F}'.format(
         époque + 1, grouper, train_loss.result(), train_accuracy.result()))

   imprimer ('Epoch {} Perte {:.4F} Précision {:.4F}'.format(époque + 1,
                                               train_loss.result(),
                                               train_accuracy.result()))
   imprimer ('Temps pris pour 1 époque: {} secondes.format(temps temps() - début))
Paso 10: – Évaluation de l'UEBL
déf évaluer(image):
   temp_input = tf.expand_dims(load_image(image)[0], 0)
   img_tensor_val = image_features_extract_model(entrée_temp)
   img_tensor_val = tf.reshape(img_tenseur_val, (img_tensor_val.shape[0], -1, img_tensor_val.shape[3]))
   start_token = tokenizer.word_index['<début>']
   end_token = tokenizer.word_index['<finir>']
   decoder_input = [start_token]
   sortie = tf.expand_dims(decoder_input, 0) #jetons
   résultat = [] #liste de mots

   Fou je dans gamme(100):
      dec_mask = create_masks_decoder(sortir)
      prédictions, attention_weights = transformateur(img_tenseur_val,sortir,Faux,dec_mask)
      prédictions = prédictions[: ,-1:, :]  # (taille du lot, 1, vocab_size)
      id_prédit = tf.cast(tf.argmax(prédictions, axe=-1), tf.int32)
      si predicted_id == end_token:
         revenir résultat,tf.squeeze(sortir, axe=0), attention_poids
      result.append(tokenizer.index_word[entier(id_prédit)])
      sortie = tf.concat([sortir, id_prédit], axe=-1)

   revenir résultat,tf.squeeze(sortir, axe=0), attention_poids
rid = np.random.randint(0, longueur(img_name_val))
image = img_name_val[débarrasser]
légende_réelle = ' '.rejoindre([tokenizer.index_word[je] pour je dans cap_val[débarrasser] si je ne pas dans [0]])
légende,résultat,attention_weights = évaluer(image)

first = real_caption.split(' ', 1)[1]
real_caption = first.rsplit(' ', 1)[0]

pour je dans légende:
   si je=="<unk>":
      légende.supprimer(je)

pour je dans légende_réelle:
   si je=="<unk>":
      real_caption.remove(je)

result_join = ' '.rejoindre(légende)
result_final = result_join.rsplit(' ', 1)[0]
real_appn = []
real_appn.append(real_caption.split())
référence = real_appn
candidat = légende

score = sentence_bleu(référence, candidat, poids=(1.0,0,0,0))
imprimer(F"BLEU-1 score: {note*100}")
score = sentence_bleu(référence, candidat, poids=(0.5,0.5,0,0))
imprimer(F"BLEU-2 score: {note*100}")
score = sentence_bleu(référence, candidat, poids=(0.3,0.3,0.3,0))
imprimer(F"BLEU-3 score: {note*100}")
score = sentence_bleu(référence, candidat, poids=(0.25,0.25,0.25,0.25))
imprimer(F"BLEU-4 score: {note*100}")
imprimer ('Légende réelle':', légende_réelle)
imprimer ('Légende prédite':', ' '.rejoindre(légende))
image_temp = np.array(Image.ouvert(image))
plt.imshow(image_temp)
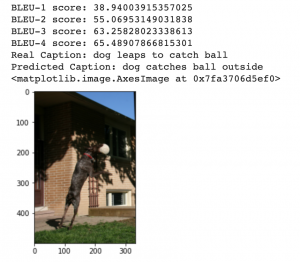
Production:
rid = np.random.randint(0, longueur(img_name_val))
image = img_name_val[débarrasser]
légende_réelle = ' '.rejoindre([tokenizer.index_word[je] pour je dans cap_val[débarrasser] si je ne pas dans [0]])
légende,résultat,attention_weights = évaluer(image)

first = real_caption.split(' ', 1)[1]
real_caption = first.rsplit(' ', 1)[0]

pour je dans légende:
   si je=="<unk>":
      légende.supprimer(je)

pour je dans légende_réelle:
   si je=="<unk>":
      real_caption.remove(je)

result_join = ' '.rejoindre(légende)
result_final = result_join.rsplit(' ', 1)[0]
real_appn = []
real_appn.append(real_caption.split())
référence = real_appn
candidat = légende

score = sentence_bleu(référence, candidat, poids=(1.0,0,0,0))
imprimer(F"BLEU-1 score: {note*100}")
score = sentence_bleu(référence, candidat, poids=(0.5,0.5,0,0))
imprimer(F"BLEU-2 score: {note*100}")
score = sentence_bleu(référence, candidat, poids=(0.3,0.3,0.3,0))
imprimer(F"BLEU-3 score: {note*100}")
score = sentence_bleu(référence, candidat, poids=(0.25,0.25,0.25,0.25))
imprimer(F"BLEU-4 score: {note*100}")
imprimer ('Légende réelle':', légende_réelle)
imprimer ('Légende prédite':', ' '.rejoindre(légende))
image_temp = np.array(Image.ouvert(image))
plt.imshow(image_temp)
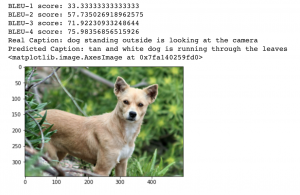
Production:
Paso 11: – Comparaison
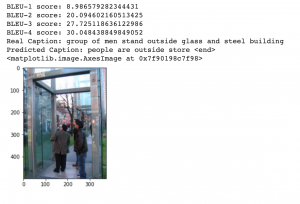
Comparons les scores BLEU obtenus dans l'article précédent en utilisant l'attention de Bahdanau par rapport à nos transformateurs.
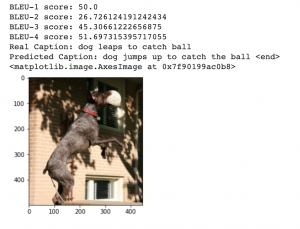
Les scores BLEU à gauche utilisent l'attention de Bahdanau et les scores BLEU à droite utilisent les transformateurs. Comme nous pouvons le voir, Transformer fonctionne bien mieux qu'un simple modèle de soins.
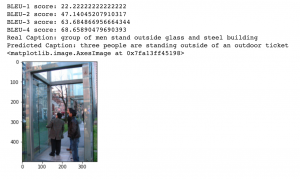
Et voilà! Nous avons implémenté avec succès Transformers à l'aide de Tensorflow et avons vu comment il peut produire des résultats de pointe..
Remarques finales
En résumé, Les transformateurs sont meilleurs que toutes les autres architectures que nous avons vues auparavant car ils évitent totalement la récursivité, en traitant les phrases dans leur ensemble et en apprenant les relations entre les mots grâce à des mécanismes d'attention multicéphale et des plongements positionnels. Il convient également de noter que les transformateurs utilisant Tensorflow ne peuvent capturer les dépendances que dans la taille d'entrée fixe utilisée pour les entraîner.
Il existe de nombreux transformateurs nouveaux et puissants comme Transformer-XL, Transformateur enchevêtré, Transformateur de mémoire maillé qui peut également être mis en œuvre pour des applications telles que les légendes d'images afin d'obtenir des résultats encore meilleurs.
Trouvez-vous utile cet article? Partagez vos précieux commentaires dans la section des commentaires ci-dessous.. N'hésitez pas à partager vos livres de codes complets également, qui sera utile aux membres de notre communauté.





