
Cet article a été publié dans le cadre du Blogathon sur la science des données.
introduction
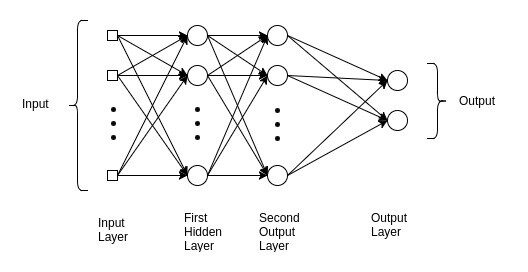
Comprendre ce réseau nous aide à obtenir des informations sur les raisons sous-jacentes dans les modèles avancés de Deep Learning. Le perceptron multicouche est couramment utilisé pour les problèmes de régression simple. Cependant, Les MLP ne sont pas idéaux pour traiter des motifs avec des données séquentielles et multidimensionnelles.
🙄 Un perceptron multicouche s'efforce de mémoriser les motifs dans les données séquentielles, à cause de, il nécessite une “grande” quantité de paramètresLes "paramètres" sont des variables ou des critères qui sont utilisés pour définir, mesurer ou évaluer un phénomène ou un système. Dans divers domaines tels que les statistiques, Informatique et recherche scientifique, Les paramètres sont essentiels à l’établissement de normes et de standards qui guident l’analyse et l’interprétation des données. Leur sélection et leur manipulation correctes sont cruciales pour obtenir des résultats précis et pertinents dans toute étude ou projet.... pour traiter des données multidimensionnelles.
MLP, CNN et RNN ne font pas tout …
Une grande partie de leur succès provient de l'identification de leur objectif et du bon choix de certains paramètres, Quoi Fonction de perte, Optimiseur, Oui Régularisateur.
Nous disposons également de données externes à l'environnement de formation. Le rôle du régularisateur est de garantir que le modèle entraîné se généralise à de nouvelles données.
Ensemble de données MNIST
Supposons que notre objectif soit de créer un réseau pour identifier les nombres basés sur les chiffres manuscrits. Par exemple, lorsque l'entrée du réseau est une image d'un chiffre 8, la prévision correspondante doit également être 8.
🤷🏻♂️ Este es un trabajo básico de clasificación con redes neuronales.
Antes de analizar el modelo MLP, es esencial comprender el conjunto de datos del MNIST. Se utiliza para explicar y validar muchas teorías de l'apprentissage en profondeurL'apprentissage en profondeur, Une sous-discipline de l’intelligence artificielle, s’appuie sur des réseaux de neurones artificiels pour analyser et traiter de grands volumes de données. Cette technique permet aux machines d’apprendre des motifs et d’effectuer des tâches complexes, comme la reconnaissance vocale et la vision par ordinateur. Sa capacité à s’améliorer continuellement au fur et à mesure que de nouvelles données lui sont fournies en fait un outil clé dans diverses industries, de la santé... porque las 70.000 imágenes que contiene son pequeñas pero suficientemente ricas en información;
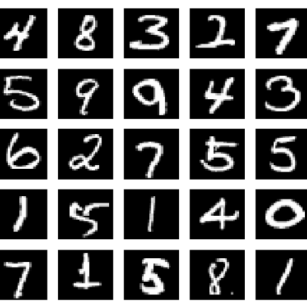
MNIST es una colección de dígitos que van del 0 Al 9. Tiene un conjunto de entraînementLa formation est un processus systématique conçu pour améliorer les compétences, connaissances ou aptitudes physiques. Il est appliqué dans divers domaines, Comme le sport, Éducation et développement professionnel. Un programme d’entraînement efficace comprend la planification des objectifs, Pratique régulière et évaluation des progrès. L’adaptation aux besoins individuels et la motivation sont des facteurs clés pour obtenir des résultats réussis et durables dans toutes les disciplines.... de 60.000 imágenes y 10.000 pruebas clasificadas en categorías.
Usar el conjunto de datos MNIST en TensorFlow es simple.
importer numpy comme par exemple
de tensorflow.keras.datasets importer mnist
(x_train, y_train), (x_test, y_test) = mnist.load_data()
Les mnist.load_data () El método es conveniente, ya que no es necesario cargar las 70.000 imágenes y sus etiquetas.
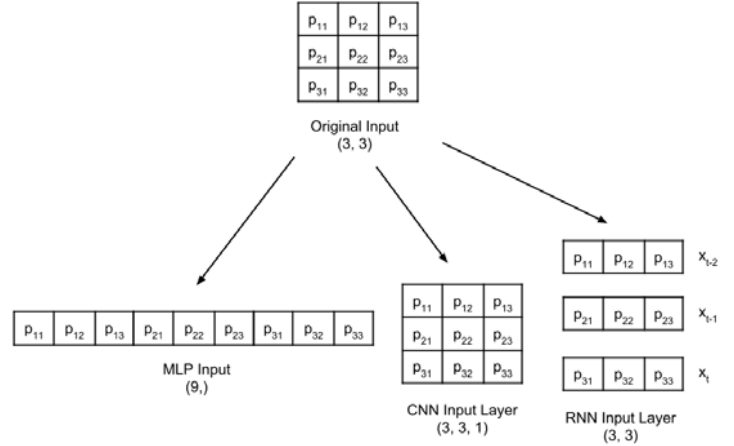
Antes de entrar en el clasificador de Perceptrón Multicapa, es fundamental tener en cuenta que, si bien los datos del MNIST constan de tensores bidimensionales, se deben remodelar, según el tipo de couche d'entréeLa "couche d'entrée" fait référence au niveau initial d’un processus d’analyse de données ou d’architectures de réseaux de neurones. Sa fonction principale est de recevoir et de traiter l’information brute avant qu’elle ne soit transformée par les couches suivantes. Dans le contexte de l’apprentissage automatique, Une bonne configuration de la couche d’entrée est cruciale pour garantir l’efficacité du modèle et optimiser ses performances dans des tâches spécifiques.....
Se cambia la forma de una imagen en escala de grises de 3 × 3 para las capas de entrada MLP, CNN y RNN:
Las etiquetas tienen forma de dígitos, du 0 Al 9.
num_labels = len(np.unique(y_train))
imprimer("total de labels:t{}".format(nombre_étiquettes))
imprimer("Étiquettes:ttt{0}".format(np.unique(y_train)))
⚠️ Esta representación no es adecuada para la capa de pronóstico que genera probabilidad por clase. El formato más adecuado es one-hot, un vector de 10 dimensiones como todos los valores 0, excepto el indiceLe "Indice" C’est un outil fondamental dans les livres et les documents, qui vous permet de localiser rapidement les informations souhaitées. Généralement, Il est présenté au début d’une œuvre et organise les contenus de manière hiérarchique, y compris les chapitres et les sections. Sa préparation correcte facilite la navigation et améliore la compréhension du matériau, ce qui en fait une ressource incontournable tant pour les étudiants que pour les professionnels dans divers domaines.... de clase. Par exemple, si la etiqueta es 4, el vector equivalente es [0,0,0,0, 1, 0,0,0,0,0].
Apprentissage en profondeur, los datos se almacenan en un tenseurLes tenseurs sont des structures mathématiques qui généralisent des concepts comme les scalaires et les vecteurs. Ils sont utilisés dans diverses disciplines, y compris la physique, le génie et l'apprentissage automatique, pour représenter des données multidimensionnelles. Un tenseur peut être visualisé comme une matrice à plusieurs dimensions, ce qui permet de modéliser des relations complexes entre différentes variables. Leur polyvalence et leur capacité à gérer de grands volumes d'informations en font des outils fondamentaux dans l'analyse et le traitement des données..... El término tensor se aplica a un tensor escalar (tensor 0D), vector (tensor 1D), quartier général (tensor bidimensional) Oui tensor multidimensionalLes tenseurs multidimensionnels sont des structures mathématiques qui généralisent la notion d'échelles, vecteurs et matrices à des dimensions supérieures. Ils sont largement utilisés dans des domaines tels que la physique, l'ingénierie et l'apprentissage automatique, permettant de représenter et de manipuler des données complexes de manière efficace. Leur capacité à stocker des informations sur plusieurs dimensions facilite l'analyse et la modélisation de phénomènes réels, contribuyendo a avances en diversas disciplinas científicas y tecnológicas.....
#converter em one-hot
from tensorflow.keras.utils import to_categorical
y_train = to_categorical(y_train)
y_test = to_categorical(y_test)
Nuestro modelo es un MLP, por lo que sus entradas deben ser un tensor 1D. En tant que tel, x_train y x_test deben transformarse en [60,000, 2828] Oui [10,000, 2828],
En sume, el tamaño de -1 significa permitir que la biblioteca calcule la dimensión correcta. En el caso de x_train, il est 60.000.
image_size = x_train.shape[1]
input_size = image_size * image_size

print("x_train:t{}".format(x_train.shape))
imprimer("x_test:tt{}m".format(x_test.shape))

x_train = np.reshape(x_train, [-1, taille_entrée])
x_train = x_train.astype('float32') / 255

x_test = np.reshape(x_test, [-1, taille_entrée])
x_test = x_test.astype('float32') / 255

imprimer("x_train:t{}".format(x_train.shape))
imprimer("x_test:tt{}".format(x_test.shape))
OUTPUT:
x_train:	(60000, 28, 28)
x_test:		(10000, 28, 28)

x_train:	(60000, 784)
x_test:		(10000, 784)
Construire le modèle
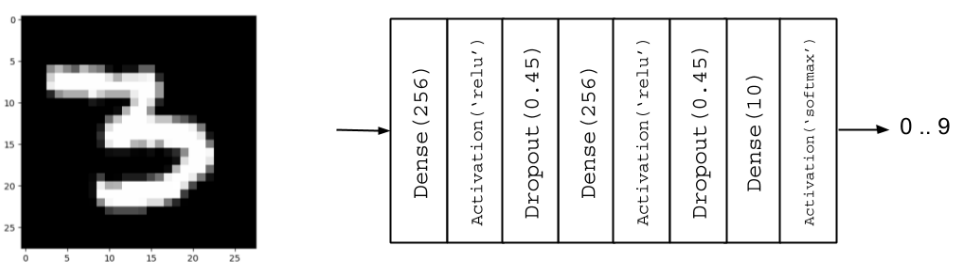
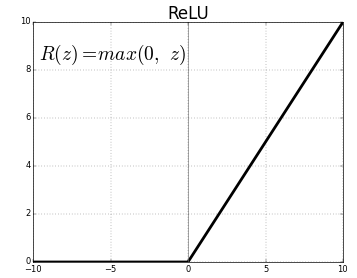
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Dense, Activation, Abandonner

# Parameters
batch_size = 128 # It is the sample size of inputs to be processed at each training stage.
hidden_units = 256
abandon = 0.45

# Nossa  MLP com ReLU e Dropout
model = Sequential()

model.ajouter(Dense(hidden_units, input_dim=input_size))
model.ajouter(Activation('relu'))
model.ajouter(Abandonner(abandonner))

model.ajouter(Dense(hidden_units))
model.ajouter(Activation('relu'))
model.ajouter(Abandonner(abandonner))

model.ajouter(Dense(nombre_étiquettes))
Régularisation
Una red neuronal tiende a memorizar sus datos de entrenamiento, especialmente si contiene capacidad más que suficiente. Dans ce cas, la red falla catastróficamente cuando se somete a los datos de prueba.
Este es el caso clásico en el que la red no logra generalizar (SurapprentissageLe surapprentissage, ou overfitting, est un phénomène en apprentissage automatique où un modèle s'ajuste trop aux données d'entraînement, capturant le bruit et les motifs non pertinents. Cela entraîne une performance médiocre sur des données non vues, car le modèle perd sa capacité de généralisation. Pour atténuer le surapprentissage, des techniques telles que la régularisation, la validation croisée et la réduction de la complexité du modèle peuvent être employées.... / Sous-apprentissageLe sous-apprentissage est un problème courant en apprentissage automatique qui se produit lorsqu'un modèle est trop simple pour capturer la complexité des données. Cela se traduit par des performances médiocres à la fois sur le jeu d'entraînement et sur le jeu de test. Les causes du sous-apprentissage peuvent inclure un modèle inapproprié, des caractéristiques non pertinentes ou des données insuffisantes. Afin de le résoudre, on peut choisir des modèles plus complexes ou améliorer la qualité....). Pour éviter cette tendance, le modèle utilise une couche régulatrice. Laisser.
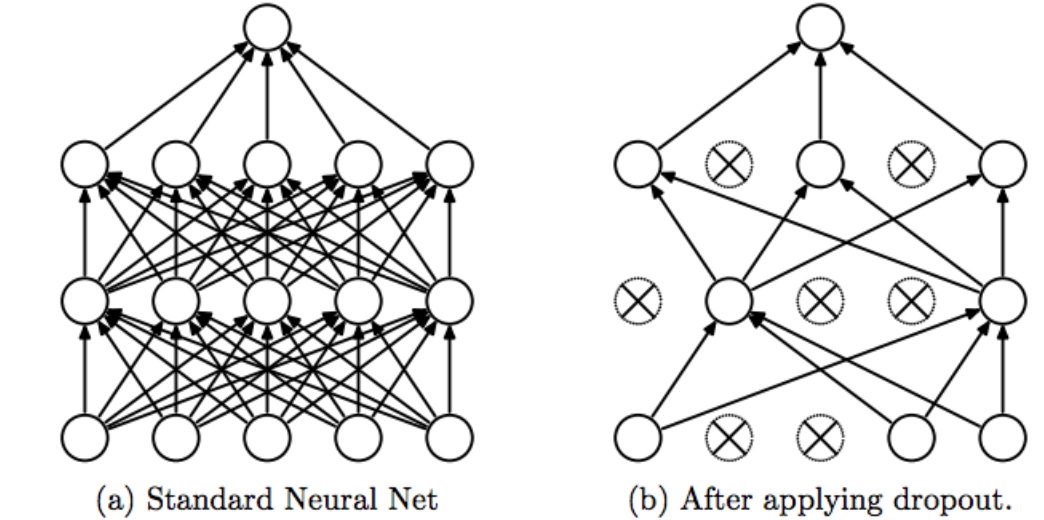
L'idée du Dropout est simple. Étant donné un taux d'abandon (dans notre modèle, nous fixons = 0,45), la couche supprime aléatoirement cette fraction d'unités.
Par exemple, si la première couche a 256 unités, après l'application du dropout (0.45), solo (1 – 0.45) * 255 = 140 des unités participeront à la couche suivante
Le dropout rend les réseaux neuronaux plus robustes face aux données d'entrée imprévues, parce que le réseau est entraîné pour prédire correctement, même si certaines unités sont absentes.
⚠️ Le dropout intervient uniquement « jouer » 🤷🏻♂️ pendant l'entraînement.
Activation
La Couche de sortieLa "Couche de sortie" est un concept utilisé dans le domaine des technologies de l’information et de la conception de systèmes. Il s’agit de la dernière couche d’un modèle logiciel ou d’une architecture qui est chargée de présenter les résultats à l’utilisateur final. Cette couche est cruciale pour l’expérience utilisateur, puisqu’il permet une interaction directe avec le système et la visualisation des données traitées.... possède 10 unités, suivies d'une fonction d'activation softmax. Le 10 les unités correspondent aux 10 étiquettes possibles, classes ou catégories.
L'activation softmax peut être exprimée mathématiquement, selon l'équation suivante:
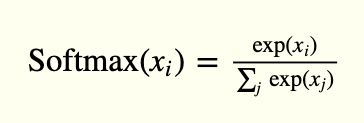
model.ajouter(Activation('softmax'))
modèle.résumé()
OUTPUT:
Modèle: "séquentiel"
_________________________________________________________________
Couche (taper)                 Paramètre de forme de sortie #
=================================================================
dense (Dense)                (Rien, 256)               200960
_________________________________________________________________
activation (Activation)      (Rien, 256)               0
_________________________________________________________________
dropout (Abandonner)            (Rien, 256)               0
_________________________________________________________________
dense_1 (Dense)              (Rien, 256)               65792
_________________________________________________________________
activation_1 (Activation)    (Rien, 256)               0
_________________________________________________________________
abandon_1 (Abandonner)          (Rien, 256)               0
_________________________________________________________________
dense_2 (Dense)              (Rien, 10)                2570
_________________________________________________________________
activation_2 (Activation)    (Rien, 10)                0
================================================== ================
Paramètres totaux: 269,322
Paramètres entraînables: 269,322
Paramètres non entraînables: 0
_________________________________________________________________
Visualización de modelos
Amélioration
El propósito de la Optimización es minimizar la función de pérdida. La idea es que si la pérdida se reduce a un nivel aceptable, el modelo aprendió indirectamente la función que asigna las entradas a las salidas. Las métricas de rendimiento se utilizan para determinar si su modelo ha aprendido.
modèle.compile(perte ="catégorique_crossentropie", optimiseur="Adam", métriques=['précision'])
-
- Categorical_crossentropy, se utiliza para one-hot
- La precisión es una buena métrica para las tareas de clasificación.
- Adam es un Algorithme d’optimisationUn algorithme d’optimisation est un ensemble de règles et de procédures conçues pour trouver la meilleure solution à un problème spécifique, Optimisation ou réduction d’une fonction cible. Ces algorithmes sont fondamentaux dans divers domaines, comme l’ingénierie, L’économie et l’intelligence artificielle, où elle cherche à améliorer l’efficacité et à réduire les coûts. Les approches sont multiples, y compris les algorithmes génétiques, Programmation linéaire et méthodes d’optimisation combinatoire.... que se puede utilizar en lugar del procedimiento clásico de descenso de penteLe gradient est un terme utilisé dans divers domaines, comme les mathématiques et l’informatique, pour décrire une variation continue de valeurs. En mathématiques, fait référence au taux de variation d’une fonction, pendant la conception graphique, S’applique à la transition de couleur. Ce concept est essentiel pour comprendre des phénomènes tels que l’optimisation dans les algorithmes et la représentation visuelle des données, permettant une meilleure interprétation et analyse dans... stochastique
📌 Dado nuestro conjunto de entrenamiento, la elección de la Fonction de perteLa fonction de perte est un outil fondamental de l’apprentissage automatique qui quantifie l’écart entre les prédictions du modèle et les valeurs réelles. Son but est de guider le processus de formation en minimisant cette différence, permettant ainsi au modèle d’apprendre plus efficacement. Il existe différents types de fonctions de perte, tels que l’erreur quadratique moyenne et l’entropie croisée, chacun adapté à différentes tâches et..., el optimizador y el regularizador, podemos comenzar a entrenar nuestro modelo.
model.fit(x_train, y_train, époques=20, batch_size=bat_size)
OUTPUT:
Époque 1/20
469/469 [===============================] - 1s 3ms/step - perte: 0.4230 - précision: 0.8690
....
Époque 20/20
469/469 [===============================] - 2s 4ms/pas - perte: 0.0515 - précision: 0.9835
Évaluation
En ce point, nuestro modelo de clasificador de dígitos MNIST está completo. Su evaluación de desempeño será el siguiente paso para determinar si el modelo entrenado presentará una solución subóptima
_, acc = model.evaluate(x_test,
                        y_test,
                        batch_size=bat_size,
                        verbeux=0)
imprimer("nAccuracy: %.1f%%n" % (100.0 * acc))
OUTPUT:
Précision: 98.4%
continuará…





