
introduction
Très souvent, nous utilisons indifféremment la vérification des données et la validation des données lorsqu'il s'agit de la qualité des données. Cependant, ces deux termes sont différents. Dans cet article, nous comprendrons la différence 4 différents contextes:
- Dictionnaire de signification de vérification et de validation
- Différence entre la vérification des données et la validation des données en général
- Différence entre vérification et validation du point de vue du développement logiciel
- Différence entre la vérification des données et la validation des données du point de vue de l'apprentissage automatique
1) Dictionnaire de signification de vérification et de validation
À bord 1 explique le sens du dictionnaire des mots vérification et validation avec quelques exemples.
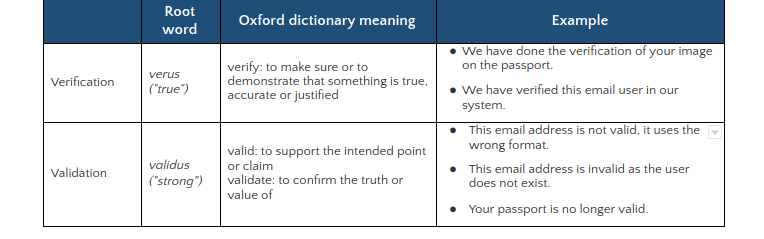
En résumé, la vérification concerne la véracité et la précision, considérant que la validation consiste à soutenir le bien-fondé d'un point de vue ou l'exactitude d'une affirmation. La validation vérifie l'exactitude d'une méthodologie, tandis que la vérification vérifie l'exactitude des résultats.
2) Différence entre la vérification des données et la validation des données en général
Maintenant que nous comprenons le sens littéral des deux mots, explorons la différence entre « verification des données » Oui « la validation des données ».
Verification des données: pour s'assurer que les données sont exactes.
La validation des données: pour s'assurer que les données sont correctes.
Développons avec des exemples dans le tableau 2.
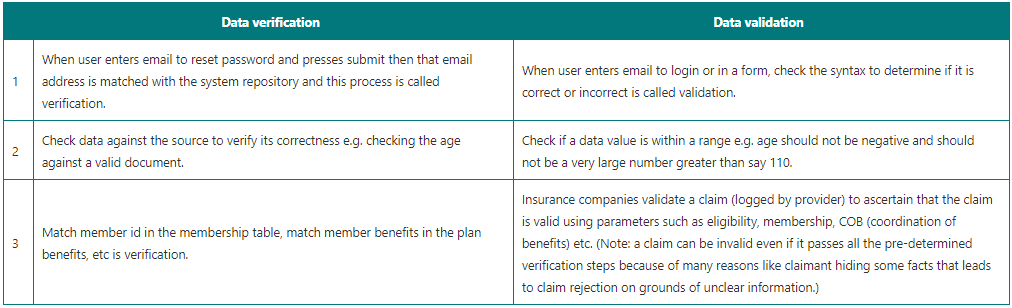
Tableau 2: « Verification des données » Oui « la validation des données » exemples
3) Différence entre vérification et validation du point de vue du développement logiciel
Du point de vue du développement logiciel,
- La vérification est effectuée pour s'assurer que le logiciel est de haute qualité, bien conçu, robuste et sans erreurs sans entrer dans sa facilité d'utilisation.
- La validation est effectuée pour assurer la convivialité et la capacité du logiciel à répondre aux besoins des clients.
Comme indiqué dans le Chiffre"Chiffre" est un terme utilisé dans divers contextes, De l’art à l’anatomie. Dans le domaine artistique, fait référence à la représentation de formes humaines ou animales dans des sculptures et des peintures. En anatomie, désigne la forme et la structure du corps. En outre, en mathématiques, "chiffre" Il est lié aux formes géométriques. Sa polyvalence en fait un concept fondamental dans de multiples disciplines.... 1, preuve de rectification, analyse de robustesse, tests unitaires, les tests d'intégration et autres sont tous Chèque Étapes où les tâches sont orientées pour vérifier les détails. La sortie du logiciel est vérifiée avec la sortie souhaitée. D'un autre côté, inspection de modèle, les tests de boîte noire et les tests d'utilisabilité sont tous validation Étapes où les tâches sont orientées pour comprendre si le logiciel répond aux exigences et aux attentes.
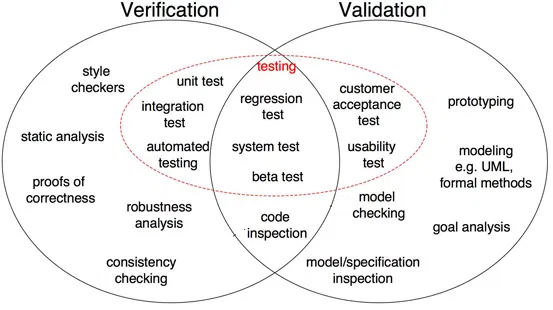
Figure 1: Différences entre vérification et validation dans le développement de logiciels
4) Différence entre la vérification des données et la validation des données du point de vue de l'apprentissage automatique
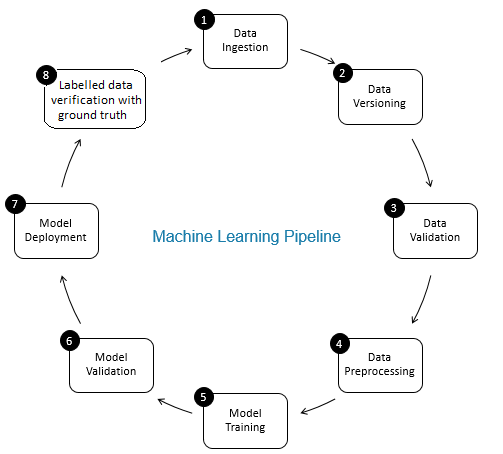
Le papier de verification des données dans le processus d'apprentissage automatique, c'est celui d'un gardien. Ce garantit des données exactes et à jour au fil du temps. La vérification des données se fait principalement dans la nouvelle étape d'acquisition des données, c'est-à-dire, au pas 8 du pipeline de ML, comme le montre la figure. 2. Des exemples de cette étape sont l'identification des enregistrements en double et l'exécution de la déduplication, et nettoyez les divergences dans les informations client dans des champs tels que l'adresse ou le numéro de téléphone.
D'autre part, la validation des données (au pas 3 du pipeline de ML) garantit que les données incrémentielles de l'étape 8 ajoutées aux données d'apprentissage sont de bonne qualité et similaires (du point de vue des propriétés statistiques) aux données de entraînementLa formation est un processus systématique conçu pour améliorer les compétences, connaissances ou aptitudes physiques. Il est appliqué dans divers domaines, Comme le sport, Éducation et développement professionnel. Un programme d’entraînement efficace comprend la planification des objectifs, Pratique régulière et évaluation des progrès. L’adaptation aux besoins individuels et la motivation sont des facteurs clés pour obtenir des résultats réussis et durables dans toutes les disciplines.... existantes. Par exemple, Ceci comprend trouver des anomalies dans les données te détecter différences entre les données d'entraînement existantes et les nouvelles données à ajouter aux données d'entraînement. Au contraire, tout problème de qualité des données / les différences statistiques dans les données incrémentielles peuvent être perdues et la formation les erreurs peuvent s'accumuler avec le temps Oui détériorer la précision du modèle. Pourtant, la validation des données détecte des changements importants (Oui il y en a) dans les données d'entraînement incrémentielles à un stade précoce qui aide à l'analyse des causes profondes.
Auteurs:
1. Aditya Agarwal: Aditya Aggarwal est la science des données – Chef de pratique chez Abzooba Inc. Plus que 12 années d'expérience dans la réalisation d'objectifs commerciaux grâce à des solutions basées sur les données, Aditya est spécialisé dans l'analyse prédictive, apprentissage automatique, intelligence d'affaires et stratégie d'entreprise. dans une variété d'industries. En tant que responsable des pratiques analytiques avancées chez Abzooba, Aditya dirige une équipe de plus de 50 Professionnels de la science des données énergétiques chez Abzooba qui résolvent des problèmes commerciaux intéressants à l'aide de l'apprentissage automatique, les l'apprentissage en profondeurL'apprentissage en profondeur, Une sous-discipline de l’intelligence artificielle, s’appuie sur des réseaux de neurones artificiels pour analyser et traiter de grands volumes de données. Cette technique permet aux machines d’apprendre des motifs et d’effectuer des tâches complexes, comme la reconnaissance vocale et la vision par ordinateur. Sa capacité à s’améliorer continuellement au fur et à mesure que de nouvelles données lui sont fournies en fait un outil clé dans diverses industries, de la santé..., traitement du langage naturel et vision par ordinateur. Fournit un leadership éclairé en matière d'IA aux clients pour traduire leurs objectifs commerciaux en problèmes analytiques et en solutions basées sur les données. Sous sa direction, diverses organisations ont automatisé des tâches de routine, ont réduit les coûts d'exploitation, augmentation de la productivité de l'équipe et amélioration des revenus supérieurs et inférieurs. Vous avez créé des solutions comme le moteur de maternité de substitution, le moteur de recommandation de prix, maintenance prédictive des capteurs IoT et plus. Aditya est titulaire d'un baccalauréat en technologie et d'un baccalauréat en administration des affaires de l'Indian Institute of Technology. (ITI), Delhi.
2. Dr. Lapin Bose: Le médecin. Arnab Bose est directeur scientifique d'Abzooba, une société d'analyse de données, et professeur adjoint à l'Université de Chicago, où il enseigne l'apprentissage automatique et l'analyse prédictive, opérations d'apprentissage automatique, analyse des séries chronologiques et prévisions ainsi que l'analyse de la santé dans le programme de Master en Sciences en AnalytiqueL’analytique fait référence au processus de collecte, Mesurer et analyser les données pour obtenir des informations précieuses qui facilitent la prise de décision. Dans divers domaines, Comme les affaires, Santé et sport, L’analytique peut identifier des modèles et des tendances, Optimiser les processus et améliorer les résultats. L’utilisation d’outils et de techniques statistiques de pointe est essentielle pour transformer les données en connaissances applicables et stratégiques..... Il est un vétéran de l'industrie de l'analyse prédictive de 20 années de plaisir à utiliser des données structurées et non structurées pour prédire et influencer les résultats comportementaux dans les soins de santé, vendre au détail, finances et transports. Ses domaines d'intérêt actuels comprennent la stratification des risques pour la santé et la gestion des maladies chroniques à l'aide de l'apprentissage automatique., et déploiement en production et suivi des modèles d'apprentissage automatique. Arnab a publié des chapitres de livres et des articles arbitrés dans de nombreuses conférences et magazines de l'Institute of Electrical and Electronic Engineers. (IEEE). Il a reçu la meilleure présentation à l'American Control Conference et a donné des conférences sur l'analyse de données dans des universités et des entreprises d'EE.. UU., Australie et Inde. Arnab a une maîtrise et un doctorat. diplômes en génie électrique de l'Université de Californie du Sud, et un B.Tech. en génie électrique de l'Institut indien de technologie de Kharagpur, Inde.
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





