
introduction
Le temps est le facteur le plus critique pour décider si une entreprise va monter ou descendre. C'est pourquoi nous voyons les ventes en magasin et les plateformes de commerce électronique s'aligner sur les festivals.. Ces entreprises analysent des années de données sur les dépenses pour comprendre le meilleur moment pour ouvrir des portes et constater une augmentation des dépenses de consommation..
Mais, Comment peux-tu, en tant que data scientist, effectuer cette analyse? Ne t'inquiète pas, vous n'avez pas besoin de construire une machine à remonter le temps! La modélisation des séries chronologiques est une technique puissante qui sert de passerelle pour comprendre et prévoir les tendances et les modèles..
Mais même un modèle de Séries chronologiquesUne série chronologique est un ensemble de données collectées ou mesurées à des moments successifs, généralement à intervalles réguliers. Ce type d’analyse vous permet d’identifier des modèles, Tendances et cycles des données au fil du temps. Son application est large, couvrant des domaines tels que l’économie, Météorologie et santé publique, faciliter la prédiction et la prise de décision sur la base d’informations historiques.... a différentes facettes. La plupart des exemples que nous voyons sur le Web traitent de séries temporelles univariées. Malheureusement, les cas d'utilisation du monde réel ne fonctionnent pas comme ça. Il y a plusieurs variables en jeu, et les gérer tous en même temps est l'endroit où un scientifique des données gagnera son courage.
Dans cet article, nous comprendrons ce qu'est une série temporelle multivariée et comment la traiter. Nous prendrons également une étude de cas et l'implémenterons en Python pour vous donner une compréhension pratique du sujet..
Table des matières
- Séries chronologiques univariées ou multivariées
- Séries temporelles univariées
- Séries temporelles multivariées
- Gestion d'une série temporelle multivariée: régression automatique vectorielle (OÙ)
- Pourquoi avons-nous besoin de VAR?
- Stationnarité dans une série temporelle multivariée
- Division validation des trains
- Implémentation Python
1. Séries chronologiques univariées ou multivariées
Cet article suppose une certaine familiarité avec les séries chronologiques univariées, ses propriétés et les différentes techniques utilisées pour la prédiction. Étant donné que cet article se concentrera sur les séries chronologiques multivariées, Je vous suggère de consulter les articles suivants qui constituent une bonne introduction aux séries temporelles univariées:
Mais je vais vous donner un bref aperçu de ce qu'est une série temporelle univariée., avant d'entrer dans les détails d'une série temporelle multivariée. Regardons-les un par un pour comprendre la différence.
1.1 Séries temporelles univariées
Une série temporelle univariée, comme son nom l'indique, c'est une série avec une seule variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... dépendant du temps.
Par exemple, jetez un œil à l'exemple de jeu de données ci-dessous composé des valeurs de température (chaque heure), au cours du dernier 2 ans. Ici, la température est la variable dépendante (dépendant du temps).
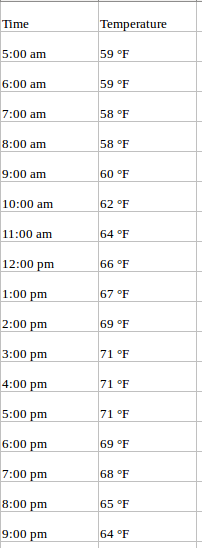
Si on nous demande de prévoir la température pour les prochains jours, nous allons regarder les valeurs passées et essayer de mesurer et d'extraire un motif. On remarquerait que la température est plus basse le matin et la nuit, alors qu'il culmine dans l'après-midi. En outre, si vous avez des données des dernières années, vous remarquerez qu'il fait plus froid pendant les mois de novembre à janvier, alors qu'il fait relativement plus chaud d'avril à juin.
De telles observations nous aideront à prédire les valeurs futures.. Avez-vous remarqué que nous n'utilisons qu'une seule variable (la température du dernier 2 ans)? Donc, c'est ce qu'on appelle l'analyse / Prévision de séries temporelles univariées.
1.2 Séries temporelles multivariées (MTS)
Une série chronologique multivariée a plus d'une variable dépendante du temps. Chaque variable ne dépend pas seulement de ses valeurs passées, il a également une certaine dépendance à l'égard d'autres variables. Cette dépendance est utilisée pour prévoir les valeurs futures. Cela semble compliqué? Laisse-moi expliquer.
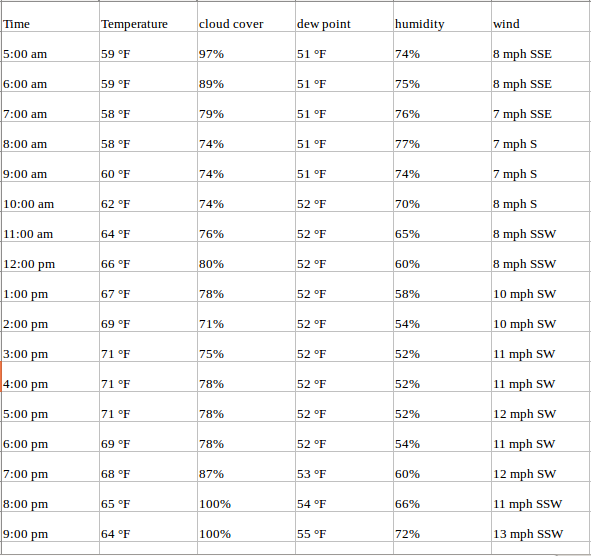
Considérez l'exemple ci-dessus. Supposons maintenant que notre ensemble de données inclut le pourcentage de transpiration, point de rosée, vitesse du vent, le pourcentage de couverture nuageuse, etc. avec la valeur de température des deux dernières années. Dans ce cas, plusieurs variables doivent être prises en compte pour prédire de manière optimale la température. Une série comme celle-ci entrerait dans la catégorie des séries chronologiques multivariées.. Ci-dessous une illustration de ce:
Maintenant que nous comprenons à quoi ressemble une série chronologique multivariée, comprenons comment nous pouvons l'utiliser pour construire une prévision.
2. Gestion d'une série temporelle multivariée – OÙ
Dans cette section, Je vais vous présenter l'une des méthodes les plus utilisées pour la prévision de séries chronologiques multivariées: Régression automatique vectorielle (OÙ).
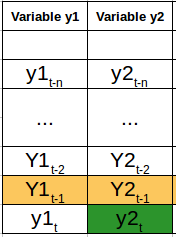
Dans un modèle VAR, chaque variable est une fonction linéaire des valeurs passées d'elle-même et des valeurs passées de toutes les autres variables. Pour mieux expliquer cela, Je vais utiliser un exemple visuel simple:
Nous avons deux variables, y1 et y2. Nous devons prévoir la valeur de ces deux variables au temps t, à partir des données fournies pour les n valeurs passées. Pour simplifier, J'ai pris la valeur de décalage pour être 1.
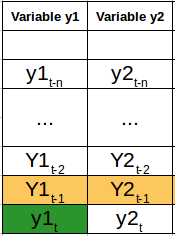
Pour calculer y1
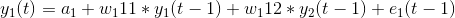
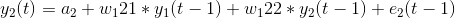
Ici,
- a1 et a2 sont les termes constants,
- w11, w12, w21 et w22 sont les coefficients,
- e1 et e2 sont les termes d'erreur
Ces équations sont similaires à l'équation d'un processus AR. Étant donné que le processus AR est utilisé pour les données de séries chronologiques univariées, les valeurs futures sont des combinaisons linéaires de vos propres valeurs passées uniquement. Considérez le processus de RA (1):
Oui
Dans ce cas, nous n'avons qu'une variable – Oui, un terme constant – une, un terme d'erreur – e, et un coefficient – w. Pour tenir compte des termes variables multiples dans chaque équation pour VAR, nous utiliserons des vecteurs. On peut écrire les équations (1) Oui (2) comme suit:
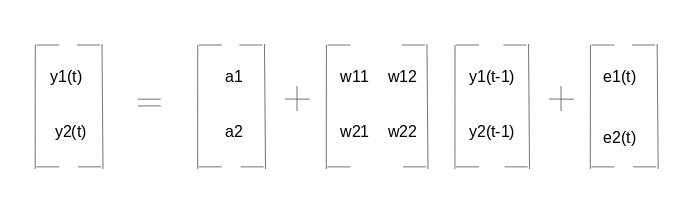
Les deux variables sont y1 et y2, suivi d'une constante, une métrique de coefficient, une valeur de retard et une métrique d'erreur. C'est l'équation vectorielle pour un processus VAR (1). Pour un processus VAR (2), un autre terme vectoriel sera ajouté pour le temps (t-2) à l'équation à généraliser pour les retards:
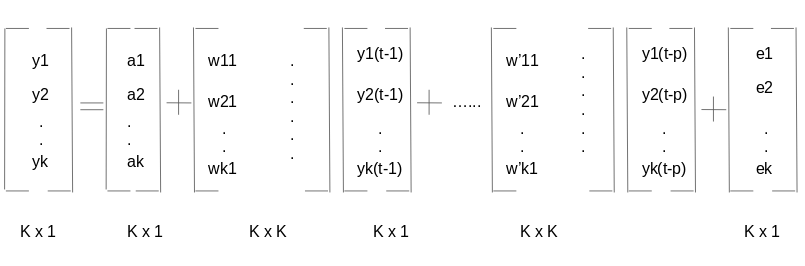
L'équation ci-dessus représente un processus VAR (p) avec les variables y1, y2… yk. La même chose peut s'écrire:
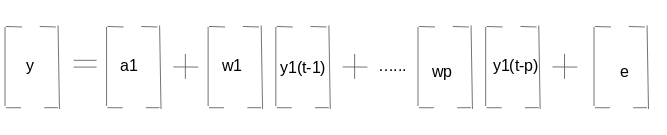
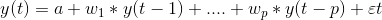
Le termet dans l'équation représente le bruit blanc vectoriel multivarié. Pour une série temporelle multivariée, et doit être un vecteur aléatoire continu qui satisfait les conditions suivantes:
- E (et) = 0
La valeur attendue pour le vecteur d'erreur est 0 - E (et1, et2‘) =12
Valeur attendue det ouit‘est l'écart type de la série
3. Pourquoi avons-nous besoin de VAR?
Rappelez-vous l'exemple de la prévision des températures tempérées que nous avons vu plus tôt. On peut affirmer qu'il sera traité comme une série univariée multiple. Nous pouvons le résoudre en utilisant des méthodes de prévision univariées simples comme AR. Puisque le but est de prédire la température, nous pouvons simplement supprimer les autres variables (sauf température) et ajuster un modèle à la série univariée restante.
Une autre idée simple est de prévoir les valeurs de chaque série individuellement en utilisant les techniques que nous connaissons déjà.. Cela rendrait le travail extrêmement facile!! Ensuite, Pourquoi devrais-je apprendre une autre technique de prévision? Ce sujet n'est-il pas déjà assez compliqué?
A partir des équations ci-dessus (1) Oui (2), il est clair que chaque variable utilise les valeurs passées de chaque variable pour faire les prédictions. Contrairement à la RA, VAR est capable de comprendre et d'utiliser la relation entre plusieurs variables.. Ceci est utile pour décrire le comportement dynamique des données et fournit également de meilleurs résultats de prévision.. En outre, la mise en œuvre de la VAR est aussi simple que d'utiliser n'importe quelle autre technique univariée (ce que vous verrez dans la dernière section).
4. Stationnarité d'une série temporelle multivariée
Nous savons par l'étude du concept univarié qu'une série temporelle stationnaire nous donnera, dans la majorité des cas, un meilleur ensemble de prédictions. Si vous n'êtes pas familier avec le concept de stationnarité, lisez d'abord cet article: Une introduction en douceur à la gestion des séries temporelles non stationnaires.
Pour resumer, pour une série temporelle univariée donnée:
Oui
La série est dite stationnaire si la valeur de | c | <1. À présent, rappelez-vous l'équation de notre processus VAR:
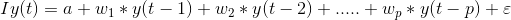
Noter: I est la matrice identité.
Représenter l'équation en termes de Opérateurs de retard, avoir:
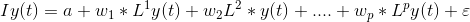
Prenant tous les termes et
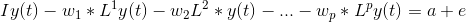
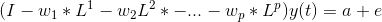
Le coefficient de y
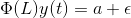
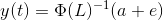
Pour qu'une série soit stationnaire, les valeurs propres de | Phi (L)-1| doit être inférieur à 1 en module. Cela peut sembler compliqué étant donné le nombre de variables dans la dérivation. Cette idée a été expliquée par un exemple numérique simple dans la vidéo suivante. Je vous recommande de le regarder pour solidifier votre compréhension:
Similaire au test de Dickey-Fuller augmenté pour les séries univariées, nous avons le test de Johansen pour vérifier la stationnarité de toutes les données de séries chronologiques multivariées. Nous verrons comment effectuer le test dans la dernière section de cet article.
5. Division validation des trains
Si vous avez déjà travaillé avec des données de séries chronologiques univariées, connaître les ensembles de validation de train. L'idée de créer un ensemble de validation est d'analyser les performances du modèle avant de l'utiliser pour faire des prédictions..
La création d'un ensemble de validation pour les problèmes de séries temporelles est délicate car nous devons prendre en compte la composante temporelle. On ne peut pas utiliser directement le train_test_split O k-fold validation, car cela interrompra le motif de la série. L'ensemble de validation doit être créé en tenant compte des valeurs de date et d'heure.
Supposons que nous devions prévoir la température, point de rosée, le pourcentage de nuages, etc. pour les deux prochains mois en utilisant les données des deux dernières années. Une méthode possible consiste à garder les données des deux derniers mois de côté et à entraîner le modèle dans le 22 mois restants.
Une fois le modèle formé, nous pouvons l'utiliser pour faire des prédictions sur l'ensemble de validation. Sur la base de ces prévisions et des valeurs réelles, nous pouvons vérifier les performances du modèle et les variables pour lesquelles le modèle n'a pas fonctionné aussi bien. Et pour faire la prédiction finale, utiliser l'ensemble de données complet (combiner les ensembles de train et de validation).
6. Implémentation Python
Dans cette section, Nous allons implémenter le modèle Vector AR dans un ensemble de données de jouets. J'ai utilisé l'ensemble de données sur la qualité de l'air pour cela et vous pouvez le télécharger à partir de ici.
#importer les packages requis
importer des pandas au format pd
importer matplotlib.pyplot en tant que plt
%matplotlib en ligne

#lire les données
df = pd.read_csv("Qualité de l'airUCI.csv", parse_dates=[['Date', 'Time']])

#vérifier les types
df.dtypes
Objet Date_Heure
CO(GT)            int64
PT08.S1(CO)       int64
NMHC(GT)          int64
C6H6(GT)          int64
PT08.S2(NMHC)     int64
NOx(GT)           int64
PT08.S3(NOx)      int64
NO2(GT)           int64
PT08.S4(NO2)      int64
PT08.S5(O3)       int64
T int64
RH int64
AH int64
dtype: objet
Le type de données du Date et heure la colonne est objet et nous devons le changer en date et heure. En outre, préparer les données, nous avons besoin que le indiceLe "Indice" C’est un outil fondamental dans les livres et les documents, qui vous permet de localiser rapidement les informations souhaitées. Généralement, Il est présenté au début d’une œuvre et organise les contenus de manière hiérarchique, y compris les chapitres et les sections. Sa préparation correcte facilite la navigation et améliore la compréhension du matériau, ce qui en fait une ressource incontournable tant pour les étudiants que pour les professionnels dans divers domaines.... ait date et heure. Suivez les commandes suivantes:
df['Date_Time'] = pd.to_datetime(df.Date_Heure , format="%d/%m/%Y %H.%M.%S")
données = df.drop(['Date_Time'], axe=1)
data.index = df.Date_Time
L'étape suivante consiste à traiter les valeurs manquantes. Étant donné que les valeurs manquantes dans les données sont remplacées par une valeur -200, nous devrons imputer la valeur manquante avec un meilleur nombre. Considère ceci: si la valeur actuelle du point de rosée est manquante, nous pouvons supposer sans risque qu'il sera proche de la valeur de l'heure précédente. logique, vérité? Ici, je vais imputer -200 avec la valeur précédente.
Vous pouvez choisir de remplacer la valeur en utilisant la moyenne de certaines valeurs précédentes, ou la valeur à la même heure la veille (vous pouvez partager votre (s) idée (s) imputer les valeurs manquantes dans la section commentaires ci-dessous).
#traitement de la valeur manquante
cols = data.columns
pour j dans les cols:
    pour moi à portée(0,longueur(Les données)):
       si les données[j][je] == -200:
           Les données[j][je] = données[j][i-1]

#vérification de la stationnarité
de statsmodels.tsa.vector_ar.vecm importer coint_johansen
#puisque le test ne fonctionne que pour 12 variables, j'ai laissé tomber au hasard
#dans la prochaine itération, J'en laisserais tomber un autre et vérifierais les valeurs propres
johan_test_temp = data.drop([ 'CO(GT)'], axe=1)
coint_johansen(johan_test_temp,-1,1).posséder
Ci-dessous le résultat du test:
déployer([ 0.17806667,  0.1552133 ,  0.1274826 ,  0.12277888,  0.09554265,
        0.08383711,  0.07246919,  0.06337852,  0.04051374,  0.02652395,
        0.01467492,  0.00051835])
Nous pouvons maintenant aller de l'avant et créer l'ensemble de validation pour s'adapter au modèle et tester les performances du modèle:
#créer le train et l'ensemble de validation
train = données[:entier(0.8*(longueur(Les données)))]
valide = données[entier(0.8*(longueur(Les données))):]

#adapter le modèle
à partir de statsmodels.tsa.vector_ar.var_model importer VAR

modèle = VAR(endog = train)
model_fit = model.fit()

# faire une prédiction sur la validation
prédiction = model_fit.forecast(model_fit.y, pas = longueur(valide))
Les prédictions sont sous la forme d'une matrice, où chaque liste représente les prédictions de la ligne. Nous allons le transformer en un format plus présentable.
#conversion des prédictions en dataframe
pred = pd.DataFrame(index=plage(0,longueur(prédiction)),colonnes=[cols])
pour j dans la plage(0,13):
    pour moi à portée(0, longueur(prédiction)):
       pred.iloc[je][j] = prédiction[je][j]

#vérifier rmse
pour moi dans les cols:
    imprimer('valeur de rmse pour', je, 'est : ', carré(Mean_squared_error(pred[je], valide[je])))
Sortie du code précédent:
valeur efficace pour le CO(GT) est :  1.4200393103392812
valeur efficace pour PT08.S1(CO) est :  303.3909208229375
valeur rmse pour NMHC(GT) est :  204.0662895081472
valeur efficace pour C6H6(GT) est :  28.153391799471244
valeur efficace pour PT08.S2(NMHC) est :  6.538063846286176
valeur efficace pour NOx(GT) est :  265.04913993413805
valeur efficace pour PT08.S3(NOx) est :  250.7673347152554
valeur efficace pour NO2(GT) est :  238.92642219826683
valeur efficace pour PT08.S4(NO2) est :  247.50612831072633
valeur efficace pour PT08.S5(O3) est :  392.3129907890131
la valeur efficace pour T est :  383.1344361254454
La valeur efficace pour RH est :  506.5847387424092
la valeur efficace pour AH est :  8.139735443605728
Après avoir testé dans l'ensemble de validation, ajustons le modèle sur l'ensemble de données complet
#faire des prédictions finales
modèle = VAR(pair = données)
model_fit = model.fit()
yhat = model_fit.forecast(model_fit.y, étapes=1)
imprimer(ouais)
Remarques finales
Avant de commencer cet article, l'idée de travailler avec une série chronologique multivariée semblait d'une portée intimidante. C'est une question complexe, alors prenez votre temps pour comprendre les détails. La meilleure façon d'apprendre est de pratiquer, donc j'espère que l'implémentation python ci-dessus vous sera utile.
Je vous recommande d'utiliser cette approche sur un jeu de données de votre choix. Cela renforcera davantage votre compréhension de ce sujet complexe mais très utile.. Si vous avez des suggestions ou des questions, partagez-le dans la section commentaires.





