
Questo articolo è stato pubblicato nell'ambito del Blogathon sulla scienza dei dati
introduzione
Ci sono stati una serie di sviluppi nel campo della apprendimento profondoApprendimento profondo, Una sottodisciplina dell'intelligenza artificiale, si affida a reti neurali artificiali per analizzare ed elaborare grandi volumi di dati. Questa tecnica consente alle macchine di apprendere modelli ed eseguire compiti complessi, come il riconoscimento vocale e la visione artificiale. La sua capacità di migliorare continuamente man mano che vengono forniti più dati lo rende uno strumento chiave in vari settori, dalla salute... e visione artificiale. Soprattutto con l'introduzione di reti neurali convoluzionali molto profonde, questi modelli hanno contribuito a ottenere risultati all'avanguardia su problemi come il riconoscimento e la classificazione delle immagini.
Quindi, negli anni, le architetture di deep learning sono diventate sempre più profonde (aggiungendo più livelli) per risolvere compiti sempre più complessi, che ha anche contribuito a migliorare le prestazioni dei compiti di classificazione e ricognizione e anche a renderli robusti.
Ma quando continuiamo ad aggiungere altri strati al neuronale rossoLe reti neurali sono modelli computazionali ispirati al funzionamento del cervello umano. Usano strutture note come neuroni artificiali per elaborare e apprendere dai dati. Queste reti sono fondamentali nel campo dell'intelligenza artificiale, consentendo progressi significativi in attività come il riconoscimento delle immagini, Elaborazione del linguaggio naturale e previsione delle serie temporali, tra gli altri. La loro capacità di apprendere schemi complessi li rende strumenti potenti.., diventa molto più difficile da addestrare e la precisione del modello inizia a saturarsi e poi anche a degradarsi. Ecco che arriva ResNet per salvarci da quello scenario e aiutarci a risolvere questo problema.
Cos'è ResNet?
Rete Residua (ResNet) è uno dei famosi modelli di deep learning introdotti da Shaoqing Ren, Kaiming He, Jian Sun e Xiangyu Zhang nel loro articolo. Il documento è stato nominato “Apprendimento residuo profondo per il riconoscimento delle immagini”. [1] Su 2015. Il modello ResNet è uno dei modelli di deep learning più popolari e di successo finora.
Blocchi residui
Il problema della formazione di reti molto profonde è stato alleviato con l'introduzione di questi blocchi residui e il modello ResNet è costituito da questi blocchi.
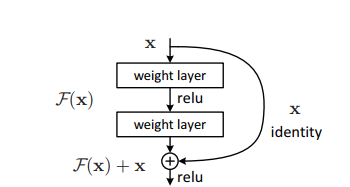
Il problema della formazione di reti molto profonde è stato alleviato con l'introduzione di questi blocchi residui e il modello ResNet è costituito da questi blocchi.
Nel figura"Figura" è un termine che viene utilizzato in vari contesti, Dall'arte all'anatomia. In campo artistico, si riferisce alla rappresentazione di forme umane o animali in sculture e dipinti. In anatomia, designa la forma e la struttura del corpo. Cosa c'è di più, in matematica, "figura" è legato alle forme geometriche. La sua versatilità lo rende un concetto fondamentale in molteplici discipline.... anteriore, la prima cosa che possiamo notare è che c'è una connessione diretta che omette alcuni strati del modello. Questa connessione si chiama “collegamento salta” ed è il cuore dei blocchi residui. L'output non è lo stesso a causa di questa connessione hop. Senza la connessione di salto, la voce "X viene moltiplicata per i pesi del livello seguita dall'aggiunta di un termine di inclinazione".
Poi arriva il funzione svegliaLa funzione di attivazione è un componente chiave nelle reti neurali, poiché determina l'output di un neurone in base al suo input. Il suo scopo principale è quello di introdurre non linearità nel modello, Consentendo di apprendere modelli complessi nei dati. Ci sono varie funzioni di attivazione, come il sigma, ReLU e tanh, Ognuno con caratteristiche particolari che influiscono sulle prestazioni del modello in diverse applicazioni...., F () e otteniamo l'output come H (X).
h (X) = f (wx + B) Oh (X) = f (X)
Ora, con l'introduzione di una nuova tecnica di collegamento a salto, l'uscita è H (X) cambia in
h (X) = f (X) + X
Ma l' dimensione"Dimensione" È un termine che viene utilizzato in varie discipline, come la fisica, Matematica e filosofia. Si riferisce alla misura in cui un oggetto o un fenomeno può essere analizzato o descritto. In fisica, ad esempio, Si parla di dimensioni spaziali e temporali, mentre in matematica può riferirsi al numero di coordinate necessarie per rappresentare uno spazio. Comprenderlo è fondamentale per lo studio e... dell'input può variare da quello dell'output, cosa potrebbe succedere con un copertina convolutivaIl livello convoluzionale, Fondamentale nelle reti neurali convoluzionali (CNN), Viene utilizzato principalmente per l'elaborazione dei dati con strutture a griglia, come immagini. Questo livello applica filtri che estraggono le caratteristiche rilevanti, come bordi e trame, Consentire al modello di riconoscere modelli complessi. La sua capacità di ridurre la dimensionalità dei dati e di mantenere le informazioni essenziali lo rende uno strumento chiave nelle attività di visione artificiale.. o livelli raggruppati. Perciò, questo problema può essere gestito con questi due approcci:
· Zero è imbottito con il jump connection per aumentarne le dimensioni.
· Vengono aggiunti strati convolutivi 1 × 1 all'ingresso per abbinare le dimensioni. In quel caso, l'uscita è:
h (X) = f (X) + w1.x
Qui viene aggiunto un parametro extra w1 mentre non viene aggiunto alcun parametro extra quando si utilizza il primo approccio.
Questa tecnica di bypass della connessione in ResNet risolve il problema della scomparsa del gradienteGradiente è un termine usato in vari campi, come la matematica e l'informatica, per descrivere una variazione continua di valori. In matematica, si riferisce al tasso di variazione di una funzione, mentre in progettazione grafica, Si applica alla transizione del colore. Questo concetto è essenziale per comprendere fenomeni come l'ottimizzazione negli algoritmi e la rappresentazione visiva dei dati, consentendo una migliore interpretazione e analisi in... su CNN profonde consentendo un percorso di scelta rapida alternativo per il flusso del gradiente. Cosa c'è di più, la connessione di bypass aiuta se qualsiasi livello danneggia le prestazioni dell'architettura, allora sarà omesso per mezzo del regolarizzazioneLa regolarizzazione è un processo amministrativo che cerca di formalizzare la situazione di persone o entità che operano al di fuori del quadro giuridico. Questa procedura è essenziale per garantire diritti e doveri, nonché a promuovere l'inclusione sociale ed economica. In molti paesi, La regolarizzazione viene applicata in contesti migratori, Lavoro e fiscalità, consentire a chi si trova in situazione irregolare di accedere ai benefici e tutelarsi da possibili sanzioni.....
Architettura ResNet
C'è una semplice rete di 34 livelli nell'architettura ispirata a VGG-19 in cui vengono aggiunti la connessione ad accesso diretto o le connessioni hop. Queste connessioni hop o blocchi residui convertono quindi l'architettura nella rete residua come mostrato nella figura seguente.
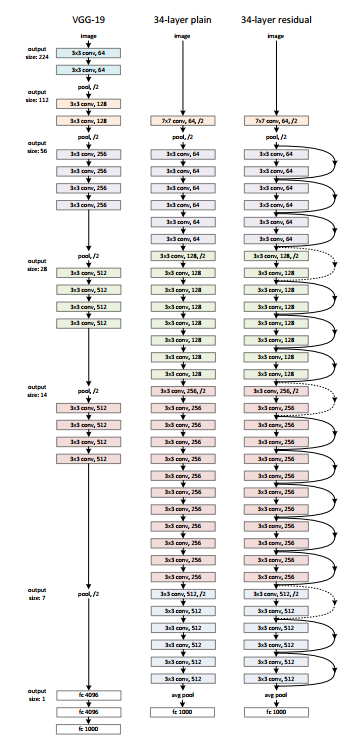
Fonte: ‘Apprendimento residuo profondo per il riconoscimento delle immagini‘ carta
Utilizzo di ResNet con Keras:
Keras è una libreria di deep learning open source in grado di funzionare su TensorFlow. Keras Applications fornisce le seguenti versioni di ResNet.
– ResNet50
– ResNet50V2
– ResNet101
– ResNet101V2
– ResNet152
– ResNet152V2
Costruiamo ResNet da zero:
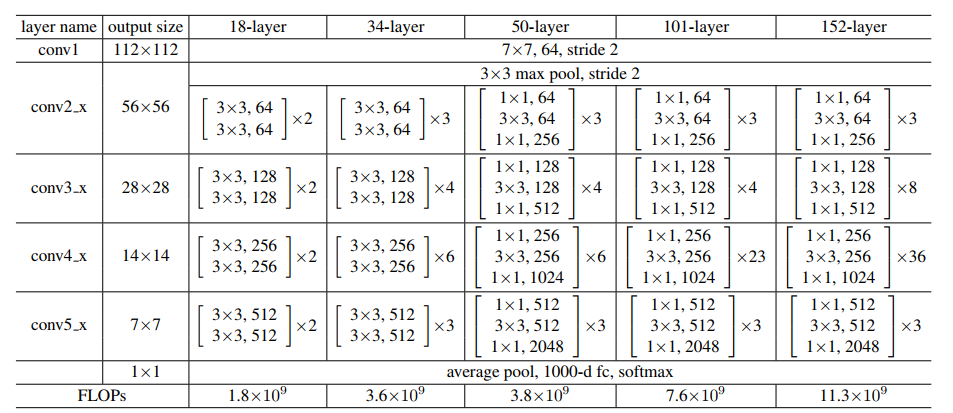
Fonte: ‘Apprendimento residuo profondo per il riconoscimento delle immagini‘ carta
Manteniamo l'immagine sopra come riferimento e iniziamo a costruire la rete..
La arquitectura de ResNet usa los bloques CNN varias veces, así que creemos una clase para el bloque CNN, que toma canales de entrada y canales de salida. Hay un batchnorm2d después de cada capa de conv.
import torch
import torch.nn as nn
blocco di classe(nn.Modulo):
    def __init__(
        se stesso, in_channels, intermediate_channels, identity_downsample=Nessuno, falcata=1
    ):
        super(blocco, se stesso).__dentro__()
        self.expansion = 4
        self.conv1 = nn. Conv2d(
            in_channels, intermediate_channels, kernel_size=1, falcata=1, imbottitura=0, bias=Falso
        )
        self.bn1 = nn. BatchNorm2d(intermediate_channels)
        self.conv2 = nn. Conv2d(
            intermediate_channels,
            intermediate_channels,
            kernel_size=3,
            falcata=falcata,
            imbottitura=1,
            bias=Falso
        )
        self.bn2 = nn. BatchNorm2d(intermediate_channels)
        self.conv3 = nn. Conv2d(
            intermediate_channels,
            intermediate_channels * self.expansion,
            kernel_size=1,
            falcata=1,
            imbottitura=0,
            bias=Falso
        )
        self.bn3 = nn. BatchNorm2d(intermediate_channels * self.expansion)
        self.relu = nn. ReLU()
        self.identity_downsample = identity_downsample
        self.stride = stride

    def forward(se stesso, X):
        identità = x.clone()

        x = self.conv1(X)
        x = self.bn1(X)
        x = self.relu(X)
        x = self.conv2(X)
        x = self.bn2(X)
        x = self.relu(X)
        x = self.conv3(X)
        x = self.bn3(X)

        Se self.identity_downsample non è Nessuno:
            identità = self.identity_downsample(identità)

        x += identity
        x = self.relu(X)
        restituire x
Dopo, cree una clase ResNet que tome la entrada de varios bloques, copertine, canales de imagen y la cantidad de clases.
Nel seguente codice, la función '_make_layer’
crea las capas ResNet, que toma la entrada de bloques, el número de residuales
blocchi, canal de salida y zancadas.
classe ResNet(nn.Modulo):
    def __init__(se stesso, blocco, strati, image_channels, num_classi):
        super(ResNet, se stesso).__dentro__()
        self.in_channels = 64
        self.conv1 = nn. Conv2d(image_channels, 64, kernel_size=7, falcata=2, imbottitura=3, bias=Falso)
        self.bn1 = nn. BatchNorm2d(64)
        self.relu = nn. ReLU()
        self.maxpool = nn. MaxPool2d(kernel_size=3, falcata=2, imbottitura=1)
# Essenzialmente l'intera architettura ResNet è in questi 4 lines below
self.layer1 = self._make_layer(
blocco, strati[0], intermediate_channels=64, falcata=1
)
self.layer2 = self._make_layer(
blocco, strati[1], intermediate_channels=128, falcata=2
)
self.layer3 = self._make_layer(
blocco, strati[2], intermediate_channels=256, falcata=2
)
self.layer4 = self._make_layer(
blocco, strati[3], intermediate_channels=512, falcata=2
)

self.avgpool = nn. AdaptiveAvgPool2d((1, 1))
self.fc = nn. Lineare(512 * 4, num_classi)

def avanti(se stesso, X):
x = self.conv1(X)
x = self.bn1(X)
x = self.relu(X)
x = self.maxpool(X)
x = self.layer1(X)
x = self.layer2(X)
x = self.layer3(X)
x = self.layer4(X)

x = self.avgpool(X)
x = x.reshape(x.shape[0], -1)
x = self.fc(X)

return x

def _make_layer(se stesso, blocco, num_residual_blocks, intermediate_channels, passo):
identity_downsample = None
layers = []

# O se dimezziamo lo spazio di input per ex, 56x56 -> 28x28 (falcata=2), o modifiche ai canali
# dobbiamo adattare l'Identità (salta connessione) quindi sarà in grado di essere aggiunto
# to the layer that's ahead


if stride != 1 o self.in_channels != intermediate_channels * 4:
identity_downsample = nn. Sequenziale(
nn. Conv2d(
self.in_channels,
intermediate_channels * 4,
kernel_size=1,
falcata=falcata,
bias=Falso
),
nn. BatchNorm2d(intermediate_channels * 4),
)

layers.append(
blocco(self.in_channels, intermediate_channels, identity_downsample, passo)
)

# La dimensione di espansione è sempre 4 per ResNet 50,101,152
self.in_channels = intermediate_channels * 4

# Ad esempio per il primo livello resnet: 256 verrà mappato a 64 come strato intermedio,
# poi finalmente torna a 256. Quindi non è necessario alcun downsample di identità, dal passo = 1,
# e anche la stessa quantità di canali.
per io nel raggio d'azione(num_residual_blocks - 1):
layers.append(blocco(self.in_channels, intermediate_channels))
ritorno nn. Sequenziale (* copertine)
Luego defina diferentes versiones de ResNet
– A ResNet50, la sequenza degli strati è [3, 4, 6, 3].
– Per ResNet101, la sequenza degli strati è [3, 4, 23, 3].
– Per ResNet152, la sequenza degli strati è [3, 8, 36, 3]. (Chiedi a ‘Apprendimento residuo profondo per il riconoscimento delle immagini‘ carta)
def ResNet50(img_channel=3, num_classes=1000):
    ritorno ResNet(blocco, [3, 4, 6, 3], img_channel, num_classi)
def ResNet101(img_channel=3, num_classes=1000):
ritorno ResNet(blocco, [3, 4, 23, 3], img_channel, num_classi)


def ResNet152(img_channel=3, num_classes=1000):
ritorno ResNet(blocco, [3, 8, 36, 3], img_channel, num_classi)
Dopo, scrivi un piccolo codice di prova per verificare se il modello funziona correttamente.
def test():
    netto = ResNet101(img_channel=3, num_classes=1000)
    dispositivo = "miracoli" se torcia.cuda.è_disponibile() altro "processore"
    y = netto(torcia.randn(4, 3, 224, 224)).a(dispositivo)
    Stampa(y.size())
test()
Per il caso di prova sopra, l'uscita deve essere:
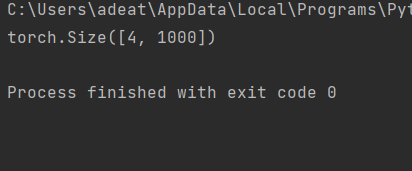
Il codice completo è accessibile qui:
https://github.com/BakingBrains/Deep_Learning_models_implementation_from-scratch_using_pytorch_/blob/main/ResNet_.py
[1]. Kaiming He, Xiangyu Zhang, Shaoqing Ren, Jian Sun: Apprendimento profondo residuo per il riconoscimento delle immagini, dicembre di 2015, DOI: https://arxiv.org/abs/1512.03385
Grazie.
I vostri suggerimenti e dubbi sono i benvenuti qui nella sezione commenti. Grazie per aver letto il mio articolo!





