
Mappa piccola è un modello di programmazione per elaborare grandi insiemi di dati con un algoritmo parallelo, distribuito in un cluster (fonte: Wikipedia). MapReduce, quando combinato con HDFS, può essere utilizzato per gestire i big data. I principi fondamentali di questo sistema HDFS-MapReduce, comunemente noto come Hadoop, sono stati discussi nel nostro post precedente.
L'unità di informazione di base che viene utilizzata in Riduci mappaMapReduce è un modello di programmazione progettato per elaborare e generare in modo efficiente set di dati di grandi dimensioni. Sviluppato da Google, Questo approccio suddivide il lavoro in attività più piccole, che sono distribuiti tra più nodi in un cluster. Ogni nodo elabora la sua parte e poi i risultati vengono combinati. Questo metodo consente di scalare le applicazioni e gestire enormi volumi di informazioni, essere fondamentali nel mondo dei Big Data.... è una coppia (chiave, valore). Tutti i tipi di dati strutturati e non strutturati devono essere tradotti in questa unità di base, prima di fornire i dati al modello MapReduce. Come suggerisce il nome, Il modello MapReduce è composto da due routine separate, vale a dire, funzione di mappa e funzione di riduzione. Questo post ti aiuterà a capire passo dopo passo il funzionamento del modello MapReduce. Il calcolo di un input (In altre parole, in un insieme di coppie) nel modello MapReduce avviene in tre fasi:
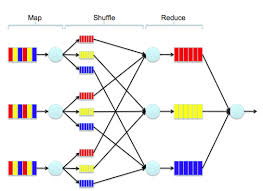
passo 1: la fase di mappa
passo 2: la fase di shuffle
passo 3: la fase di riduzione.
Semanticamente, le fasi di mappa e shuffle distribuiscono i dati, e la fase di riduzione esegue il calcolo. In questo articolo analizzeremo in dettaglio ciascuna di queste fasi.
[stextbox id=”section”] La fase di mappa [/stextbox]
La logica di MapReduce, a differenza di altri framework di dati, non si limita ai set di dati strutturati. Inoltre possiede una grande capacità di gestire dati non strutturati. La fase di mappa è il passaggio critico che lo rende fattibile. MapperMapper è uno strumento che facilita la visualizzazione e l'analisi dei dati geospaziali. Consente agli utenti di creare mappe interattive e personalizzabili, l'integrazione di informazioni diverse come i dati demografici, Infrastrutture e risorse naturali. Il suo utilizzo si estende in settori come l'urbanistica, Ricerca ambientale e gestione delle risorse, contribuire a un processo decisionale informato e allo sviluppo sostenibile. Mapper è diventato una soluzione essenziale in... fornisce una struttura ai dati non strutturati. Come esempio, se voglio contare il numero di fotografie sul mio portatile per la posizione (cittadina), in cui è stata scattata la foto, ho bisogno di analizzare dati non strutturati. L'assegnatore crea coppie (chiave, valore) a partire da questo set di dati. Per questo caso, la chiave sarà la posizione e il valore sarà la fotografia. Una volta che l'assegnatore termina il suo compito, abbiamo una struttura per tutto il set di dati.
Nella fase di mappa, l'assegnatore prende una singola coppia (chiave, valore) come input e produce qualsiasi numero di coppie (chiave, valore) come uscita. È essenziale pensare all'operazione di mappa come stateless, In altre parole, la sua logica opera su una singola coppia alla volta (anche se in pratica vengono inviati più coppie di input allo stesso assegnatore). Per riassumere, per la fase di mappa, l'utente semplicemente progetta una funzione di mappa che assegna una coppia di input (chiave, valore) a qualsiasi numero (anche nessuno) di coppie di output. La maggior parte delle volte, la fase di mappatura viene utilizzata semplicemente per specificare la posizione desiderata del valore di input cambiando la sua chiave.
[stextbox id=”section”] La fase di mescolamento [/stextbox]
La fase di riproduzione casuale è gestita automaticamente dal framework MapReduce, In altre parole, l'ingegnere non deve fare nulla in questa fase. Il sistema sottostante che implementa MapReduce indirizza tutti i valori associati a una singola chiave allo stesso riduttore.
[stextbox id=”section”] La fase di riduzione [/stextbox]
Nella fase di riduzione, il riduttore prende tutti i valori associati a una singola chiave k e genera un qualsiasi numero di coppie (chiave, valore). Questo mette in evidenza uno degli aspetti sequenziali del calcolo di MapReduce: tutte le mappe devono terminare prima che possa iniziare la fase di riduzione. Poiché il riduttore ha accesso a tutti i valori con la stessa chiave, può effettuare calcoli sequenziali su questi valori. Nella fase di riduzione, il parallelismo viene sfruttato osservando che i riduttori che operano su chiavi diverse possono essere eseguiti contemporaneamente. Per riassumere, Per la fase di riduzione, l'utente progetta una funzione che prende come input una lista di valori associati a una singola chiave e genera un numero qualsiasi di coppie. Spesso, le chiavi di output di un riduttore sono uguali alla chiave di input (in realtà, Nel modello originale di MapReduce, la chiave di output deve uguale alla chiave di input, ma Hadoop ha rilassato questa restrizione).
Generalmente, Un programma nel paradigma MapReduce può consistere di molti cicli (in generale chiamati lavori) di diverse funzioni di mappatura e riduzione, eseguite sequenzialmente una dopo l'altra.
[stextbox id=”section”] Un esempio [/stextbox]
Consideriamo un esempio per comprendere a fondo Map-Reduce. Abbiamo i seguenti 3 frasi:
1. La volpe marrone veloce
2. La volpe ha mangiato il topo
3. Come ora la mucca marrone
Il nostro obiettivo è contare la frequenza di ogni parola in tutte le frasi. Immaginate che ciascuna di queste frasi occupi una grande quantità di memoria e, perché, venga assegnata a diversi nodi dati. Il mapper si occupa di questi dati non strutturati e crea coppie chiave-valore. Per questo caso, la chiave è la parola e il valore è il conteggio di questa parola nel testo disponibile in questo nodoNodo è una piattaforma digitale che facilita la connessione tra professionisti e aziende alla ricerca di talenti. Attraverso un sistema intuitivo, Consente agli utenti di creare profili, condividere esperienze e accedere a opportunità di lavoro. La sua attenzione alla collaborazione e al networking rende Nodo uno strumento prezioso per chi vuole ampliare la propria rete professionale e trovare progetti in linea con le proprie competenze e obiettivi.... di dati. Come esempio, il nodo 1° Map genera 4 coppie chiave-valore: (il, 1), (brown, 1), (fox, 1), (quick, 1). Il primo 3 le coppie chiave-valore vanno al primo reducer e l'ultima chiave-valore al secondo reducer.
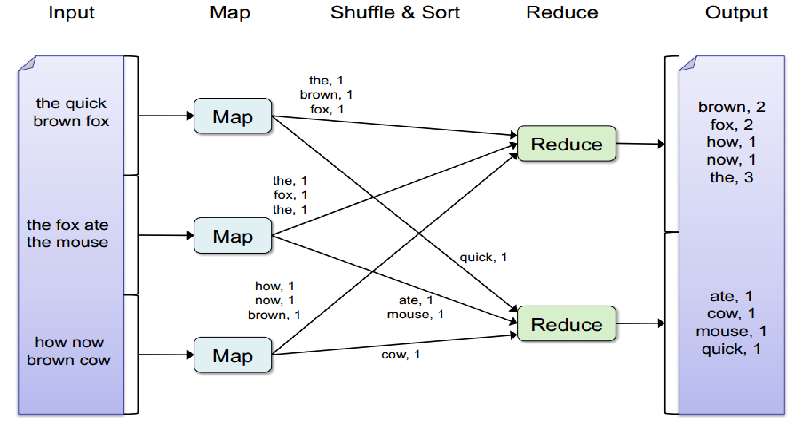
Allo stesso modo, le funzioni di mappa 2 e 3 creano la mappa delle altre due frasi. Mescolando, tutte le parole simili arrivano allo stesso finale. Una volta ordinati i coppie chiave-valore, la funzione riduttrice opera su questi dati strutturati per generare un riepilogo.
[stextbox id=”section”] Note finali: [/stextbox]
Prendiamo un esempio dell'uso della funzione Map-Reduce nell'industria:
• Nel motore di ricerca di Google:
– Costruzione di indici per la ricerca di Google
– Raggruppamento di post per Google News
– Traduzione automatica statistica
• Su Yahoo !:
– Creazione di indici per Yahoo! Cercare
– Rilevamento dello spam per Yahoo! Posta
• Su Facebook:
– Elaborazione dati
– Ottimizzazione degli annunci
– Esempio di rilevamento dello spam
• Su Amazon:
– Raggruppamento dei prodotti
– Traduzione automatica statistica
La restricción de utilizar la función Map-reduce es que el usuario tiene que seguir un formato lógico. Esta lógica es generar pares clave-valor usando la función Mapa y después resumir usando la función Reducir. Ma, fortunatamente, la mayoría de las operaciones de manipulación de datos se pueden engañar en este formato. En el próximo post tomaremos algunos ejemplos como how hacer una fusion de conjuntos de datos, multiplicación de matrices, transposición de matrices, eccetera. usando Map-Reduce.
Il post ti è stato utile?? Comparta con nosotros otros ejemplos prácticos de la función Map-Reduce. Fateci sapere i vostri pensieri su questo post nella casella qui sotto..





