
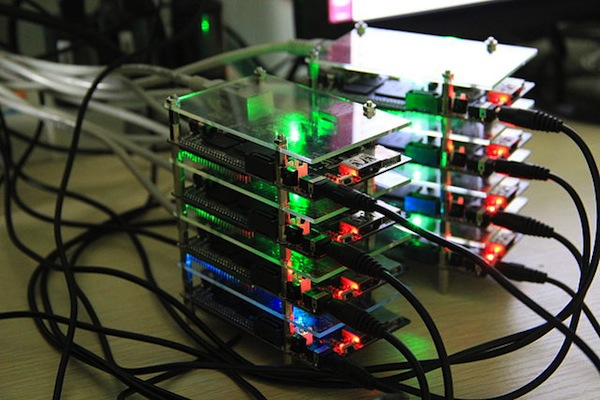
Hadoop, il progetto open source di successo supervisionato dalla Apache Software Foundation, è una tecnologia economica che permette di elaborare grandi quantità di dati molto diversi. I loro enormi vantaggi Rispetto ai sistemi distribuiti tipici, non significa che non abbia degli svantaggi, come la latenza o problemi di compatibilità nello streaming e nei file batch, ma questo non compromette la robustezza di questo framework.
Come è noto, Hadoop è un framework basato su Java che segue due concetti semplici: memorizzare i dati nell' sistema di file distribuitoUn sistema di file distribuito (DFS) permette la memorizzazione e l'accesso ai dati su più server, facilitando la gestione di grandi volumi di informazioni. Questo tipo di sistema migliora la disponibilità e la ridondanza, poiché i file vengono replicati in diverse posizioni, il che riduce il rischio di perdita di dati. Cosa c'è di più, permette agli utenti di accedere ai file da diverse piattaforme e dispositivi, promuovendo la collaborazione e... l'Hadoop (HDF) e elaborarli attraverso Riduci mappaMapReduce è un modello di programmazione progettato per elaborare e generare in modo efficiente set di dati di grandi dimensioni. Sviluppato da Google, Questo approccio suddivide il lavoro in attività più piccole, che sono distribuiti tra più nodi in un cluster. Ogni nodo elabora la sua parte e poi i risultati vengono combinati. Questo metodo consente di scalare le applicazioni e gestire enormi volumi di informazioni, essere fondamentali nel mondo dei Big Data...., il modello di programmazione per l'elaborazione distribuita dei dati.
MapReduce e HDFS
MapReduce conferma il famoso detto romano di Dividi e conquista (Dividi e conquista), poiché prende un problema complesso e lo suddivide in parti elaborabili in parallelo. Cada una de estas piezas las envía a un nodoNodo è una piattaforma digitale che facilita la connessione tra professionisti e aziende alla ricerca di talenti. Attraverso un sistema intuitivo, Consente agli utenti di creare profili, condividere esperienze e accedere a opportunità di lavoro. La sua attenzione alla collaborazione e al networking rende Nodo uno strumento prezioso per chi vuole ampliare la propria rete professionale e trovare progetti in linea con le proprie competenze e obiettivi.... del cluster o servidor para trabajar con ellas en las fases de mapeo (Carta geografica) e Ridurre, en este caso tomando como entrada las listas obtenidas en el Carta geografica y generar una colección de valores.
Cosa c'è di più, HDFSHDFS, o File system distribuito Hadoop, Si tratta di un'infrastruttura chiave per l'archiviazione di grandi volumi di dati. Progettato per funzionare su hardware comune, HDFS consente la distribuzione dei dati su più nodi, garantire un'elevata disponibilità e tolleranza ai guasti. La sua architettura si basa su un modello master-slave, dove un nodo master gestisce il sistema e i nodi slave memorizzano i dati, facilitare l'elaborazione efficiente delle informazioni.. es un sistema de archivos distribuido que almacena grandes cantidades de datos y hardware económico. La potencia se logra uniendo nodos al cluster, vale a dire, equipos que no tienen características excepcionales, lo que facilita la reposición en caso de avería.
El uso de Hadoop con programas como HDFS o MapReduce le permite trabajar en parallelo con big data, ofreciendo una solución integrada y facilmente escalable. Sopra “Hadoop. La Guida Definitiva,”, el famoso libro de Tom White, Hadoop se define como linealmente escalable (se possono agregar nodos según las necesidades), con un Alta disponibilità (i file vengono replicati tutte le volte che è necessario, il che conferisce affidabilità) y tolerancia a fallas.
Infatti, quando si lavora con MapReduce e HDFS in Hadoop si evitano i guasti del grappoloUn cluster è un insieme di aziende e organizzazioni interconnesse che operano nello stesso settore o area geografica, e che collaborano per migliorare la loro competitività. Questi raggruppamenti consentono la condivisione delle risorse, Conoscenze e tecnologie, promuovere l'innovazione e la crescita economica. I cluster possono coprire una varietà di settori, Dalla tecnologia all'agricoltura, e sono fondamentali per lo sviluppo regionale e la creazione di posti di lavoro.... server, vale a dire, il framework ha lo stesso comportamento in caso di guasti del server, perciò i processi di calcolo non vengono interrotti.
Questa tolleranza ai guasti si traduce in una robustezza per Hadoop a cui si aggiungono altri vantaggi indiscutibili come il basso costo di archiviazione, la facilità d'uso, prestazione, la velocità e la flessibilità nell'analizzare dati sia strutturati che non strutturati.
Supponendo che nessun sistema distribuito possa raggiungere il massimo in termini di consistenza, disponibilità e tolleranza ai guasti, secondo il professore Eric Brewer, Hadoop è abbastanza vicino a questi tre requisiti, por lo que se puede dire che es un sistema distribuido con muy alto rendimiento.
El futuro de MapReduce
Lo sviluppo de Hadoop continúa avanzando con nuevas contribuciones que mejoran su usabilidad, como el framework Chispa apache, que puede mejorar el rendimiento de MapReduce, enriquecendo su kernel. Anche se Spark potrebbe sostituire a MapReduce o anche actuar de forma independiente, convirtiéndose en sucesor de Hadoop, lo cierto es que tiene un gran potenziale trabajando con ellos para mejorar problemi como latencia, análisis de datos en tiempo real y mayor eficiencia en las consultas que solicitan los datos de forma repetida. .
La versatilidad de Spark podría verse como un peligro para el futuro de Hadoop, que en su día marcó la differenza frente a las bases de datos relacionales (RDBMS) como sistema distribuido de almacenamiento y procesamiento. Per adesso, muchos analistas creen que él es el principal candidato como sucesor de MapReduce o del propio Hadoop. Sea como sea, lo cierto es que Spark es un framework autónomo, pero su design le permette di lavorare con el sistema de archivos distribuido de Hadoop. In particolare, se puede ejecutar direttamente en HDFS, dentro de MapReduce o para trabajar en paralelo con MapReduce en el mismo clúster.
Articolo correlato:
Databricks para certificar software de terceros para Spark Apache
Hadoop si o no? Las preguntas para ayudarte a decidir
API de Hadoop 1.0.3: viaje a la nube
Crediti fotografici: Equipo Cubie
(funzione(D, S, ID) {
var js, fjs = d.getElementsByTagName(S)[0];
Se (d.getElementById(ID)) Restituzione;
js = d.createElement(S); js.id = id;
js.src = “//connect.facebook.net/es_ES/all.js#xfbml=1&stato=0”;
fjs.parentNode.insertBefore(js, fjs);
}(documento, 'copione', 'facebook-jssdk'));





