
Panoramica
- Che cos'è K sta per Clustering??
- Implementación de K significa Clustering
- WCSS y método de codo para encontrar el número de conglomerados
- Implementación de Python de K significa Clustering
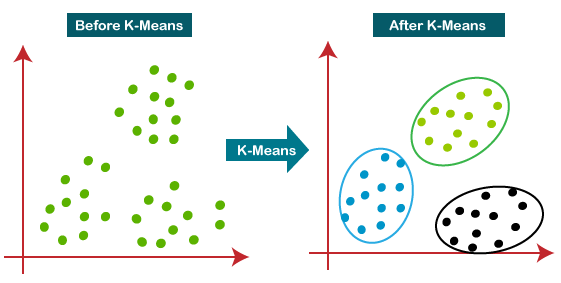
K means es uno de los algoritmos de aprendizaje automático no supervisados más populares utilizados para resolver problemi de clasificación. K significa que segrega los datos sin etiquetar en varios grupos, llamados clústeres, en función de tener características similares, patrones comunes.
Sommario
- ¿Qué es la agrupación en clústeres?
- ¿Qué es el algoritmo de K significa?
- Implementación esquemática de la agrupación en clústeres de KMeans
- Elegir el numero correcto de clústeres
- Implementazione Python
1. ¿Qué es la agrupación en clústeres?
Supponiamo di avere un numero N di insiemi di dati multivariati non etichettati di diversi animali come cani, gatti, uccelli, eccetera. La tecnica per separare insiemi di dati in diversi gruppi, sulla base di avere caratteristiche e attributi simili, si chiama Clustering..
I gruppi che si formano sono conosciuti come Cluster. La tecnica di clustering viene utilizzata in diversi campi, como el reconocimiento de imágenes, il filtraggio della posta indesiderata
Il clustering viene utilizzato nell'algoritmo di Apprendimento non supervisionatoL'apprendimento non supervisionato è una tecnica di apprendimento automatico che consente ai modelli di identificare modelli e strutture nei dati senza etichette predefinite. Attraverso algoritmi come k-means e analisi delle componenti principali, Questo approccio viene utilizzato in una varietà di applicazioni, come la segmentazione dei clienti, Rilevamento delle anomalie e compressione dei dati. La sua capacità di rivelare informazioni nascoste lo rende uno strumento prezioso... nell'apprendimento automatico come si possono separare dati multivariati in diversi gruppi, senza alcun supervisore, sulla base di un modello comune nascosto all'interno degli insiemi di dati.
2. ¿Qué es el algoritmo de K significa?
L'algoritmo K-means è un algoritmo iterativo che suddivide un insieme di n dati in k sottogruppi / cluster in base alla somiglianza e alla distanza media dal centroide di quel sottogruppo / formato in particolare..
K, Qui è indicato il numero predefinito di cluster che formerà l'algoritmo. Se K = 3, significa che il numero di cluster che si formeranno dall'insieme di dati è 3
Passaggi dell'algoritmo K-means
Il funzionamento dell'algoritmo K-Means è spiegato nei seguenti passaggi:
passo 1: Selezionare il valore di K per decidere il numero di cluster che si formeranno.
passo 2: Selezionare K punti casuali che agiranno come centroidi.
passo 3: Assegnare ogni punto dati, in base alla sua distanza dai punti selezionati a caso (centroide), al centroide más cercano / cercano que formará los grupos predefinidos.
passo 4: coloque un nuevo centroide de cada grupo.
passo 5: Ripetere il passaggio 3, que reassigna cada punto de datos al nuevo centroide más cercano de cada grupo.
passo 6: Si ocurre alguna reasignación, vaya al paso 4; altrimenti, vaya al paso 7.
passo 7: TERMINAR
3. Implementación esquemática de la agrupación en clústeres de K medias
PASO 1:Elijamos el número k de conglomerados, vale a dire, K = 2, para segregar el conjunto de datos y colocarlos en diferentes conglomerados respectivos. Elegiremos algunos 2 punti aleatorios que actuarán como centroide para formar el grupo.
PASO 2: Ahora asignaremos cada punto de datos a un Diagramma di dispersioneIl grafico a dispersione è uno strumento grafico utilizzato in statistica per visualizzare la relazione tra due variabili. Consiste in un insieme di punti in un piano cartesiano, dove ogni punto rappresenta una coppia di valori corrispondenti alle variabili analizzate. Questo tipo di grafico consente di identificare i modelli, Tendenze e possibili correlazioni, facilitare l'interpretazione dei dati e il processo decisionale sulla base delle informazioni visive presentate.... basado en su distance desde el punto K o centroide más cercano. Se hará dibujando una medianoLa mediana è una misura statistica che rappresenta il valore centrale di un insieme di dati ordinati. Per calcolarlo, I dati sono organizzati dal più basso al più alto e viene identificato il numero al centro. Se c'è un numero pari di osservazioni, I due valori fondamentali sono mediati. Questo indicatore è particolarmente utile nelle distribuzioni asimmetriche, poiché non è influenzato da valori estremi.... tra entrambi i centroidi. Considera la seguente immagine:
PASO 3: los puntos del lado izquierdo de la línea están cerca del centroide azul y los puntos a la derecha de la línea están cerca del centroide amarillo. El de la izquierda forma un grupo con centroide azul y el de la derecha con el centroide amarillo.
PASO 4:repita el proceso eligiendo un nuevo centroide. Per scegliere i nuovi centroidi, encontraremos el nuevo centro de gravedad de estos centroides, mostrato sotto:
PASO 5: Prossimo, reasignaremos cada punto de datos al nuevo centroide. Repetiremos el mismo proceso anterior (usando una línea mediana). El punto de datos amarillo en el lado azul de la línea mediana se incluirá en el grupo azul
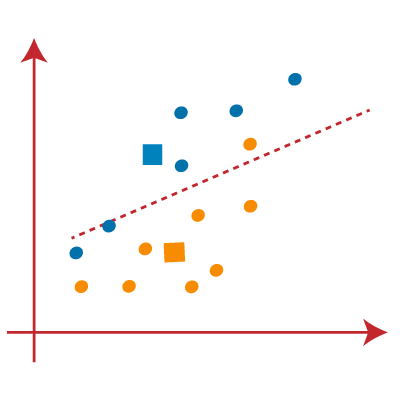
PASO 6: A medida que se haya realizado la reasignación, repetiremos el paso anterior de encontrar nuevos centroides.
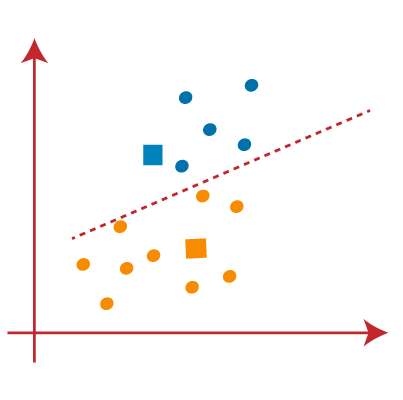
PASO 7: Repetiremos el proceso anterior de encontrar el centro de gravedad de los centroides, come mostrato di seguito.
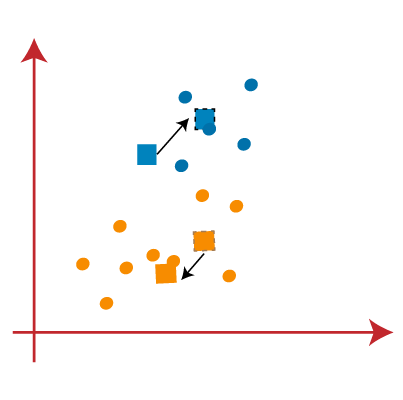
PASO 8: Después de encontrar los nuevos centroides, dibujaremos nuevamente la línea mediana y reasignaremos los puntos de datos, como en los pasos anteriores.
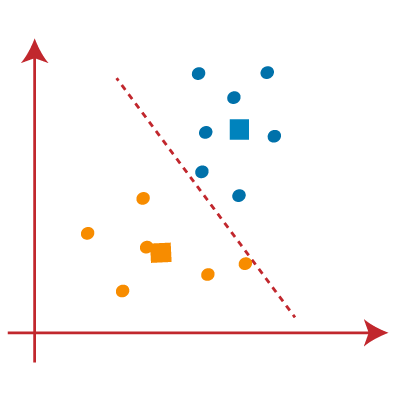
PASO 9: Finalmente, segregaremos puntos basados en la línea mediana, de modo che se formen dos grupos y ningún punto diferente se incluya en un solo grupo.
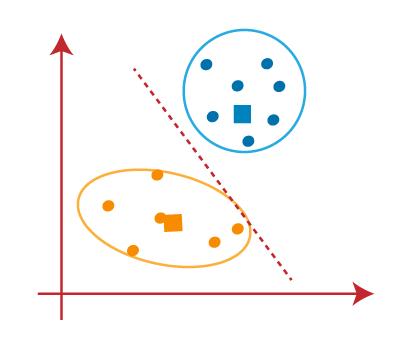
El grupo final que se está formando es el siguiente
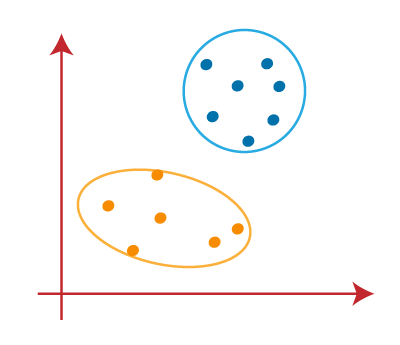
4. Elegir el numero correcto de clústeres
El número de clústeres que elegimos para el algoritmo no debe ser aleatorio. Todos y cada uno de los conglomerados se forman calculando y comparando las distancias medias de cada punto de datos dentro de un conglomerado desde su centroide.
Podemos elegir el número correcto de clústeres con la ayuda del método de suma de cuadrados dentro del grappoloUn cluster è un insieme di aziende e organizzazioni interconnesse che operano nello stesso settore o area geografica, e che collaborano per migliorare la loro competitività. Questi raggruppamenti consentono la condivisione delle risorse, Conoscenze e tecnologie, promuovere l'innovazione e la crescita economica. I cluster possono coprire una varietà di settori, Dalla tecnologia all'agricoltura, e sono fondamentali per lo sviluppo regionale e la creazione di posti di lavoro.... (WCSS).
WCSS Representa la suma de los cuadrados de las distancias de los puntos de datos en todos y cada uno de los grupos desde su centroide.
La idea principal es minimizar la distancia entre los puntos de datos y el centroide de los conglomerados. El proceso se itera hasta alcanzar un valor mínimo para la suma de distancias.
Para encontrar el valor óptimo de los clústeres, el método del codo sigue los pasos a continuación:
1 Eseguire il comando raggruppamentoIl "raggruppamento" È un concetto che si riferisce all'organizzazione di elementi o individui in gruppi con caratteristiche o obiettivi comuni. Questo processo viene utilizzato in varie discipline, compresa la psicologia, Educazione e biologia, per facilitare l'analisi e la comprensione di comportamenti o fenomeni. In ambito educativo, ad esempio, Il raggruppamento può migliorare l'interazione e l'apprendimento tra gli studenti incoraggiando il lavoro.. de K-medias en un conjunto de datos dado para diferentes valores de K (que van del 1 al 10).
2 Per ogni valore di K, calcula el valor WCSS.
3 Traza un gráfico / curva entre los valores WCSS y il numero respectivo de conglomerados K.
4 Il punto acuto di curvatura o un punto (che sembra una articolazione del gomito) della trama come un braccio, sarà considerato come il miglior / valore ottimale di K
5. Implementazione Python
Importare le librerie rilevanti
import numpy as np
import pandas as pd
import statsmodels.api as sm
import matplotlib.pyplot as plt
import seaborn as sns
sns.set()
da sklearn.cluster importa KMeans
Caricamento dei dati
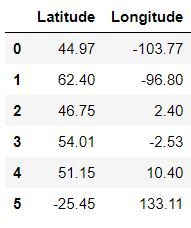
data = pd.read_csv('Countryclusters.csv')
dati
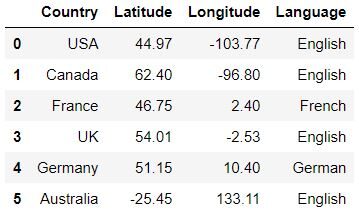
Tracciare i dati
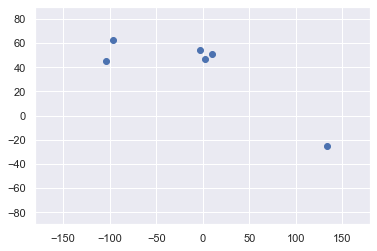
plt.scatter(dati['Longitude'],dati['Latitude'])
plt.xlim(-180,180)
plt.ylim(-90,90)
plt.mostra()
Selezionare la funzione
 x = data.iloc[:,1:3] # 1t for rows and second for columns
x
Raggruppamento
kmsignifica = KMezzi(3)
means.fit(X)
Risultati del clustering
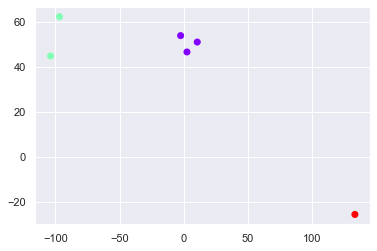
identified_clusters = kmeans.fit_predict(X)
identified_clusters
Vettore([1, 1, 0, 0, 0, 2])
data_with_clusters = data.copy()
data_with_clusters['Clusters'] = identified_clusters
plt.scatter(data_with_clusters['Longitude'],data_with_clusters['Latitude'],c=data_with_clusters['Clusters'],cmap='rainbow')
Provare un metodo diverso (per trovare non. Grupchi per selezionare)
WCSS e metodo del gomito
wcss=[]
per io nel raggio d'azione(1,7):
kmsignifica = KMezzi(io)
kmeans.fit(X)
wcss_iter = kmeans.inertia_
wcss.append(wcss_iter)

number_clusters = range(1,7)
plt.trama(number_clusters,wcss)
plt.titolo('The Elbow titolo')
plt.xlabel('Numero di cluster')
plt.ylabel('WCSS')
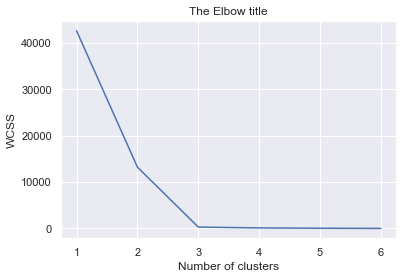
podemos elegir 3 como no. de conglomerados, este metodo mostra cuál es el buen numero de conglomerados.
Con questo chiudo questo blog..
Ciao a tutti, Namaste
Mi nombre es Pranshu Sharma y soy un entusiasta de la scienza de datos
Grazie mille per aver dedicato del tuo tempo prezioso a leggere questo blog.. Sentiti libero di segnalare eventuali errori (Dopotutto, sono un apprendista) e fornire i commenti corrispondenti o lasciare un commento.
Dhanyvaad !!
Feedback:
E-mail: [e-mail protetta]
Il supporto mostrato in questo articolo non è di proprietà di DataPeaker e viene utilizzato a discrezione dell'autore.





