
Questo articolo è stato pubblicato nell'ambito del Blogathon sulla scienza dei dati.
introduzione
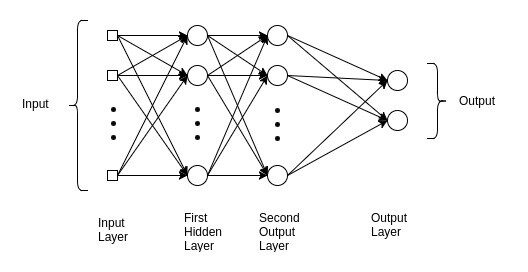
Comprendere questa rete ci aiuta a ottenere informazioni sulle ragioni sottostanti nei modelli avanzati di Deep Learning. Il percettrone multistrato è comunemente usato in problemi di regressione semplice. tuttavia, Gli MLP non sono ideali per elaborare pattern con dati sequenziali e multidimensionali.
🙄 Un percettrone multistrato si sforza di ricordare pattern nei dati sequenziali, A causa di ciò, richiede una “grande” quantità di parametriIl "parametri" sono variabili o criteri che vengono utilizzati per definire, misurare o valutare un fenomeno o un sistema. In vari campi come la statistica, Informatica e Ricerca Scientifica, I parametri sono fondamentali per stabilire norme e standard che guidano l'analisi e l'interpretazione dei dati. La loro corretta selezione e gestione sono fondamentali per ottenere risultati accurati e pertinenti in qualsiasi studio o progetto.... per elaborare dati multidimensionali.
MLP, CNN y RNN no hacen todo …
Gran parte de su éxito proviene de identifier su obiettivo y la buena elección de algunos parámetros, Che cosa Funzione di perdita, Ottimizzatore, e Regularizador.
También disponemos de datos ajenos al entorno de formación. El papel del regularizador es garantizar que el modelo entrenado se generalice a nuevos datos.
Set di dati MNIST
Supongamos que nuestro obiettivo es creare una red para identificar números basados en dígitos escritos a mano. Ad esempio, quando l'input della rete è un'immagine di un numero 8, la previsione corrispondente deve essere anch'essa 8.
🤷🏻♂️ Questo è un lavoro di classificazione di base con le reti neurali.
Prima di analizzare il modello MLP, è essenziale comprendere il dataset MNIST. Viene utilizzato per spiegare e convalidare molte teorie su apprendimento profondoApprendimento profondo, Una sottodisciplina dell'intelligenza artificiale, si affida a reti neurali artificiali per analizzare ed elaborare grandi volumi di dati. Questa tecnica consente alle macchine di apprendere modelli ed eseguire compiti complessi, come il riconoscimento vocale e la visione artificiale. La sua capacità di migliorare continuamente man mano che vengono forniti più dati lo rende uno strumento chiave in vari settori, dalla salute... perché le 70.000 immagini che contiene sono piccole ma sufficientemente ricche di informazioni;
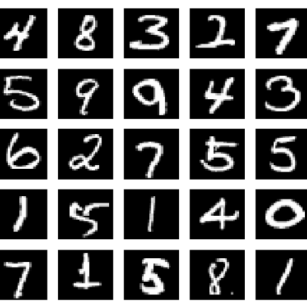
MNIST è una raccolta di cifre che vanno da 0 al 9. Ha un set di addestramentoLa formazione è un processo sistematico volto a migliorare le competenze, conoscenze o abilità fisiche. Viene applicato in vari ambiti, come lo sport, Formazione e sviluppo professionale. Un programma di allenamento efficace include la pianificazione degli obiettivi, Pratica regolare e valutazione dei progressi. L'adattamento alle esigenze individuali e la motivazione sono fattori chiave per ottenere risultati di successo e sostenibili in qualsiasi disciplina.... a partire dal 60.000 immagini e 10.000 test classificati in categorie.
Usare il dataset MNIST in TensorFlow è semplice.
importare insensibile come per esempio
a partire dal tensorflow.keras.datasets importare mnist
(x_treno, y_train), (x_test, y_test) = mnist.load_data()
il mnist.load_data () Il metodo è comodo, dato che non è necessario caricare le 70.000 immagini e le loro etichette.
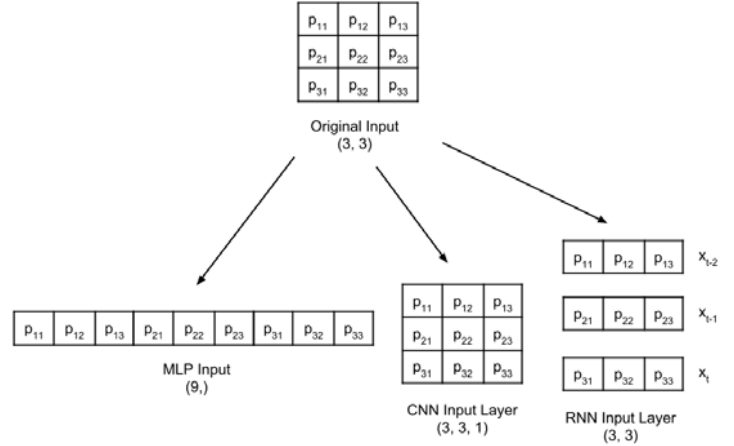
Antes di entrare en el clasificador de Perceptrón Multicapa, es fundamental tener en cuenta que, si bien los datos del MNIST constan de tensores bidimensionales, se deben remodelar, según el tipo de livello di inputIl "livello di input" si riferisce al livello iniziale in un processo di analisi dei dati o nelle architetture di reti neurali. La sua funzione principale è quella di ricevere ed elaborare le informazioni grezze prima che vengano trasformate dagli strati successivi. Nel contesto dell'apprendimento automatico, La corretta configurazione del livello di input è fondamentale per garantire l'efficacia del modello e ottimizzarne le prestazioni in attività specifiche.....
Se cambia la forma de una imagen en escala de grises de 3 × 3 para las capas de entrada MLP, CNN y RNN:
Las etiquetas tienen forma de dígitos, del 0 al 9.
num_labels = len(np.unique(y_train))
Stampa("total de labels:T{}".formato(num_labels))
Stampa("etichette:ttt{0}".formato(np.unique(y_train)))
⚠️ Esta representación no es adecuada para la capa de pronóstico que genera probabilidad por clase. El formato más adecuado es one-hot, un vector de 10 dimensiones como todos los valores 0, excepto el indiceIl "Indice" È uno strumento fondamentale nei libri e nei documenti, che consente di individuare rapidamente le informazioni desiderate. In genere, Viene presentato all'inizio di un'opera e organizza i contenuti in modo gerarchico, compresi capitoli e sezioni. La sua corretta preparazione facilita la navigazione e migliora la comprensione del materiale, rendendolo una risorsa essenziale sia per gli studenti che per i professionisti in vari settori.... de clase. Ad esempio, si la etiqueta es 4, el vector equivalente es [0,0,0,0, 1, 0,0,0,0,0].
En Deep Learning, los datos se almacenan en un tensoreI tensori sono strutture matematiche che generalizzano concetti come scalari e vettori. Sono utilizzati in varie discipline, compresa la fisica, Ingegneria e Machine Learning, per rappresentare dati multidimensionali. Un tensore può essere visualizzato come una matrice multidimensionale, che consente di modellare relazioni complesse tra variabili diverse. La loro versatilità e capacità di gestire grandi volumi di informazioni li rendono strumenti fondamentali nell'analisi e nell'elaborazione dei dati..... El término tensor se aplica a un tensor escalar (tensor 0D), vector (tensor 1D), Sede centrale (tensor bidimensional) e tensor multidimensionalI tensori multidimensionali sono strutture matematiche che generalizzano la nozione di scalari, vettori e matrici a dimensioni superiori. Vengono ampiamente utilizzati in campi come la fisica, l'ingegneria e l'apprendimento automatico, permettono di rappresentare e manipolare dati complessi in modo efficiente. La loro capacità di memorizzare informazioni su più dimensioni facilita l'analisi e la modellizzazione di fenomeni reali, contribuendo a progressi in diverse discipline scientifiche e tecnologiche.....
#converter em one-hot
from tensorflow.keras.utils import to_categorical
y_train = to_categorical(y_train)
y_test = to_categorical(y_test)
Il nostro modello è un MLP, quindi i suoi input devono essere un tensore 1D. come tale, x_train e x_test devono essere trasformati in [60,000, 2828] e [10,000, 2828],
possono fare poco, la dimensione di -1 significa permettere alla libreria di calcolare la dimensione corretta. Nel caso di x_train, è 60.000.
image_size = x_train.shape[1]
input_size = image_size * image_size

print("x_treno:T{}".formato(x_train.shape))
Stampa("x_test:tt{}n".formato(x_test.shape))

x_train = np.reshape(x_treno, [-1, input_size])
x_train = x_train.astype('float32') / 255

x_test = np.reshape(x_test, [-1, input_size])
x_test = x_test.astype('float32') / 255

Stampa("x_treno:T{}".formato(x_train.shape))
Stampa("x_test:tt{}".formato(x_test.shape))
OUTPUT:
x_treno:	(60000, 28, 28)
x_test:		(10000, 28, 28)

x_treno:	(60000, 784)
x_test:		(10000, 784)
Costruzione del modello
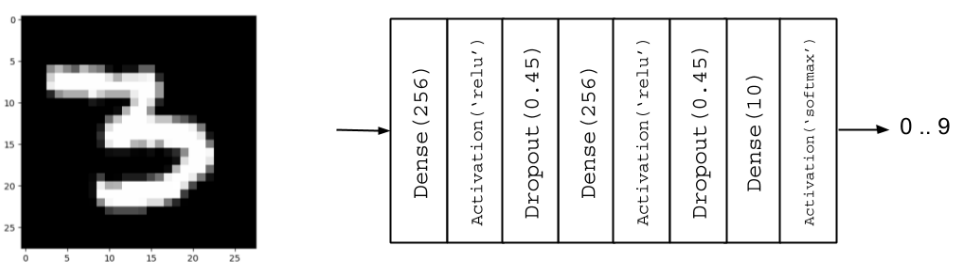
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Dense, Attivazione, Ritirarsi

# Parameters
batch_size = 128 # È la dimensione del campione di input da elaborare in ogni fase di addestramento.
hidden_units = 256
abbandono = 0.45

# Nossa  MLP com ReLU e Dropout
model = Sequential()

modello.aggiungi(Denso(hidden_units, input_dim=input_size))
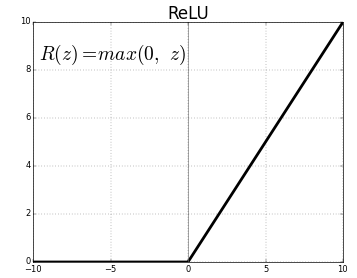
modello.aggiungi(Attivazione('relu'))
modello.aggiungi(Ritirarsi(ritirarsi))

modello.aggiungi(Denso(hidden_units))
modello.aggiungi(Attivazione('relu'))
modello.aggiungi(Ritirarsi(ritirarsi))

modello.aggiungi(Denso(num_labels))
regolarizzazione
Una rete neurale tende a memorizzare i propri dati di addestramento, soprattutto se contiene capacità più che sufficiente. In questo caso, la rete fallisce in modo catastrofico quando viene sottoposta ai dati di test.
Questo è il caso classico in cui la rete non riesce a generalizzare (AllestimentoL'overfitting, o sovradattamento, è un fenomeno nell'apprendimento automatico in cui un modello si adatta eccessivamente ai dati di addestramento, catturando rumore e schemi irrilevanti. Questo comporta una scarsa performance sui dati non visti, poiché il modello perde capacità di generalizzazione. Per mitigare l'overfitting, possono essere impiegate tecniche come la regolarizzazione, la validazione incrociata e la riduzione della complessità del modello.... / AllestimentoL'underfitting è un problema comune nell'apprendimento automatico che si verifica quando un modello è troppo semplice per catturare la complessità dei dati. Ciò si traduce in scarse prestazioni sia sul set di addestramento sia su quello di test. Le cause dell'underfitting possono includere un modello inadeguato, caratteristiche irrilevanti o dati insufficienti. Per risolverlo, si può optare per modelli più complessi o migliorare la qualità...). Per evitare questa tendenza, il modello utilizza uno strato regolatore. Dropout.
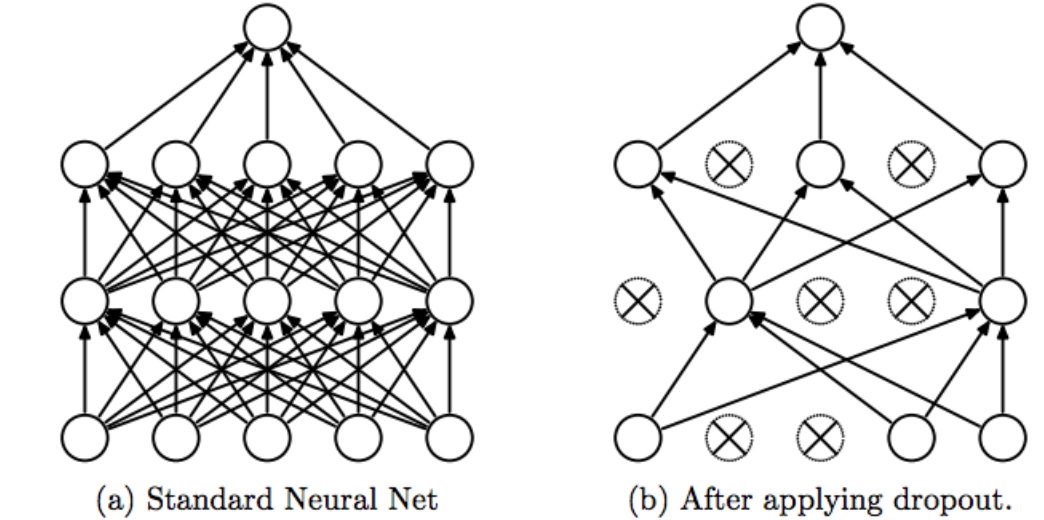
L'idea del Dropout è semplice. Data una certa percentuale di esclusione (nel nostro modello, impostiamo = 0,45), lo strato elimina casualmente questa frazione di unità.
Ad esempio, se il primo strato ha 256 unità, dopo che il dropout è stato applicato (0.45), assolo (1 – 0.45) * 255 = 140 le unità parteciperanno allo strato successivo
Il dropout rende le reti neurali più robuste per dati di input imprevisti, perché la rete è addestrata a prevedere correttamente, anche se alcune unità sono assenti.
⚠️ Il dropout partecipa solo in “giocare a” 🤷🏻♂️ durante l'addestramento.
Attivazione
Il Livello di outputIl "Livello di output" è un concetto utilizzato nel campo della tecnologia dell'informazione e della progettazione di sistemi. Si riferisce all'ultimo livello di un modello o di un'architettura software che è responsabile della presentazione dei risultati all'utente finale. Questo livello è fondamentale per l'esperienza dell'utente, poiché consente l'interazione diretta con il sistema e la visualizzazione dei dati elaborati.... avere 10 unità, seguite da una funzione di attivazione softmax. Il 10 le unità corrispondono alle 10 possibili etichette, classi o categorie.
L'attivazione di softmax può essere espressa matematicamente, secondo la seguente equazione:
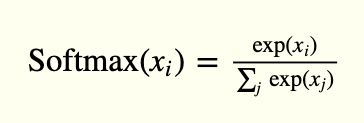
modello.aggiungi(Attivazione('softmax'))
modello.riepilogo()
OUTPUT:
Modello: "sequenziale"
_________________________________________________________________
Strato (genere)                 Parametro forma di output #
=================================================================
dense (Denso)                (Nessuno, 256)               200960
_________________________________________________________________
activation (Attivazione)      (Nessuno, 256)               0
_________________________________________________________________
dropout (Ritirarsi)            (Nessuno, 256)               0
_________________________________________________________________
dense_1 (Denso)              (Nessuno, 256)               65792
_________________________________________________________________
activation_1 (Attivazione)    (Nessuno, 256)               0
_________________________________________________________________
dropout_1 (Ritirarsi)          (Nessuno, 256)               0
_________________________________________________________________
densa_2 (Denso)              (Nessuno, 10)                2570
_________________________________________________________________
activation_2 (Attivazione)    (Nessuno, 10)                0
================================================== ===============
Parametri totali: 269,322
Parametri addestrabili: 269,322
Parametri non addestrabili: 0
_________________________________________________________________
Visualizzazione dei modelli
Miglioramento
Lo scopo dell'Ottimizzazione è minimizzare la funzione di perdita. L'idea è che se la perdita viene ridotta a un livello accettabile, il modello ha imparato indirettamente la funzione che assegna gli input agli output. Le metriche di performance vengono utilizzate per determinare se il tuo modello ha imparato.
modello.compila(perdita="categorical_crossentropy", ottimizzatore="Adamo", metriche=['accuracy'])
-
- Categorical_crossentropy, si utilizza per one-hot
- La precisione è una buona metrica per i compiti di classificazione.
- Adam è un Algoritmo di ottimizzazioneUn algoritmo di ottimizzazione è un insieme di regole e procedure progettate per trovare la migliore soluzione a un problema specifico, Massimizzazione o minimizzazione di una funzione di destinazione. Questi algoritmi sono fondamentali in vari ambiti, come l'ingegneria, L'economia e l'intelligenza artificiale, in cui cerca di migliorare l'efficienza e ridurre i costi. Esistono diversi approcci, compresi gli algoritmi genetici, Programmazione lineare e metodi di ottimizzazione combinatoria.... che può essere utilizzato al posto della procedura classica di discesa gradienteGradiente è un termine usato in vari campi, come la matematica e l'informatica, per descrivere una variazione continua di valori. In matematica, si riferisce al tasso di variazione di una funzione, mentre in progettazione grafica, Si applica alla transizione del colore. Questo concetto è essenziale per comprendere fenomeni come l'ottimizzazione negli algoritmi e la rappresentazione visiva dei dati, consentendo una migliore interpretazione e analisi in... Stocastico
📌 Dato il nostro set di addestramento, la scelta del Funzione di perditaLa funzione di perdita è uno strumento fondamentale nell'apprendimento automatico che quantifica la discrepanza tra le previsioni del modello e i valori effettivi. Il suo obiettivo è quello di guidare il processo di formazione minimizzando questa differenza, consentendo così al modello di apprendere in modo più efficace. Esistono diversi tipi di funzioni di perdita, come l'errore quadratico medio e l'entropia incrociata, ognuno adatto a compiti diversi e..., ottimizzatore e del regularizzatore, possiamo iniziare ad addestrare il nostro modello.
model.fit(x_treno, y_train, epochs=20, batch_size=batch_size)
OUTPUT:
Epoca 1/20
469/469 [==============================] - 1s 3ms/step - perdita: 0.4230 - precisione: 0.8690
....
Epoca 20/20
469/469 [==============================] - 2s 4ms/passo - perdita: 0.0515 - precisione: 0.9835
Valutazione
A questo punto, il nostro modello classificatore di cifre MNIST è completo. Su evaluación de desempeño será el siguiente paso para determinar si el modelo entrenado presentará una solución subóptima
_, acc = model.evaluate(x_test,
                        y_test,
                        batch_size=batch_size,
                        verboso=0)
Stampa("nAccuracy: %.1f%%n" % (100.0 * acc))
OUTPUT:
Precisione: 98.4%
continuará...





