
Introdução
Se em algum momento você participou de concursos de ciência de dados, você deve estar ciente do papel crítico que a modelagem de conjunto desempenha. Na realidade, A modelagem de conjunto é considerada uma das maneiras mais atraentes de construir modelos preditivos altamente precisos. A disponibilidade de ensacamento e reforço Algoritmos embelezam ainda mais este método para produzir um nível surpreendente de precisão.
Por isso, na próxima vez que você criar um modelo preditivo, considere usar este algoritmo. Eu definitivamente me daria um tapinha nas costas por essa sugestão.. E, se você já domina este método, genial. Eu adoraria ouvir sua experiência em modelagem de conjunto na seção de comentários abaixo..
De outra forma, Eu compartilho algumas das perguntas mais frequentes sobre modelagem de conjunto. Se a qualquer momento você quiser examinar o conhecimento de alguém sobre o conjunto, você pode se atrever a fazer essas perguntas e verificar seus conhecimentos. Ao mesmo tempo, essas são algumas das perguntas mais fáceis, então você não pode ousar estar errado.
Quais são as perguntas comuns (associado a modelos de conjunto)?
Depois de analisar vários fóruns de ciência de dados, Eu identifiquei o 5 Perguntas comuns associadas à modelagem de conjunto. Essas questões são muito relevantes para cientistas de dados que são novos na modelagem de conjuntos.. Aqui estão as perguntas:
- O que é um modelo definido?
- O que estão ensacando, reforço e empilhamento?
- Podemos montar vários modelos do mesmo algoritmo de ML?
- Como podemos identificar os pesos dos diferentes modelos?
- Quais são os benefícios do modelo de conjunto?
Vamos analisar cada questão em detalhes.
1. O que é um modelo definido?
Vamos tentar entender isso resolvendo um desafio de qualificação.
Problema: definir regras para classificar e-mails de spam
Solução: Podemos gerar várias regras para a classificação de e-mails de spam, vamos ver alguns deles:
- E-mails indesejados
- Têm uma extensão total menor que 20 palavras.
- Tem apenas imagem (imagens promocionais)
- Tenha palavras-chave específicas como “ganhe dinheiro e cresça” e “reduza sua gordura”
- Mais palavras soletradas no e-mail
- Sem spam
- Email do domínio DataPeaker
- E-mail de membros da família ou de qualquer pessoa na lista de endereços de e-mail
Acima, Listei algumas regras comuns para a filtragem de e-mails de spam. Você acha que todas essas regras individualmente podem prever a classe correta?
A maioria de nós diria não, E isso é verdade! A combinação dessas regras fornecerá uma previsão sólida em comparação com a previsão feita por regras individuais.. Este é o princípio da modelagem de conjunto. O modelo de conjunto combina vários 'modelos individuais’ (múltiplo) juntos e oferecem poder preditivo superior.
Se você quiser relacionar isso com a vida real, um grupo de pessoas provavelmente tomará melhores decisões em comparação com os indivíduos, especialmente quando os membros do grupo vêm de várias origens. O mesmo vale para o aprendizado de máquina. Simplesmente, un conjunto es una técnica de aprendizagem supervisionadaO aprendizado supervisionado é uma abordagem de aprendizado de máquina em que um modelo é treinado usando um conjunto de dados rotulados. Cada entrada no conjunto de dados está associada a uma saída conhecida, permitindo que o modelo aprenda a prever resultados para novas entradas. Este método é amplamente utilizado em aplicações como classificação de imagens, Reconhecimento de fala e previsão de tendências, destacando sua importância em... para combinar múltiples alunos / modelos fracos para produzir um aprendiz forte. O modelo de montagem funciona melhor quando montamos modelos com baixa correlação.
Um bom exemplo de como os métodos de conjunto são comumente usados para resolver problemas de ciência de dados é o floresta aleatória algoritmo (que tem vários modelos CART). Funciona melhor em comparação com o modelo CART individual ao categorizar um novo objeto onde cada árvore fornece “votos” para essa classe e a floresta escolhe a classificação que tem mais votos (sobre todas as árvores da floresta). Em caso de regressão, pega a média de resultados de diferentes árvores.
Você também pode seguir esta postagem “Definir Princípios Básicos de Aprendizagem Explicados em Inglês Simples” para aprender mais sobre modelagem de conjunto.
2. O que estão ensacando, reforço e empilhamento?
Vamos examinar cada um deles individualmente e tentar entender as diferenças entre esses termos.:
Harpillera (Agregação Bootstrap) é um método definido. Primeiro, creamos muestras aleatorias del conjunto de datos de TreinamentoO treinamento é um processo sistemático projetado para melhorar as habilidades, Conhecimento ou habilidades físicas. É aplicado em várias áreas, como esporte, Educação e desenvolvimento profissional. Um programa de treinamento eficaz inclui planejamento de metas, prática regular e avaliação do progresso. A adaptação às necessidades individuais e a motivação são fatores-chave para alcançar resultados bem-sucedidos e sustentáveis em qualquer disciplina.... (subconjuntos do conjunto de dados de treinamento). Depois de, nós construímos um classificador para cada amostra. Em resumo, os resultados desses múltiplos classificadores são combinados por meio de votação por média ou maioria. O ensacamento ajuda a reduzir o erro de variância.
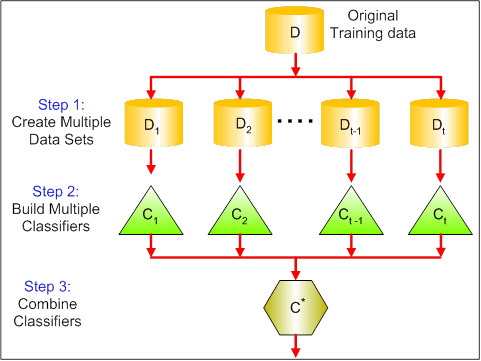
Impulso fornece aprendizagem sequencial de preditores. O primeiro preditor é aprendido em todo o conjunto de dados, enquanto o seguinte é aprendido no conjunto de treinamento com base no desempenho do anterior.. Isso comece classificando o conjunto de dados original e dando o mesmo peso a cada observação. Se as aulas forem previstas incorretamente usando o primeiro aluno, então, a observação classificada em falta recebe um peso maior. Sendo um procedimento iterativo, continua adicionando alunos do classificador até que um limite no número de modelos ou precisão seja alcançado. Impulse mostrou melhor precisão preditiva do que ensacamento, mas também tende a sobrecarregar os dados de treinamento. 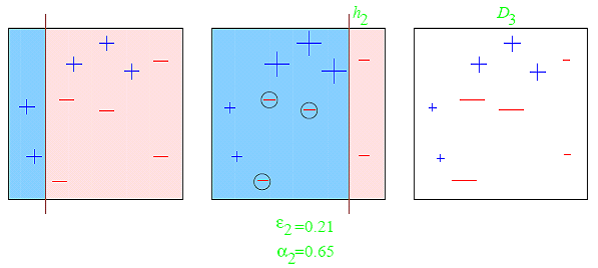
O exemplo mais comum de reforço é AdaBoost e Gradient Boosting. Você também pode verificar essas postagens para obter mais informações sobre como impulsionar algoritmos.
Empilhado funciona em duas fases. Primeiro, usamos vários classificadores de base para prever a classe. Em segundo lugar, um novo aluno é usado para combinar suas previsões a fim de reduzir o erro de generalização. 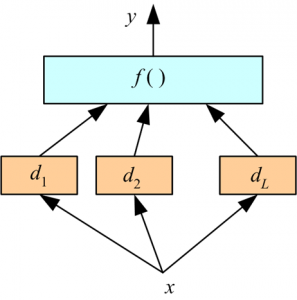
3. Podemos montar vários modelos do mesmo algoritmo de ML?
sim, podemos combinar vários modelos dos mesmos algoritmos de ML, mas combinar várias previsões geradas por diferentes algoritmos regularmente forneceria melhores previsões. É devido à diversificação ou natureza independente em relação umas às outras. Como um exemplo, as previsões de uma floresta aleatória, um KNN e um Naive Bayes podem ser combinados para criar um conjunto final de previsões mais robusto em comparação com a combinação de três modelos de floresta aleatórios. A chave para criar um conjunto poderoso é a diversidade de modelos. Um conjunto com duas técnicas de natureza muito equivalente terá um desempenho ruim do que um conjunto de modelos mais diversificado..
Exemplo: Digamos que temos três modelos (UMA, Por C). UMA, B e C têm uma precisão de previsão do 85%, 80% e 55% respectivamente. Mas A e B são considerados altamente correlacionados quando C está mal correlacionado com A e B. Devemos combinar A e B? Não, não deveríamos, porque esses modelos são altamente correlacionados. Por isso, não vamos combinar esses dois, uma vez que este conjunto não ajudará a reduzir quaisquer erros de generalização. Prefiro combinar A e C ou B e C.
4. Como podemos identificar os pesos dos diferentes modelos para o conjunto?
Um dos desafios mais comuns com a modelagem de conjunto é encontrar pesos ideais para modelos de conjunto base. Em geral, assumimos o mesmo peso para todos os modelos e pegamos a média das previsões. Mas, Esta é a melhor maneira de enfrentar este desafio?
Existem vários métodos para encontrar o peso ideal para combinar todos os alunos básicos. Esses métodos fornecem uma compreensão justa de como encontrar o peso correto. A seguir, Eu listo alguns dos métodos:
- Encontre a colinearidade entre os alunos de base e com base nesta tabela, em seguida, identifique os modelos básicos para montar. Depois disso, olhe para a pontuação de validação cruzada (relação de pontuação) dos modelos de base identificados para encontrar o peso.
- Encontre o algoritmo para retornar o peso ideal para alunos básicos. Puede consultar el post Cómo hallar pesos ótimos de aprendices de conjunto usando una neuronal vermelhoAs redes neurais são modelos computacionais inspirados no funcionamento do cérebro humano. Eles usam estruturas conhecidas como neurônios artificiais para processar e aprender com os dados. Essas redes são fundamentais no campo da inteligência artificial, permitindo avanços significativos em tarefas como reconhecimento de imagem, Processamento de linguagem natural e previsão de séries temporais, entre outros. Sua capacidade de aprender padrões complexos os torna ferramentas poderosas.. para ver el método para hallar el peso ótimo.
- Também podemos resolver o mesmo problema usando métodos como:
Você também pode ver a resposta vencedora dos concursos de ciência de dados / Kaggle para entender outros métodos para enfrentar este desafio.
5. Quais são os benefícios do modelo de conjunto?
Existem duas vantagens principais nos modelos Ensemble:
- Melhor predição
- Modelo mais estável
A opinião agregada de vários modelos é menos ruidosa do que a de outros modelos. Nas finanças, ligar “Diversificação”: una cartera mixta de muchas aciones será mucho menos variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos.... que una sola de las aciones. É também por isso que seus modelos ficarão melhores com conjuntos de modelos do que individualmente.. Uma das precauções com os modelos de conjunto é que eles se encaixam muito bem., mesmo que o ensacamento cuide disso em grande medida.
Nota final
Neste post, nós analisamos o 5 Perguntas frequentes sobre os modelos do Ensemble. Ao responder a essas perguntas, discutimos sobre "Modelos de conjunto", "Métodos de conjunto", "Por que devemos montar vários modelos?”, "Métodos para identificar o peso ideal para o conjunto" e para finalizar "Benefícios". Eu sugiro que você olhe para o 5 melhores soluções de quiz de ciência de dados e veja suas abordagens conjuntas para melhor compreensão e muita prática. Isso ajudará você a entender o que funciona e o que não.
Este post foi útil para você? Você já tentou alguma coisa para encontrar pesos ideais ou identificar o aluno base adequado?? Ficarei feliz em ouvir de você na seção de comentários abaixo..





