
Introdução
As estatísticas são o coração do aprendizado de máquina
Os métodos estatísticos são essenciais para encontrar as respostas às perguntas que pretendemos obter dos dados e são os pilares de todas as abordagens de aprendizado de máquina.
Neste artigo, Eu selecionei uma lista de 25 questões relacionadas a Estatística e probabilidade em ciência de dados.
Vamos começar com as perguntas,
Seção 1
1. Qual das seguintes relações é correta para uma distribuição distorcida negativa?
(uma) Média = Modo = Mediana
(b) meios de comunicação> Mediana> Moda
(c) Moda> Mediana> meios de comunicação
(d) meios de comunicação> Modo = Mediana
Solução: (c)
Explicação: 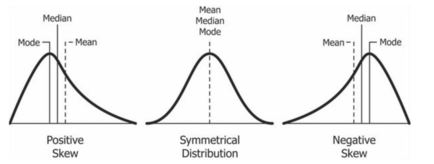
2. Na matriz de covariância simétrica:
(uma) Os elementos diagonais devem ser positivos e os outros elementos são sempre zero.
(b) Elementos diagonais nunca podem ser negativos e outros elementos são sempre positivos.
(c) Elementos diagonais nunca podem ser negativos e outros elementos podem ser negativos ou positivos.
(d) Elementos diagonais podem ser negativos e positivos e outros elementos são sempre negativos.
Solução: (c)
Explicação: Em uma matriz de covariância, as entradas diagonais representam a covariância de variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos.... consigo própria, que é igual à variância dessa variável e é calculada como o quadrado do desvio padrão. Uma vez que a variação é sempre positiva, entradas diagonais são sempre positivas.
3. A presença de outliers em um conjunto de dados não afeta:
(uma) Desvio padrão
(b) Classificação
(c) meios de comunicação
(d) Intervalo interquartil (IQR)
Solução: (d)
Explicação: O IQR é essencialmente o intervalo do 50% meio de dados. Uma vez que usa o 50% metade, não afetado por outliers.
4. Se X e Y forem variáveis aleatórias independentes, Qual dos seguintes é verdadeiro?
(uma) E (XY) = E (X) E (E) [ E representa o valor da expectativa ]
(b) o (X, E) = 0 [ Cov representa a covariância entre as variáveis ]
(c) Onde (X + E) = Var (X) + Onde (E) [ Var representa a variância ]
(Todo o interior
Solução: (d)
Explicação: Se X e Y forem independentes, entonces o (X, E) = 0 y Var (X + E) = Var (X) + Onde (E) (∵ 2Cov (X, E) = 0)
5. Para uma distribuição normal Z, Qual opção é VERDADEIRA?
(uma) Coeficiente de assimetria (E (COM3)) = 0
(b) E (COM) = 0; E (COM2) = Var (COM) = 1
(c) Curtosis (E (COM4)) = 3
(d) Sua densidade é simétrica em relação à média.
Solução: (d)
Explicação:

6. Sejam X e Y variáveis aleatórias normais com suas respectivas médias 3 e 4 e variações 9 e 16, então 2X-Y terá distribuição normal com parametroso "parametros" são variáveis ou critérios usados para definir, medir ou avaliar um fenômeno ou sistema. Em vários domínios, como a estatística, Ciência da Computação e Pesquisa Científica, Os parâmetros são essenciais para estabelecer normas e padrões que orientam a análise e interpretação dos dados. Sua seleção e manuseio adequados são cruciais para obter resultados precisos e relevantes em qualquer estudo ou projeto....:
(uma) Media = 2 e variância = 52
(b) Media = 0 e variância = 1
(c) Media = 2 e variância = 1
(ré. Nenhuma das anteriores
Solução: (d)
Sugestão: Onde(Machado + por) = a2 Onde(X) + b2 Onde(E) + 2abCov (X, E)
7. Suponha que X e Y tenham valores {0,1} e são independentes com P (X = 1) = 1/2 y P (Y = 1) = 1/3. Qual é a probabilidade de que P (X + Y = 1)?
(uma) 18/5
(b) 1/2
(c) 5/6
(d) 1/6
Solução: (b)
Explicação: P (X + Y = 1) = P (X = 0) .P (Y = 1) + P (X = 1) .P (Y = 0) = (1/2) (1/3) + (1/2) (2/3) = 1/2.
8. Sejam X e Y variáveis aleatórias com E (X) = µ / 2 e E (E) = µ, então, O que é verdade?
(uma) g = X + Y é um Estimadoro "Estimador" é uma ferramenta estatística usada para inferir características de uma população a partir de uma amostra. Ele se baseia em métodos matemáticos para fornecer estimativas precisas e confiáveis. Existem diferentes tipos de estimadores, como o imparcial e o consistente, escolhidos de acordo com o contexto e objetivo do estudo. Seu uso correto é essencial na pesquisa científica, levantamentos e análise de dados.... não enviesado de μ
(b) g = X + Y é um estimador tendencioso de μ com polarização igual a μ
(c) h = X + (E / 2) é um estimador imparcial de μ
(d) h = X + (E / 2) é um estimador tendencioso de μ com polarização igual a μ / 2
Solução: (c)
Explicação: E (g) = E (X + E) = E (X) + E (E) = 3m / 2; Tendência (g) = E (g) -μ = μ / 2
E (h) = E (X + (E / 2)) = E (X) + 1 / 2E (E) = μ, Tendência (h) = E (h) -µ = 0
9. Suponha que X tome valores entre 0 e 1 e tem a função de densidade de probabilidade (PDF) 2x, então o valor da variância de X2 isto é :
(uma) 1/12
(b) 1/18
(c) 1/6
(d) 18/5
Solução: (uma)
Sugestão: usar Var (X2) = E (X4) -(EX2))2
10. Para as variáveis aleatórias X e Y, nós temos var (X) = 1, Onde (E) = 4 y Var (2X-3Y) = 34, então a correlação entre X e Y é:
(uma) 1/2
(b) 1/4
(c) 1/3
(ré. Nenhuma das anteriores
Solução: (b)
Explicação: Onde (2X-3Y) = 34
= 4Onde (X) + 9Onde (E) -12o (X, E)
= 4 (1) +9 (4) -12o (X, E) = 34
∴ o (X, E) = 1/2
11. Um dado regular é rolado repetidamente até um número maior que 4. Se K for o número total de vezes que o dado é lançado, Então p (K = 4) É igual a:
(uma) 16/81
(b) 8/81
(c) 27/8
(d) 16/27
Solução: (b)
Explicação: P (K = 4) = (P (# Menos de 4 o igual))3.P ({4}) = (2/3)3. (1/3) = 8/81.
12. Sejam X e Y variáveis aleatórias uniformes e independentes (0, 1). Defina A = X + Y y B = XY. Mais tarde,
(uma) A e B são variáveis aleatórias independentes
(b) A e B são variáveis aleatórias não correlacionadas
(c) A e B são variáveis aleatórias uniformes (0,1).
(d) Nenhum desses
Solução: (b)
Explicação: o (X + E, XY) = O (X, X) – o (X, E) + o (E, X) – o (E, E) ⇒ Var (X) – Onde (E) = 0
13. Se g é um estimador de ponto de X, então o erro quadrático médio (MSE) para g é:
(uma) Variância (g) + Tendência (g)
(b) Variância (g) + Tendência (g2)
(c) Variância (g) + (Tendência (g))2
(d) Variância (g2) + Tendência (g)
Solução: (c)
Explicação: MSE (g) = E[ (g-X)2 ] = Var (gX) + (E[ g-X ])2 = Var (g) + (Tendência (g))2
14. Sejam X e Y duas variáveis aleatórias e seja um, b, c, d números reais, então qual das seguintes opções é FALSE?
(uma) o (X + b, E + d) = O (X, E)
(b) o (machado, cY) = ac * o (X, E)
(c) o (machado + b, cY + d) = ac * o (X, E)
(d) Corr (machado + b, cY + d) = ac * Corr (X, E) para a, c> 0
Solução: (d)
Explicação: Corr (machado + b, cY + d) = Corr (X, E)
15. Deixe X e Y juntos (bivariados) normal com Var (X) = Var (E), então:
(uma) X + Y e XY são conjuntamente normais
(b) X + Y e XY não são correlacionados
(c) X + Y e XY são independentes
(Todo o interior
Solução: (d)
Explicação: Se X e Y são a distribuição normal bivariada, então, qualquer combinação linear de X e Y também é normalmente distribuída.
16. Deixe X1, X2, X3, —, XNorte ser uma amostra aleatória de uma distribuição com E (Xeu) =μ y Var (Xeu) =.σ2 Agora, considere dois estimadores:
grama1= X1 grama2= X ‘= (X1+ X2+ X3+ ————- XNorte)/Norte
Qual desses estimadores tem um erro quadrático médio (MSE) alto?
(uma) g1
(b) g2
(c) O mesmo para ambos g1 y G2
(ré. Nenhuma das anteriores
Solução: (uma)
Explicação: MSE (g1) = E[(g1-μ)2] = E[(X1-E(X1))2] = Var (X1) = σ2
MSE (g2) = E[(g2-μ)2]= E[(X’-μ)2] = Var (X’-μ) + (E[X’-μ])2 = Var (X ‘) = σ2/Norte
17. Uma amostra aleatória de n = 6 tirado da população tem os elementos 6, 10, 13, 14, 18, 20. Então, Qual opção é falsa?
(uma) A estimativa pontual da média da população é 13,5
(b) A estimativa pontual do desvio padrão da população é 4,68
(c) A estimativa pontual do desvio padrão da população é 3,5
(d) A estimativa pontual do erro padrão da média é 1,91
Solução: (c)
Explicação: População média (X ‘) = (Σ Xeu/ n) = 13,5
Desvio padrão da população (S) = sqrt ((Σ Xeu2/ n) – (Σ Xeu/Norte)2 ) = 4,68
Erro padrão da média = S / sqrt (n) = 4.68 / sqrt (6) = 1.91
Seção 2
18. Verdadeiro ou falso: se a correlação de Pearson entre 2 variáveis é zero, então eles são necessariamente independentes.
Solução: Falso
Explicação: Correlação é uma medida de dependência linear entre variáveis.
19. Verdadeiro ou falso: Seja g um estimador imparcial de X e U uma variável aleatória com médias zero, então h = g + você também é imparcial para X.
Solução: Verdade.
Explicação: E (h) = E (g) + E (você) = 0 + 0 = 0 ( ∵ E (g) = 0 devido ao estimador imparcial)
20. Verdadeiro ou falso: Sejam X e Y duas variáveis aleatórias normais padrão independentes e T = XY2+ X + 1 y P = X-3, luego Cov (T, P) = 1
Solução: Falso.
Sugestão: Use as propriedades mencionadas na pergunta 14.
21. Verdadeiro ou falso: Deixe X ter uma distribuição normal com parâmetros μ e σ2, então X2 segue uma distribuição qui-quadrado com o parâmetro 1.
Solução: Falso.
Explicação: Para que a afirmação dada seja verdadeira, X deve ser uma distribuição normal padrão (µ = 0, σ2= 1)
22. Verdadeiro ou falso: Se a função característica de uma variável aleatória existe, então também haverá sua expectativa e variação.
Solução: Falso.
Sugestão: função geradora de momento (MGF)
23. Verdadeiro ou falso: Seja X uma distribuição uniforme U (uma, b) tal que E (X) = 2 y Var (X) = 3/4, Então p (X <1) = 1/6.
Solução: Verdade.
Explicação: E (X) = (uma + b) / 2 = a + b = 4; Onde (X) = (BA)2/ 12 = (BA) = 3 ⇒ X~ U (0,5, 3,5)
24. Verdadeiro ou falso: O coeficiente de correlação entre X + Y y XY, onde X e Y são variáveis aleatórias independentes com variâncias 36 e 16, respectivamente, isto é 6/13.
Solução: Falso.
Explicação: Corr (X + E, XY) = O (X + E, XY) / Std (X + E) .Std (XY) [Std = Desvio Padrão]
25. Verdadeiro ou falso: na estimativa de intervalo, Conforme o nível de confiança aumenta, a margemMargem é um termo usado em uma variedade de contextos, como contabilidade, Economia e impressão. Em contabilidade, refere-se à diferença entre receitas e custos, que permite avaliar a rentabilidade de um negócio. No domínio da publicação, A margem é o espaço em branco ao redor do texto em uma página, que facilita a leitura e proporciona uma apresentação estética. Seu correto manejo é essencial.. o erro diminui.
Solução: Falso.
Explicação: O intervalo de confiança é definido como X ± Z (s /√n)
Notas finais
Obrigado pela leitura!
Espero que você tenha gostado das perguntas e tenha sido capaz de colocar seu conhecimento de estatística e probabilidade à prova em ciência de dados..
Se gostou e quer saber mais, visite meus outros artigos sobre ciência de dados e aprendizado de máquina clicando no link
Sinta-se à vontade para entrar em contato comigo em Linkedin, Correio eletrônico.
Qualquer coisa não mencionada ou você deseja compartilhar suas idéias? Sinta-se à vontade para comentar abaixo e eu entrarei em contato com você.
Sobre o autor
Chirag Goyal
Atualmente, Estou cursando bacharelado em tecnologia (B.Tech) em Ciência da Computação e Engenharia da Instituto Indiano de Tecnologia de Jodhpur (IITJ). Estou muito animado com o aprendizado de máquina, a aprendizado profundoAqui está o caminho de aprendizado para dominar o aprendizado profundo em, Uma subdisciplina da inteligência artificial, depende de redes neurais artificiais para analisar e processar grandes volumes de dados. Essa técnica permite que as máquinas aprendam padrões e executem tarefas complexas, como reconhecimento de fala e visão computacional. Sua capacidade de melhorar continuamente à medida que mais dados são fornecidos a ele o torna uma ferramenta fundamental em vários setores, da saúde... e inteligência artificial.
A mídia mostrada neste artigo não é propriedade da DataPeaker e é usada a critério do autor.





