
Requisitos anteriores: Linguagem de programação R básica e conhecimento básico de classificação
Enquanto a abordagem do conjunto de validação funciona dividindo o conjunto de dados uma vez, K-Fold faz isso cinco ou dez vezes. Imagine que você está fazendo a abordagem do conjunto de validação dez vezes usando um conjunto de dados diferente.
Digamos que temos 100 linhas de dados. Nós os dividimos aleatoriamente em dez grupos de dobras. Cada dobra consistirá em cerca de 10 linhas de dados. A primeira dobra será usada como o conjunto de validação e o resto é para o TreinamentoO treinamento é um processo sistemático projetado para melhorar as habilidades, Conhecimento ou habilidades físicas. É aplicado em várias áreas, como esporte, Educação e desenvolvimento profissional. Um programa de treinamento eficaz inclui planejamento de metas, prática regular e avaliação do progresso. A adaptação às necessidades individuais e a motivação são fatores-chave para alcançar resultados bem-sucedidos e sustentáveis em qualquer disciplina..... Em seguida, treinamos nosso modelo usando este conjunto de dados e calculamos a precisão ou perda. Em seguida, repetimos esse processo, mas usando uma dobra diferente para o conjunto de validação. Veja a foto abaixo.
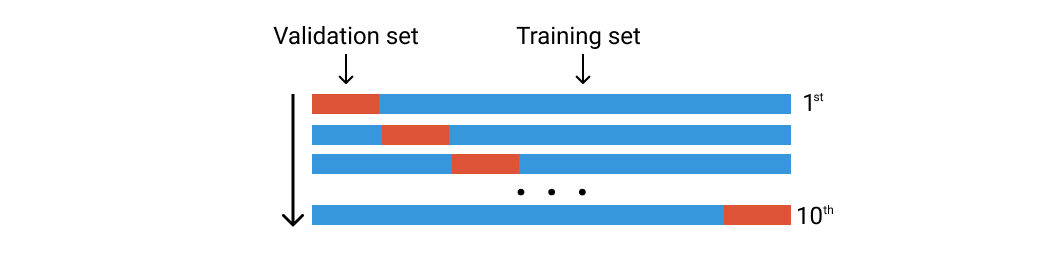
Validação cruzada de K-Fold. Imagem do Autor
Vamos pular para o código
As bibliotecas que usamos são essas duas:
biblioteca(tidyverse)
biblioteca(acento circunflexo)
Os dados usados aqui são dados de doenças cardíacas da UTI que podem ser baixados em Kaggle. Você também pode usar quaisquer dados de classificação para este experimento.
dados <- read.csv("../input / heart-disease-uci / heart.csv")
cabeça(dados)
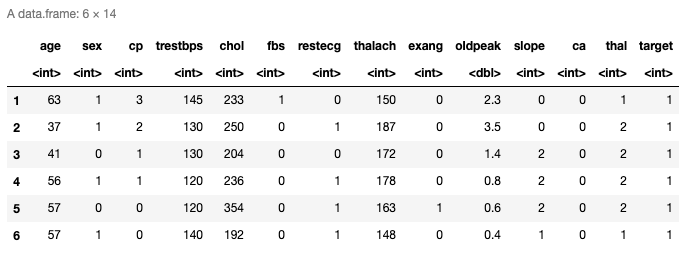
Aqui estão as seis primeiras linhas dos dados carregados. Tem treze preditores e a última coluna é o variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos.... Resposta. Você também pode verificar as últimas linhas usando a função cauda ().
Distribuição de dados
Aqui, queremos confirmar que a distribuição entre os dados de dois rótulos não é muito diferente. Porque conjuntos de dados desequilibrados podem levar a precisão desequilibrada. Isso significa que seu modelo sempre fará previsões para um único rótulo., ou sempre irá prever 0 o 1.
hist(data $ target,col ="coral")
prop.table(tabela(data $ target))
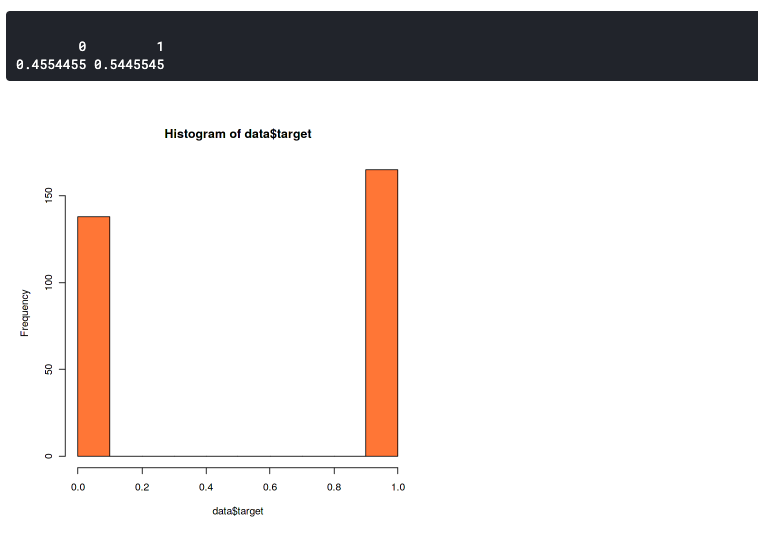
Este gráfico mostra que nosso conjunto de dados está um pouco desequilibrado, mas ainda é bom o suficiente. Tem uma proporção de 46:54. Você deve começar a se preocupar se o seu conjunto de dados for mais do que 60% dos dados em uma classe. Nesse caso, você pode usar o SMOTE para lidar com um conjunto de dados desequilibrado.
O k-fold
set.seed(100)
trctrl <- trainControl(método = "cv", numero = 10, savePredictions = TRUE)
nb_fit <- Comboio(fator(alvo) ~., dados = dados, método = "Baías ingénuas", trControl = trctrl, tuneLength = 0)
nb_fit
A primeira linha é para definir a semente do pseudo-aleatório para que o mesmo resultado possa ser reproduzido. Você pode usar qualquer número para o valor inicial.
A seguir, podemos definir a configuração k-Fold na função trainControl (). Defina o parâmetro do método como "cv" e o parâmetro numérico como 10. Isso significa que definimos a validação cruzada com dez dobras. Podemos definir o número da dobra com qualquer número, mas a maneira mais comum é configurá-lo para cinco ou dez.
A função do trem () é usado para determinar o método que usamos. Aqui, usamos o método Naive Bayes e definimos tuneLength como zero porque nos concentramos em avaliar o método em cada dobra. Também podemos definir tuneLength se quisermos fazer com que o parametroso "parametros" são variáveis ou critérios usados para definir, medir ou avaliar um fenômeno ou sistema. Em vários domínios, como a estatística, Ciência da Computação e Pesquisa Científica, Os parâmetros são essenciais para estabelecer normas e padrões que orientam a análise e interpretação dos dados. Sua seleção e manuseio adequados são cruciais para obter resultados precisos e relevantes em qualquer estudo ou projeto.... durante a validação cruzada. Por exemplo, se usarmos o método K-NN e quisermos analisar quantos K são os melhores para o nosso modelo.
Você pode ver o método suportado em Documentação R.
Observe que a validação cruzada de k-Fold pode demorar um pouco porque você executa o processo de treinamento dez vezes.
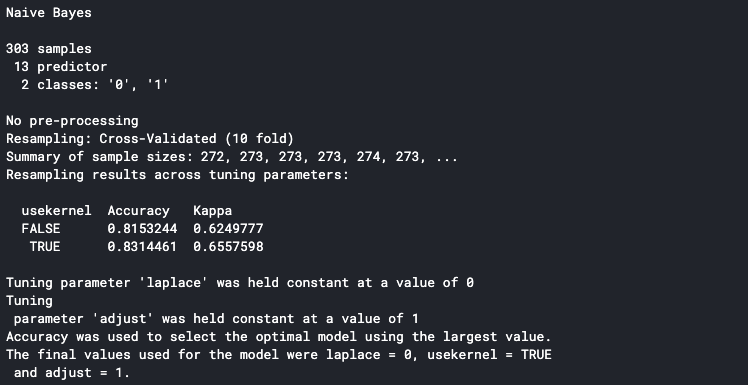
Irá imprimir os detalhes na consola assim que terminar. A precisão exibida no console é a precisão média de todas as dobras de treinamento. Podemos ver que nosso modelo tem uma precisão média de 83%.
Desdobre o k-fold
Podemos determinar que nosso modelo está funcionando bem em cada dobra se observarmos a precisão de cada dobra.. Para fazer isso, certifique-se de configurar o salvarPendisões parâmetro para TRUE na função trainControl ().
pred <- nb_fit$pred
pred$equal <- ifelse(pred $pred == pred$obs, 1,0)
cada vezes <- antes %>%
  group_by(Resample) %>%
  summarise_at(Vars(igual),
               Lista(Precisão = média))
cada vezes
Aqui está a mesa de precisão em cada dobra.
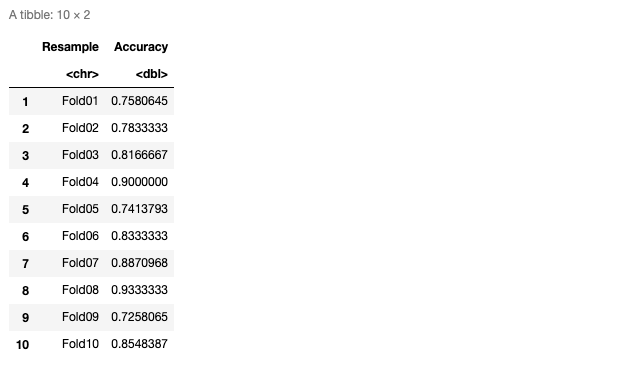
Também podemos plotá-lo no gráfico para facilitar a análise. Neste caso, usamos o gráfico de caixa para representar nossas precisões.
ggplot(data = eachfold, aes(x = Reamostrar, y = precisão, grupo = 1)) +
geom_boxplot(color ="marrom") +
geom_point() +
theme_minimal()
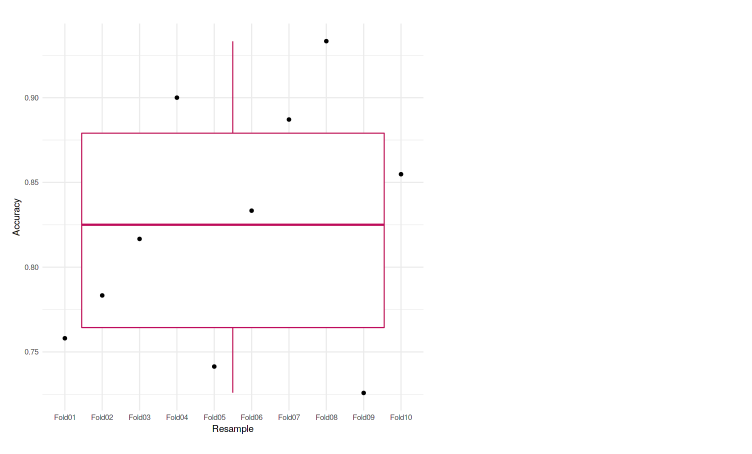
Podemos ver que cada uma das dobras atinge uma precisão que não difere muito uma da outra. A menor precisão é 72,58%, e também no box plot, nós não vemos outliers. O que significa que nosso modelo estava funcionando bem na validação cruzada de k vezes.
Que segue
- Experimente um número diferente de dobras
- Faça uma configuração de parâmetro
- Use outros conjuntos de dados e métodos
Breve biografia do autor
Chamo-me Muhammad Arnaldo, um entusiasta do aprendizado de máquina e ciência de dados. Atualmente é estudante de mestrado em ciência da computação na Indonésia.
A mídia mostrada neste artigo não é propriedade da DataPeaker e é usada a critério do autor.





