
Este artigo foi publicado como parte do Data Science Blogathon.
Introdução
Os principais objetivos da validação de um modelo incluem testar a solidez conceitual do modelo e o ajuste contínuo ao propósito., incluindo a identificação de potenciais riscos e limitações. Esses testes devem constituir um desafio efetivo ao modelo de produção existente em benefício de seu aprimoramento., mitigação de risco. Os dados para este exercício são retirados de aqui.
Estrutura de validação
Os seguintes testes foram realizados para validar os resultados do modelo:
- Variáveis de modelo: 4, linearidade e VIF
- 3. Ajuste do modelo: gráficos AUROC, Gini, KS e ganho e elevação
- 4. Testes de modelo: análise sensitiva
- 5. Coeficiente de estabilidade: estabilidade do sinal e estabilidade do coeficiente
2.1 Verificações de dados
Variáveis dependentes
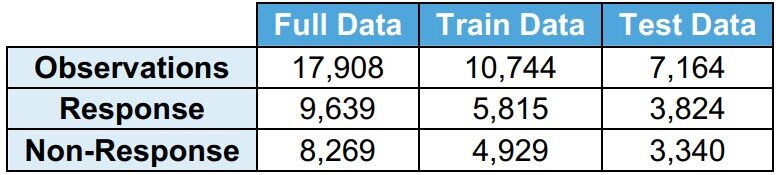
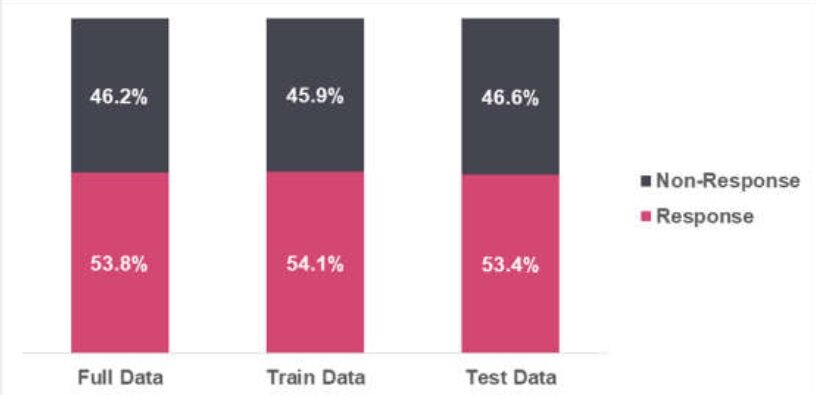
Observa-se que a distribuição da resposta (Y = 1) e nenhuma resposta (Y = 0) é muito semelhante entre dados completos, dados de trem e dados de teste.
· A resposta (Y = 1) indica que o requerente solicitou o empréstimo
· Sem resposta (Y = 0) indica que o requerente não solicitou o empréstimo
Variáveis independentes
Variáveis independentes incluem informações pessoais e financeiras. Pontuações de risco são usadas para desenvolver o modelo. Existem 5 variáveis independentes no modelo.
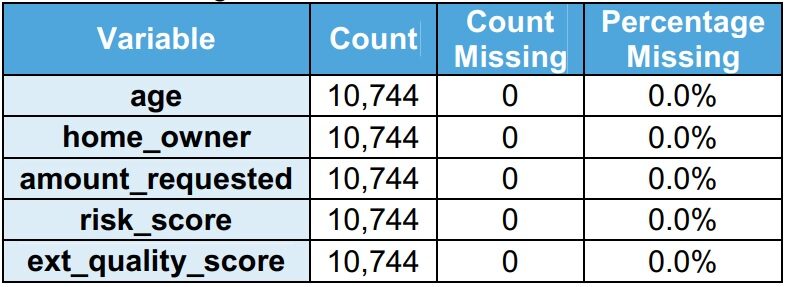
Observa-se que não há valores ausentes no conjunto de dados do trem.
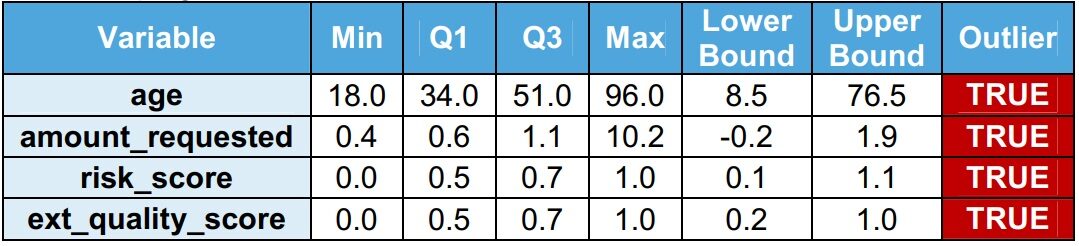
Observa-se que existem outliers no conjunto de dados do trem. O intervalo entre os quartis (IQR = Q3 – T1) é usado para identificar os pontos de venda. Outliers são valores maiores que o limite superior (T1 + 1,5 x IQR) ou valores inferiores ao limite inferior (T1 – 1,5 x IQR). A equipe de validação recomenda que os outliers sejam tratados antes de desenvolver o modelo.
2.2. Variáveis de modelo
Valor da informação (4)
de statsmodels.stats.outliers_influence import variance_inflation_factor
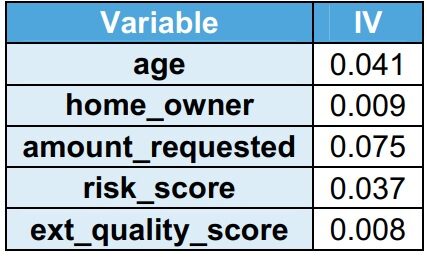
O poder explicativo de o variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos.... captura-se através de IV. Conforme o poder explicativo da variável aumenta, aumenta IV. Observa-se que todas as variáveis possuem IV <0.1, indicando que eles têm baixo poder explicativo no conjunto de dados do trem.
Linearidade
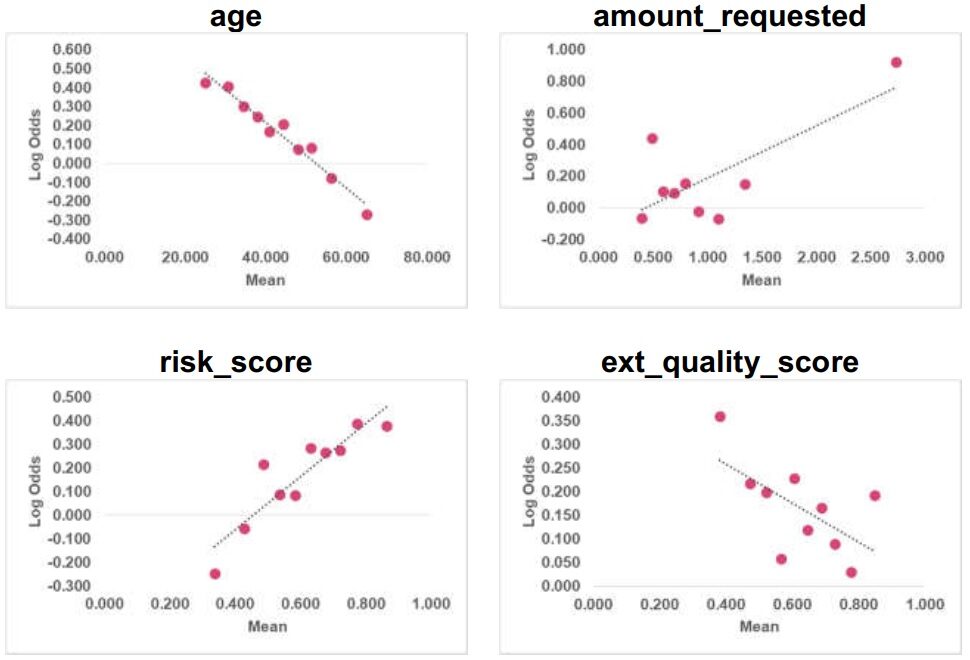
Paso 1: faço 10 recipientes para cada variável numérica
Paso 2: para cada intervalo, calcule a média da variável e as probabilidades de log correspondentes
A linearidade das variáveis numéricas é verificada (era, quantidade solicitada, risco_score e qualidade_score_ ext) nos dados do trem. Se observa que age & risco_score son lineales y amount_requested & ext_quality_score sem filho lineales. A equipe de validação recomenda que as transformações sejam testadas para obter uma relação linear.
Fator de informação de variância (VIVAZ)
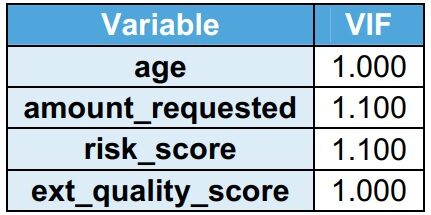
VIF indica multicolinearidade entre variáveis independentes. Observa-se que seu VIF é menor que 2 no conjunto de dados de TreinamentoO treinamento é um processo sistemático projetado para melhorar as habilidades, Conhecimento ou habilidades físicas. É aplicado em várias áreas, como esporte, Educação e desenvolvimento profissional. Um programa de treinamento eficaz inclui planejamento de metas, prática regular e avaliação do progresso. A adaptação às necessidades individuais e a motivação são fatores-chave para alcançar resultados bem-sucedidos e sustentáveis em qualquer disciplina..... VIF menor que 2 indica sem multicolinearidade. Home_owner é uma bandeira, portanto, não considerado para VIF.
2.3 Ajuste do modelo
AU-ROC
sklearn.metrics.auc(x, e)
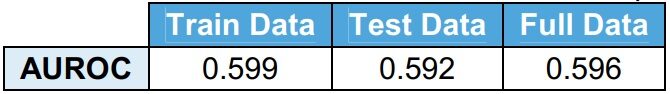
A área sob a curva do operador do receptor (AUROC) é usado para medir o poder preditivo do modelo. AUROC = 0,50 indica que não há poder preditivo e AUROC = 1,00 indica poder preditivo perfeito. O modelo desenvolvido com dados de trem é executado com dados de teste e dados completos. Observa-se que não há desvio significativo nos valores AUROC.
Observa-se que AUROC é menor que 0,6. Isso indica que o modelo não possui um bom poder preditivo.. A equipe de validação recomenda o uso de variáveis adicionais para melhorar o ajuste do modelo..
Gini
Fórmula: Gini = 2 x AUROC – 1
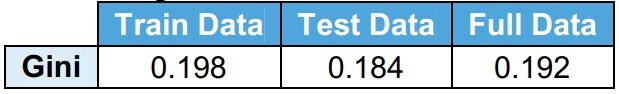
Gini se deriva de AUROC. Gini = 0.0 indica que não há poder preditivo e Gini = 1.0 indica poder preditivo perfeito. O modelo desenvolvido com dados de trem é executado com dados de teste e dados completos. Observa-se que não há desvio significativo nos valores de Gini.
Kansas
scipy.stats.ks_2samp
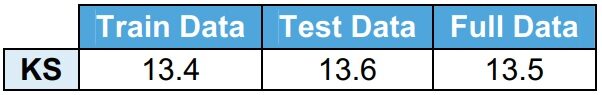
O teste de Kolmogorov-Smirnov (KS) mede a separação entre a% cumulativa de eventos e a% cumulativa de nenhum evento. Observa-se que as estatísticas dos testes KS são menores que 40, o que indica que o modelo não é capaz de separar eventos e não eventos.
Gráficos de ganho e elevação
Paso 1: Calcule a probabilidade de cada observação.
Paso 2: Classifique essas probabilidades em ordem decrescente.
Paso 3: Construa decis com cada grupo tendo quase o 10% das observações.
Paso 4: Calcule a taxa de resposta em cada decil para o bem (respondentes), Um pouco (não respondentes) e total.
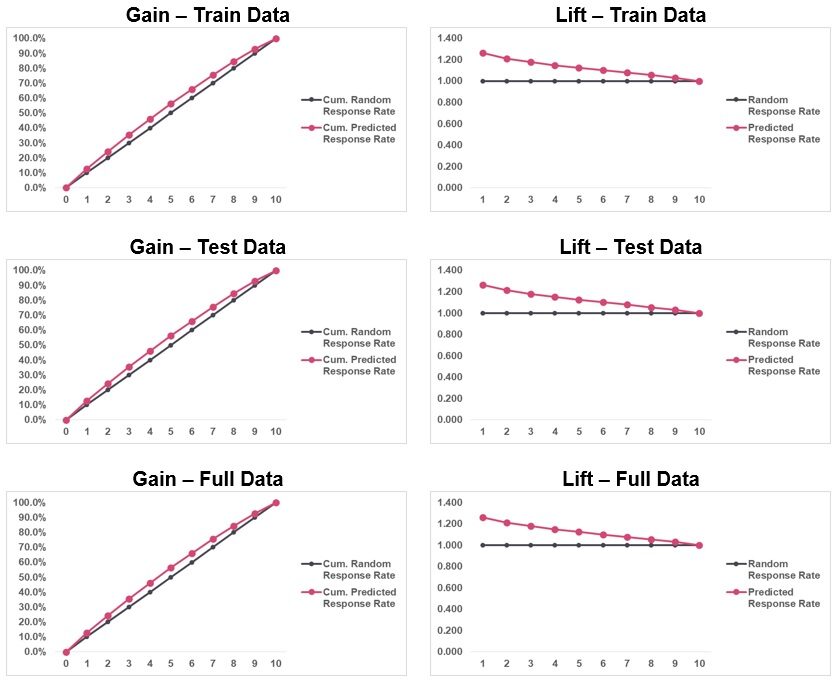
Os gráficos de ganho e elevação são ferramentas de visualização de dados que comparam a capacidade do classificador de capturar a taxa de resposta. Observa-se que a taxa de resposta cumulativa prevista é muito próxima da taxa de resposta aleatória cumulativa. Indica que o modelo tem baixo poder preditivo. A equipe de validação recomenda o uso de variáveis adicionais para melhorar o ajuste do modelo..
2.4 Testes de modelo
Análise sensitiva
Paso 1: normalizar todas as variáveis
Paso 2: execute a regressão logística entre a variável dependente e a primeira
Paso 3: execute a regressão logística entre a variável dependente e a segunda
Paso 4: repita o passo anterior para o resto das variáveis
Paso 5: o coeficiente da variável indica a sensibilidade entre a variável e as probabilidades logarítmicas da variável dependente
A sensibilidade do modelo em relação às variáveis numéricas independentes é testada. A sensibilidade é verificada nos dados do trem. O objetivo deste exercício é identificar as variáveis mais sensíveis. Observa-se que idade e risk_score são as variáveis mais sensíveis e ext_quality_score é a variável menos sensível.

2.5. Estabilidade do coeficiente
Estabilidade do coeficiente
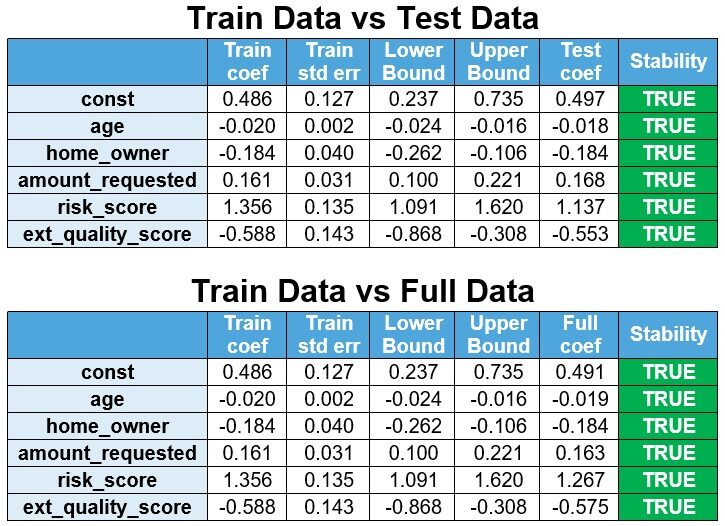
O modelo é reestimado a partir dos dados de teste e os dados completos e os coeficientes são comparados com os dados do trem. Se os coeficientes do modelo reestimado estão dentro do intervalo de confiança do 95% (Coeficiente de trem ± 1,96 x Err std de tren), então os coeficientes são estáveis.
O limite inferior é definido como Train Coef – 1,96 x Erro padrão do trem e o limite superior é definido como Coef do trem + 1,96 x Err std de tren. Observa-se que os coeficientes são estáveis.
Estabilidade de sinal
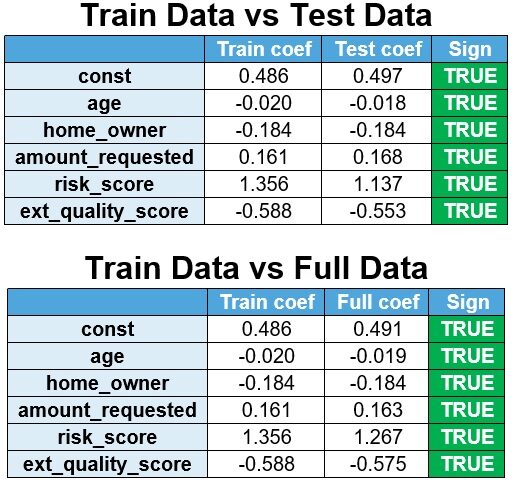
O modelo é reestimado a partir dos dados de teste e os dados completos e os coeficientes são comparados com os dados do trem.
Os sinais são observados como estáveis.
conclusão
A validação encontrou que o modelo é estável. Porém, três descobertas sérias foram levantadas:
· Encontrando 1 (dados de entrada) – Observa-se que existem outliers no conjunto de dados do trem. A equipe de validação recomenda que os outliers sejam tratados antes de desenvolver o modelo.
· Encontrando 2 (dados de entrada) – Se observa que amount_requested & ext_quality_score sem filho lineales. A equipe de validação recomenda que as transformações sejam testadas para obter uma relação linear.
· Resultado 3 (ajuste do modelo) – AUROC é observado como baixo, Gini está baixo e KS está baixo, o que indica que o modelo não é capaz de separar eventos e não eventos. A equipe de validação recomenda o uso de variáveis adicionais para melhorar o ajuste do modelo..
A mídia mostrada neste artigo não é propriedade da DataPeaker e é usada a critério do autor.





