
Esta postagem foi lançada como parte do Data Science Blogathon
Introdução
Teoria da decisão bayesiana refere-se à abordagem estatística baseada na quantificação de trade-offs entre várias decisões de classificação com base no conceito de probabilidade (Teorema de Bayes) e os custos associados à decisão.
É simplesmente uma técnica de classificação que envolve o uso do Teorema de Bayes que é usado para encontrar as probabilidades condicionais.
Sobre Acreditação de padrões estatísticos, vamos nos concentrar nas propriedades estatísticas dos padrões que geralmente são expressos em densidades de probabilidade (pdf e pmf), e isso atrairá a maior parte de nossa atenção neste post e tentará desenvolver os argumentos da teoria da decisão Bayesiana.
Pré-requisitos
VariávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos.... Aleatório
Uma variável aleatória é uma função que atribui um conjunto viável de resultados a alguns valores, como jogar uma moeda e obter o lado H como 1 e a cauda em T como 0, Onde 0 e 1 eles são variáveis aleatórias.
Teorema de Bayes
A probabilidade condicional de A dado B, representada por P (UMA | B) é a probabilidade de que A ocorra dado que B ocorreu.
P (UMA | B) = P (UMA, B) / P (B) o
Ao usar a regra da cadeia, isso também pode ser escrito como:
P (UMA, B) = P (UMA | B) P (B) = P (B | UMA) P (UMA)
P (UMA | B) = P (B | UMA) P (UMA) / P (B) ——- (1)
Onde, P (B) = P (B, UMA) + P (B, UMA ') = P (B | UMA) P (UMA) + P (B | UMA') P (UMA ')
Aqui, A equação (1) é conhecido como Teorema da probabilidade de Bayes
Nosso objetivo é explorar cada um dos componentes incluídos neste teorema. Vamos explorar passo a passo:
(uma) Anterior ou Estado de Natureza:
- As probabilidades anteriores representam a probabilidade de cada classe ocorrer.
- Os itens acima são conhecidos antes do procedimento de treinamento.
- O estado de natureza é uma variável aleatória P (Ceu).
- Se houver apenas duas classes, então a soma do acima é P (C1) + P (C2) = 1, se as aulas são exaustivas.
(b) Probabilidades condicionais de classe:
- Representa a probabilidade de que uma característica x ocorra dado que pertence a uma classe particular. É denotado por, P (X | UMA) onde x é uma característica particular
- É a probabilidade da probabilidade de que a característica x ocorra dado que pertence à classe weu.
- As vezes, também é conhecido como Probabilidade.
- É a quantidade que devemos examinar enquanto treinamos os dados. Ao longo do TreinamentoO treinamento é um processo sistemático projetado para melhorar as habilidades, Conhecimento ou habilidades físicas. É aplicado em várias áreas, como esporte, Educação e desenvolvimento profissional. Um programa de treinamento eficaz inclui planejamento de metas, prática regular e avaliação do progresso. A adaptação às necessidades individuais e a motivação são fatores-chave para alcançar resultados bem-sucedidos e sustentáveis em qualquer disciplina...., nós temos a entrada (caracteristicas) X rotulado para a respectiva classe w e calculamos a probabilidade de ocorrência desse conjunto de características dado o rótulo da classe.
(c) Provas:
- É a probabilidade de que uma característica particular ocorra, Em outras palavras P (X).
- Pode ser calculado usando a regra da cadeia como, P (X) = Σsobre P (X | Ceu) P (Ceu)
- Como precisamos da probabilidade de probabilidade condicional da classe, além disso, os valores de evidência são calculados ao longo do treinamento.
(d) Probabilidades posteriores:
- É a probabilidade de que a classe A ocorra quando certas características ocorrem.
- É o que pretendemos calcular na fase de teste em que temos entrada de teste ou características (a entidade dada) e temos que descobrir qual é a probabilidade de o modelo treinado poder prever recursos que pertencem à classe particular weu.
Para uma melhor compreensão da teoria acima, nós consideramos um exemplo
Descrição do problema
Suponha que temos uma declaração de um obstáculo de classificação em que temos que categorizar entre o objeto 1 e o objeto 2 com o determinado conjunto de características. X = [x1, x2, …, xn]T.
objetivo
O principal objetivo de projetar tal classificador é sugerir ações quando apresentado com características invisíveis., Em outras palavras, um objeto ainda não visto, Em outras palavras, não em dados de treinamento.
Neste exemplo, w denota o estado de natureza com w = w1 para objeto-1 e w = w2 para objeto-2. Aqui, precisamos saber que na verdade, o estado de natureza é tão imprevisível que em geral consideramos que aquele que é descrito probabilisticamente era variável.
Anteriores
- Geralmente, assumimos que existe algum valor anterior P (C1) que o próximo objeto é objeto-1 e P (C2) que o próximo objeto é o objeto-2. Se não tivermos outro objeto como este problema, então a soma dos anteriores é 1, Em outras palavras, o acima é exaustivo.
- As probabilidades anteriores refletem o conhecimento prévio da probabilidade de obtermos o objeto 1 e o objeto 2. Depende do domínio, já que o anterior pode mudar de acordo com a época do ano em que é detectado.
Parece um pouco estranho e ao julgar vários objetos (como em um cenário mais realista) torna essa regra de decisão estúpida, pois sempre tomamos a mesma decisão com base na principal anterior, embora saibamos que qualquer outro tipo de objetivo também pode aparecer governado pelo excesso de probabilidades anteriores (uma vez que o acima é de natureza exaustiva).
Considere os seguintes cenários diferentes:
- E P (ω1) >>> P (ω2), nossa decisão em favor de ω1 estará correto na maioria das vezes que prevemos.
- Mas sim P (ω1) = P (ω2), meios prováveis de nossa previsão estarem corretos. Em geral, a probabilidade de erro é o mínimo de P (ω1) y P (ω2), e mais tarde neste post, veremos que, nessas condições, nenhuma outra regra de decisão pode produzir uma probabilidade maior de ser correta.
Procedimento de extração de recursos (Extrair recurso de imagens)
Um conjunto de recursos sugeridos Grande, largura, alternativas para um objetoetc.
Em nosso exemplo, nós usamos o largura x, Qual é mais discriminatório para conduzir a regra de decisão do nosso classificador. Os diferentes objetos irão produzir diferentes leituras de largura variável e em geral vemos essa variabilidade em termos probabilísticos e também consideramos que x é uma variável aleatória contínua cuja distribuição depende do tipo de objeto. Cj, e é expresso como p (x | ωj) (função de distribuição de probabilidade pdf como uma variável contínua) e conhecida como função de densidade de probabilidade condicional de classe. Por isso,
O pdf p (x | ω1) é a função de densidade de probabilidade para a característica x dado que o estado da natureza é ω1 e a mesma interpretação para p (x | C2).
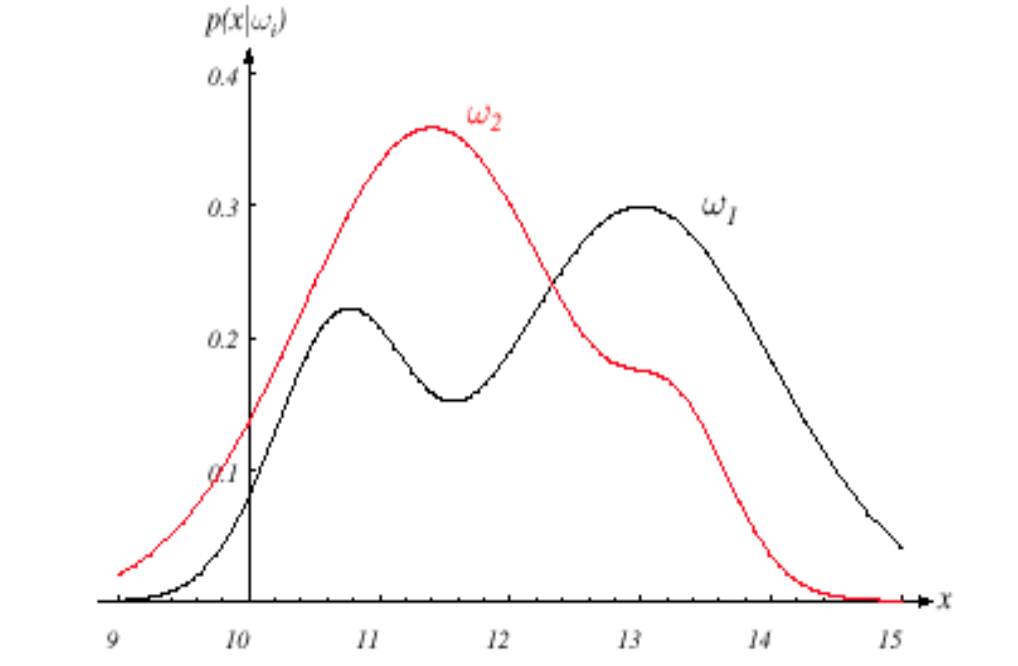
FIG. Imagem mostrando pdf para ambas as classes
Fonte da imagem: Imagens do google
Suponha que conheçamos bem as probabilidades anteriores P (ωj) e as densidades condicionais p (x | ωj). Agora, podemos chegar à fórmula de Bayes para encontrar probabilidades posteriores:
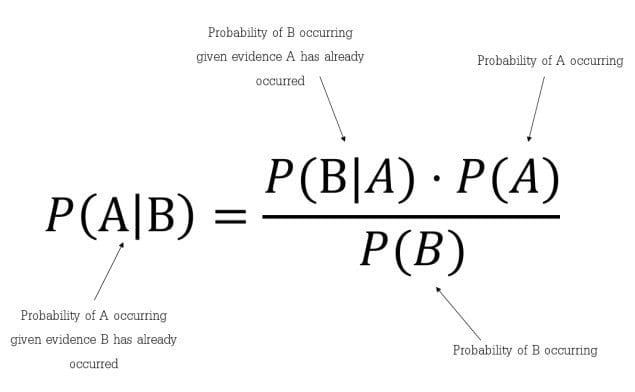
FIG. Fórmula do teorema de Bayes
Fonte da imagem: Imagens do google
A fórmula de Bayes nos dá a intuição de que, observando a medida de x, podemos converter o P (ωj) para mais tarde, denotado por P (ωj| x) que é a probabilidade de ωj uma vez que o valor característico x foi medido.
p (x | ωj) é conhecido como a probabilidade de ωj com respeito ao machado.
O fator de evidência, p (x), funciona simplesmente como um fator de escala garantindo que as probabilidades posteriores somam um para todas as classes.
Regra de decisão de Bayes
A regra de decisão dada as probabilidades posteriores é a próxima
E P (C1| x)> P (C2| x) decidiríamos que o objeto pertence à classe w1, ou outra classe w2.
Probabilidade de erro
Para justificar nossa decisão, nós olhamos para a probabilidade de erro, contanto que observemos x, tenho,
P (erro | x) = P (C1| x) se decidirmos w2, e P (C2| x) se decidirmos w1
Como eles são exaustivos e se escolhermos a natureza correta de um objeto pela probabilidade P, então a probabilidade restante (1-P) mostrará quão provável é a decisão de que não seja o objeto decidido.
Podemos minimizar a probabilidade de erro, decidindo qual deles tem um posterior maior e o restante, uma vez que a probabilidade de erro será o mínimo viável. Portanto, para terminar, temos
P (erro | x) = min [P(ω1|x),P(ω2|x)]
E nossa decisão de Bayes rege como,
Elegir ω1 e P (ω1| x)> P (ω2| x); caso contrário, decida ω2
Este tipo de regra de decisão destaca o papel das probabilidades posteriores. Com a ajuda do teorema de Bayes, podemos expressar a regra em termos de probabilidades anteriores e condicionais.
A evidência é irrelevante no que diz respeito à decisão. Como comentamos anteriormente, funciona simplesmente como um fator de escala que indica a frequência com a qual iremos medir a característica com o valor x; assegura P (ω1| x) + P (ω2| x) = 1.
Então, excluindo o fator de escala não exigido em nossa regra de decisão, temos a regra de decisão semelhante do teorema de Bayes como,
Elegir ω1 e P (x | ω1) P (ω1)> p (x | ω2) P (ω2); caso contrário, decida ω2
Agora, vamos considerar 2 casos:
- Caso 1: Se as condicionais de classe forem iguais, Em outras palavras, p (x | ω1) = p (x | ω2), chegamos então à nossa regra de decisão prematura governada apenas por a priori.
- Caso 2: Por outro lado, se o acima for o mesmo, Em outras palavras, P (ω1) = P (ω2) então a decisão é inteiramente baseada em condicionais da classe p (x | ωj).
Isso completa nossa formulação de exemplo!!
Generalização das idéias acima para várias classes e características
Classificação bayes: posterior, verossimilhança, anterior e evidência
P (Ceu | X) = P (X | Ceu) P (Ceu) / P (X)
Posterior = Probabilidade * Anterior / Provas
Agora vamos discutir os casos que têm várias características, bem como várias classes,
Deixe que vários recursos sejam X1, X2, … XNorte e várias classes são C1, C2,… CNorte, depois de:
P (Ceu | X1,…. XNorte) = P (X1,…. , XNorte| Ceu) * P (Ceu) / P (X1,… XNorte)
Onde,
Posterior = P (Ceu | X1,…. XNorte)
Probabilidade = P (X1,…. , XNorte| Ceu)
Anterior = P (Ceu)
Provas = P (X1,… ,XNorte)
Em casos dos mesmos padrões de entrada, podemos precisar usar uma função de custo drasticamente diferente, o que levará a ações absolutamente diferentes. Geralmente, diferentes tarefas de decisão podem exigir características e limites de desempenho bastante diferentes daqueles úteis para nosso problema de categorização original.
Então, em postagens subsequentes, vamos discutir o Função de custo, Análise de risco, e Ação decisiva o que ajudará a entender melhor a teoria de decisão de Bayes.
Notas finais
Obrigado pela leitura!
Se você gostou e quer saber mais, visite minhas outras postagens sobre ciência de dados e aprendizado de máquina clicando no Ligação
Sinta-se à vontade para entrar em contato comigo em Linkedin, O email.
Qualquer coisa não mencionada ou você deseja compartilhar suas idéias? Sinta-se à vontade para comentar abaixo e eu entrarei em contato com você.
Sobre o autor
Chirag Goyal
Hoje em dia, Estou cursando bacharelado em tecnologia (B.Tech) em Ciência da Computação e Engenharia da Instituto Indiano de Tecnologia de Jodhpur (IITJ). Estou muito animado com o aprendizado de máquina, a aprendizado profundoAqui está o caminho de aprendizado para dominar o aprendizado profundo em, Uma subdisciplina da inteligência artificial, depende de redes neurais artificiais para analisar e processar grandes volumes de dados. Essa técnica permite que as máquinas aprendam padrões e executem tarefas complexas, como reconhecimento de fala e visão computacional. Sua capacidade de melhorar continuamente à medida que mais dados são fornecidos a ele o torna uma ferramenta fundamental em vários setores, da saúde... e inteligência artificial.
A mídia mostrada nesta postagem não é propriedade da DataPeaker e é usada a critério do autor.





