
Este artigo foi publicado como parte do Data Science Blogathon.
O algoritmo Random Forest é sem dúvida um dos algoritmos mais populares entre os cientistas de dados.. Funciona muito bem em problemas de classificação e regressão. Random Forest é conhecido como uma técnica de conjunto porque é uma coleção de múltiplas árvores de decisão.
Qual era o objetivo principal de usar várias árvores de decisão?
Usar uma única árvore de decisão tem várias desvantagens. Quando usamos uma única árvore de decisão para resolver uma declaração de problema, encontramos uma situação de baixo viés e alta variância. Quer dizer, a árvore irá capturar toda a informação sobre os dados de TreinamentoO treinamento é um processo sistemático projetado para melhorar as habilidades, Conhecimento ou habilidades físicas. É aplicado em várias áreas, como esporte, Educação e desenvolvimento profissional. Um programa de treinamento eficaz inclui planejamento de metas, prática regular e avaliação do progresso. A adaptação às necessidades individuais e a motivação são fatores-chave para alcançar resultados bem-sucedidos e sustentáveis em qualquer disciplina...., bem como o barulho. Como resultado, o modelo desenvolvido usando o algoritmo da árvore de decisão funcionará bem com os dados de treinamento, mas terá um desempenho insatisfatório quando avaliado nos dados de teste (dados desconhecidos). Overfitting é a condição de ter um viés baixo e uma alta variância.
Árvore de decisão -----> Sobre-configuração ————–> baixo desvio, alta variância
Random Forest usa múltiplas árvores de decisão para evitar este problema presente no algoritmo da árvore de decisão.
Mas, Como a Random Forest aborda o problema de overfitting?
O algoritmo Random Forest não usa todos os dados de treinamento ao treinar o modelo, como visto no diagrama abaixo. Em seu lugar, amostras de linhas e colunas com repetição. Isso significa que cada árvore só pode ser treinada com um número limitado de linhas e colunas com dados repetidos. No diagrama a seguir, dados de treinamento 1 são usados para treinar a árvore de decisão 1, e os dados de treinamento n são usados para treinar a árvore de decisão n. Porém, uma vez que cada árvore é criada em toda a sua profundidade e tem a propriedade de sobreajuste, Como evitamos este problema?
Uma vez que o algoritmo não depende do resultado de uma árvore de decisão particular. Você primeiro obterá os resultados de todas as árvores de decisão e, em seguida, fornecerá o resultado final com base no tipo de declaração do problema. Por exemplo; se o tipo de declaração do problema é a classificação, a votação por maioria seria usada. suponha que estamos classificando “sim” e “não” com 10 arvores, e 6 as árvores estão classificando “sim” e 4 eles estão classificando “não”, a resposta final será “sim” usando a votação por maioria. O que acontece se a nossa saída for uma variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos.... contínuo? Nesse caso, o resultado final seria a média ou a medianaA mediana é uma medida estatística que representa o valor central de um conjunto de dados ordenados. Para calculá-lo, Os dados são organizados do menor para o maior e o número no meio é identificado. Se houver um número par de observações, Os dois valores principais são calculados em média. Este indicador é especialmente útil em distribuições assimétricas, uma vez que não é afetado por valores extremos.... da produção de todas as árvores.
Problema de classificação -> Votação majoritária
Problema de regressão -> meios de comunicação / Mediana
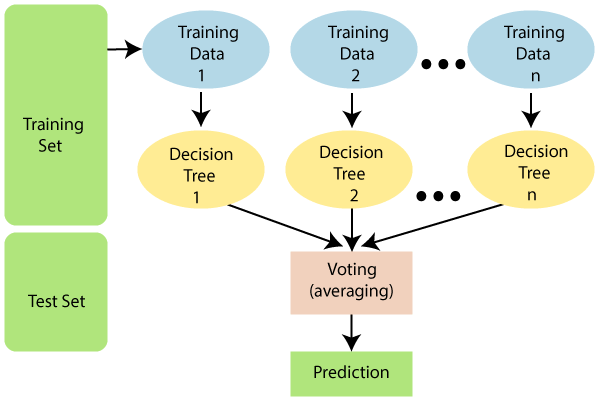
O modelo realiza amostragem de linha. Porém, A amostragem das características deve ser feita de acordo com o tipo de declaração do problema.
- Se o tipo de declaração do problema for “classificação”.
O número total de recursos / colunas aleatórias selecionadas = p ^ ½ ou a raiz quadrada de p,
onde p é o número total de Independente atributos / características presentes nos dados.
- Se o tipo de declaração do problema for “regressão”.
O número total de colunas aleatórias selecionadas = p / 3.
Random Forest evita overfitting com: –
1) Executando Amostragem de Linha e Característica.
2) Conectando todas as árvores de decisão em paralelo.
Por que ela é conhecida como técnica de agregação de bootstrap?
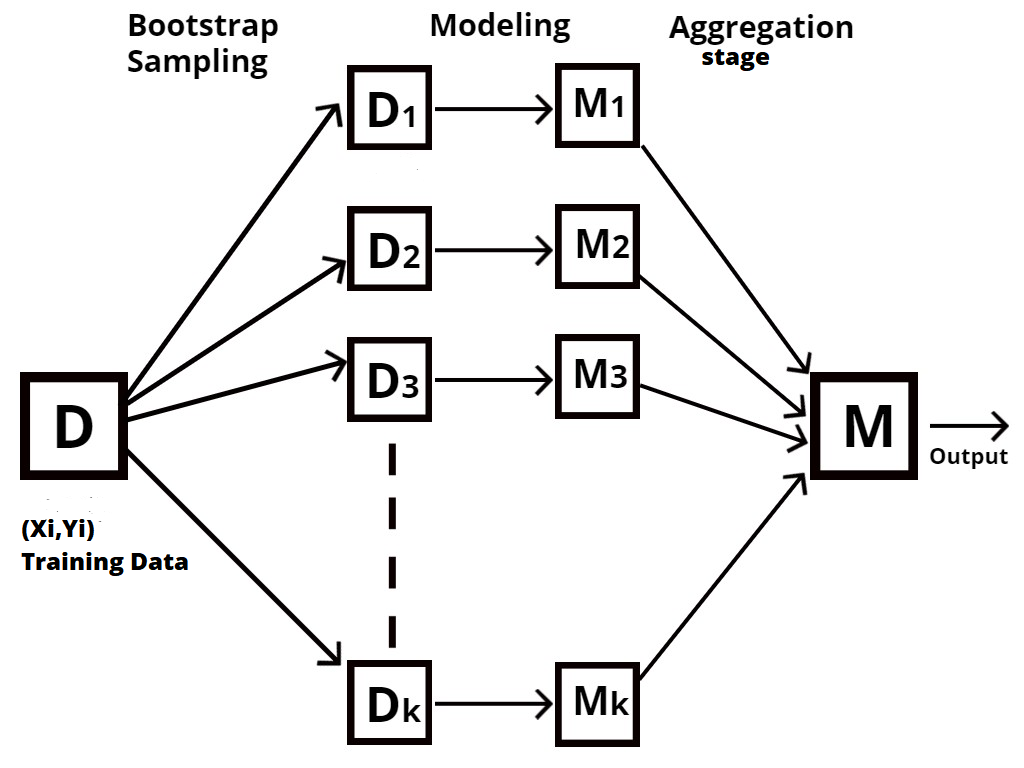
Random Forest é um tipo de técnica de conjunto, também conhecido como agregação de bootstrap o harpillera.
O processo de amostragem de diferentes linhas e características dos dados de treinamento com repetição para construir cada modelo de árvore de decisão é conhecido como bootstrapping., como mostrado no diagrama a seguir.
Agregação é o processo de pegar todos os resultados de cada árvore de decisão e combiná-los para produzir um resultado final usando votos da maioria ou valores médios., de acordo com o tipo de declaração do problema.
Floresta aleatória usando R
biblioteca(caTools)

biblioteca(randomForest)
Precisamos instalar os caTools das bibliotecas’ y ‘randomForest’ e ativá-los usando a função de biblioteca ()
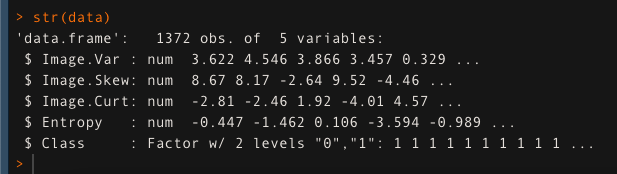
Usamos o conjunto de dados de autenticação de notas e o armazenamos na variável 'dados'. Vamos verificar a estrutura dos dados usando a função str ().
dados <- read.csv ('bank_note_data.csv', cabeçalho = T)
str (dados)
Agora vamos dividir nossos dados em partes de teste e treinamento. 80% para treinamento e 20% para testar o modelo.
sementes (123)
dividir <- sample.split (dados, SplitRatio = 0.8)
Comboio <- subconjunto (dados, divide == T)
prova <- subconjunto (dados, divisão == F)
Depois de dividir os dados, vamos construir nosso modelo usando a função randomForest (). Aqui ‘ntree’ é o hiperparâmetro. o que precisa ser ajustado. Neste caso, é selecionado como 500.
random_model <- random_forest (Classe ~., dados = trem, mtry = 2, ntree = 500)
Predizendo a precisão do modelo em dados de teste usando a função de previsão ().
avaliação <- prever (random_model, prova)
Avalie a precisão do modelo usando a matriz de confusão.
confusãoMatrix (Tabela (avaliação, prova $ Classe))
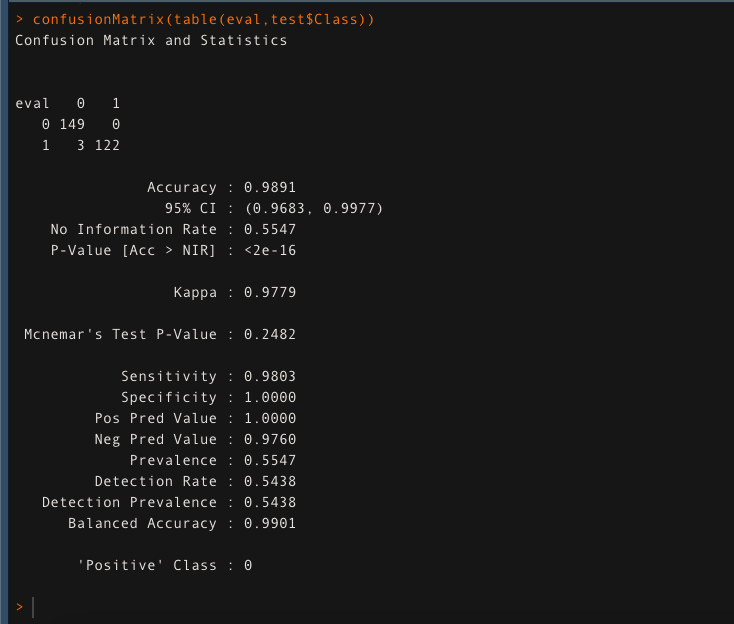
O modelo dá uma precisão de 98,91% nos dados de teste. Isso garante que a Random Forest está fazendo um trabalho fantástico..





