
Este artigo foi publicado como parte do Data Science Blogathon
Uma anomalia é uma observação que se desvia significativamente de todas as outras observações. Um sistema de detecção de anomalias é um sistema que detecta anomalias nos dados. Uma anomalia também é chamada de outlier.
Exemplo: Digamos que uma coluna de dados consiste na renda mensal dos cidadãos e essa coluna também contém o salário de Bill Gates. Então, O salário de Bill Gates é um valor atípico nestes dados.
Algoritmos de detecção de anomalias
Neste blog, vamos dar uma olhada nos seguintes algoritmos de detecção de anomalias.
Estes são alguns dos muitos algoritmos disponíveis e nunca se abstém de explorar mais algoritmos do que estes.
Importe as bibliotecas necessárias e escreva as funções de utilitário
# detecção de outlier python
!pip install pyod

import warnings
import numpy as np
import pandas as pd
from pyod.models.mad import MAD
from pyod.models.knn import KNN
from pyod.models.lof import LOF
import matplotlib.pyplot as plt
from sklearn.ensemble import IsolationForest

# data for anomaly detection
data_values = [['2021-05-1', 45000.0],
       ['2021-05-2', 70000.0],
       ['2021-05-3', 250000.0],
       ['2021-05-4', 70000.0],
       ['2021-05-5', 45000.0],
       ['2021-05-6', 55000.0],
       ['2021-05-7', 35000.0],
       ['2021-05-8', 60000.0],
       ['2021-05-9', 45000.0],
       ['2021-05-10', 25000.0],
       ['2021-05-11', 142936.0],
       ['2021-05-12', 138026.0],
       ['2021-05-13', 28347.0],
       ['2021-05-14', 40962.66],
       ['2021-05-15', 34543.0],
       ['2021-05-16', 40962.66],
       ['2021-05-17', 25207.0],
       ['2021-05-18', 37502.0],
       ['2021-05-19', 29589.0],
       ['2021-05-20', 78404.0],
       ['2021-05-21', 26593.0],
       ['2021-05-22', 123267.0],
       ['2021-05-23', 46880.0],
       ['2021-05-24', 65361.0],
       ['2021-05-25', 46042.0],
       ['2021-05-26', 48209.0],
       ['2021-05-27', 44461.0],
       ['2021-05-28', 90866.0],
       ['2021-05-29', 46886.0],
       ['2021-05-30', 33456.0],
       [' 31-05-2021', 46251.0],
       ['2021-06-1', 29370.0],
       ['2021-06-2', 165620.0],
       ['2021-06-3', 20317.0]]

data = pd.DataFrame(data_values , colunas =['date', 'montante'])

def fit_model(modelo, dados, coluna='montante'):
    # fit the model and predict it
    df = data.copy()
    data_to_predict = dados[coluna].to_numpy().remodelar(-1, 1)
    previsões = model.fit_predict(data_to_predict)
    df['Previsões'] = predictions

    return df

def plot_anomalies(df, x='data', y='montante'):

    # categorias estarão tendo valores a partir de 0 para n
    # para cada valor em 0 to n it is mapped in colormap
    categories = df['Previsões'].to_numpy()
    colormap = np.array(['g', 'r'])

    f = plt.figure(figsize =(12, 4))
    f = plt.scatter(df[x], df[e], c=colormap[Categorias])
    f = plt.xlabel(x)
    f = plt.ylabel(e)
    f = plt.xticks(rotação=90)
    plt.show()
Os dados acima consistem em duas colunas, a saber, data e quantidade, podemos assumir que os dados contêm a quantidade de vendas de uma empresa de exibição de padaria.
Qual é a função fit_model?
- A função fit_model toma o modelo e os dados como entrada, aqui estamos encontrando anomalias na coluna quantidade.
- Depois disso, muda a forma dos dados em dados unidimensionais e se ajusta ao modelo fornecido e prevê anomalias nos dados e os armazena na coluna de previsões do quadro de dados fornecido, e devolve.
Intervalo interquartil
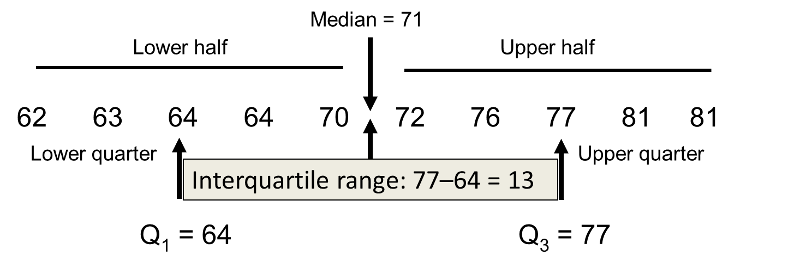
Percentis:
Quartis:
-
11º quartil = percentil 25
-
2c quartil = percentil 50
-
3.1º quartil = percentil 75
Intervalo interquartil (IQR):
IQR = 3º quartil – 1é cuartil
Anomalias = [1st Quartil - (1.5 * IQR)] o [3rd quartil + (1.5 * IQR)]
As anomalias estão abaixo [1st Quartil - (1.5 * IQR)] e acima [3rd quartil + (1.5 * IQR)] estes valores.
def find_anomalies(valor, limite_inferior, limite superior):

    se valor < limite_inferior ou valor > limite superior:
        Retorna 1
    outro: Retorna 0

def iqr_anomaly_detector(dados, coluna='montante', limiar=1,1):

    df = data.copy()
    quartis = dict(dados[coluna].Quântico([.25, .50, .75]))
    quartile_3, quartile_1 = quartis[0.75], quartis[0.25]
    iqr = quartile_3 - quartile_1

    lower_threshold = quartile_1 - (limiar * Iqr)
    upper_threshold = quartile_3 + (limiar * Iqr)

    imprimir(f"Limiar inferior: {limite_inferior}, limiar nUpper: {limite superior}n")

    df['Previsões'] = dados[coluna].Aplique(find_anomalies, args=(limite_inferior, limite superior))
    return df

iqr_df = iqr_anomaly_detector(dados)
plot_anomalies(iqr_df)
# saída
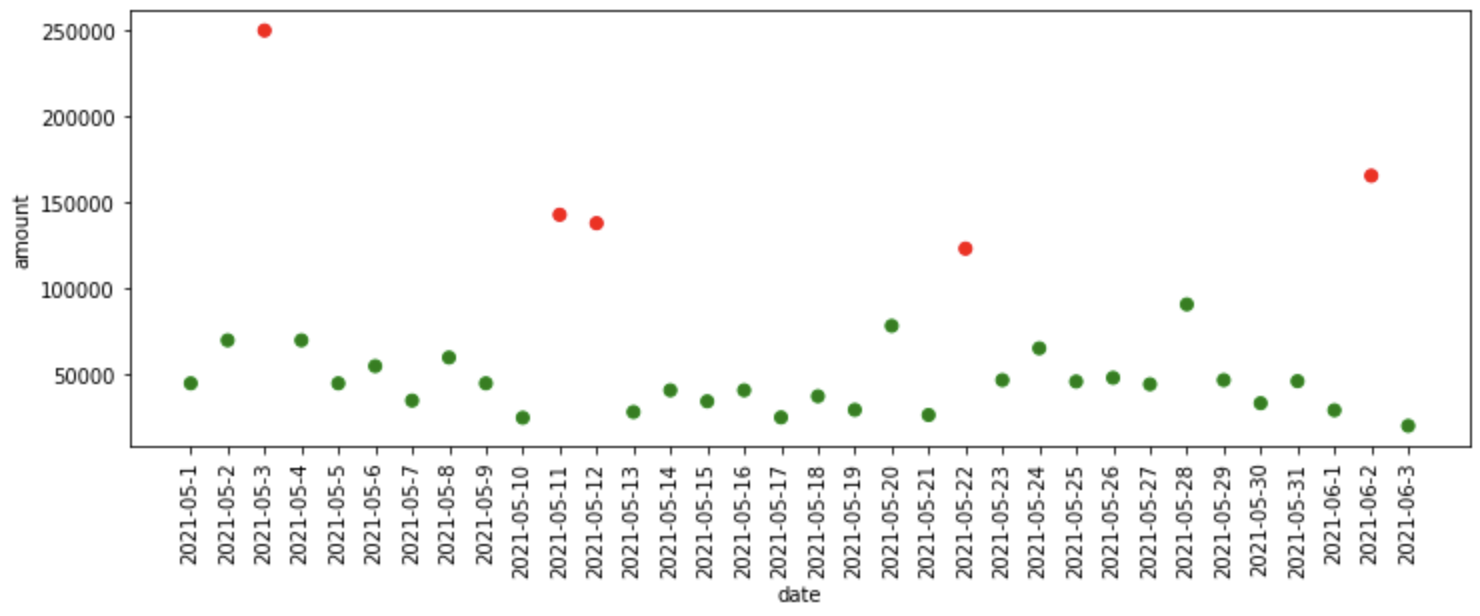
# Limiar inferior: -2944.050000000003,
# Limiar superior: 106441.55
¿Qué sucedió en el código anterior?
- Em primeiro lugar, averigua el percentil 25 e 75, quer dizer, se encontraron el 1er y 3er cuartil.
- E logo, o intervalo interquartil é encontrado, que é a diferença entre o terceiro e o primeiro quartil.
- Depois disso, estamos encontrando o limite superior e inferior acima e abaixo do qual as anomalias se encontram, respectivamente.
- A função find_anomalies acima encontra as anomalias nos dados de acordo com os limites fornecidos.
- Finalmente, estamos rastreando as anomalias encontradas.
Floresta de isolamento
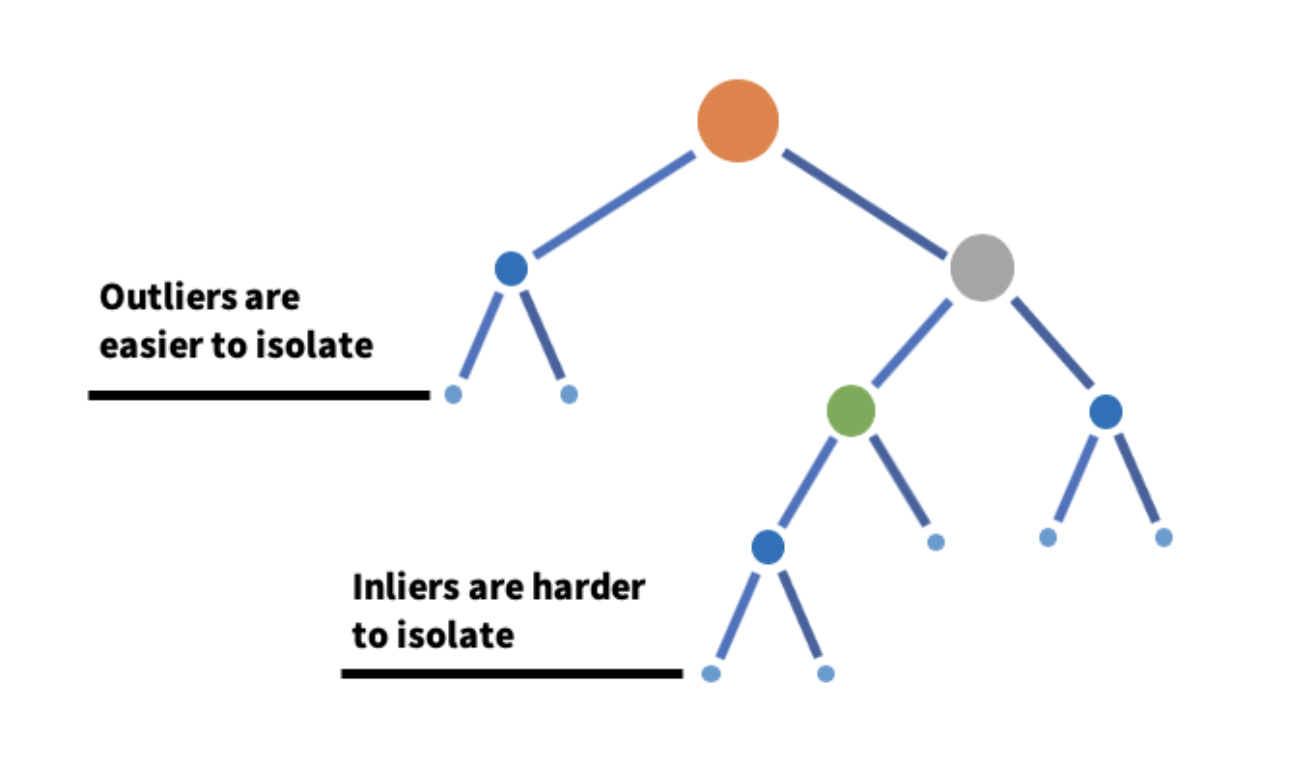
Isolation Forest é um algoritmo que detecta anomalias pegando um subconjunto de dados e construindo muitas árvores de isolamento a partir deles..
-
A ideia central é que as anomalias são muito mais fáceis de isolar do que as observações normais e as anomalias existem em profundidades muito menores de uma árvore de isolamento.. Uma árvore de isolamento é construída selecionando aleatoriamente um recurso e selecionando aleatoriamente um valor desse recurso. Uma floresta é construída adicionando todas as árvores de isolamento.
iso_forest = IsolationForest(n_estimators = 125)
iso_df = fit_model(iso_forest, dados)
iso_df['Previsões'] = iso_df['Previsões'].mapa(lambda x: 1 if x == - 1 else 0)
plot_anomalies(iso_df)
¿Qué sucedió en el código anterior?
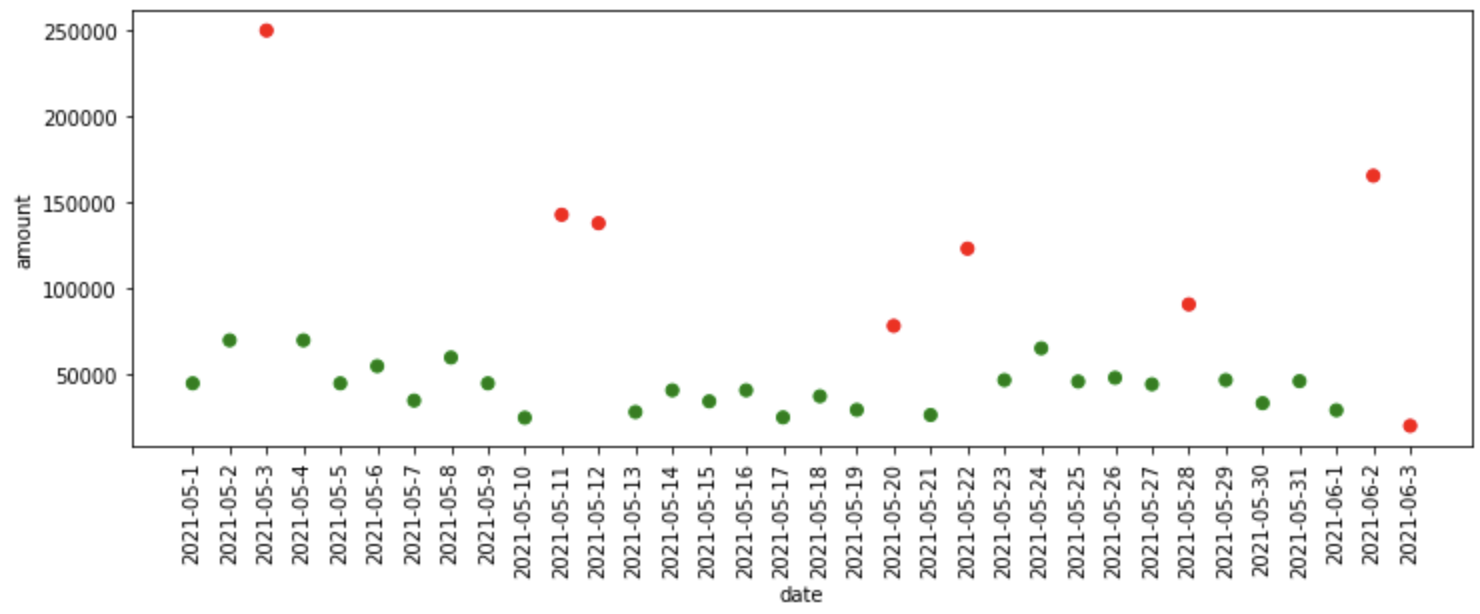
- Primeiro, definimos o modelo de Isolation Forest com 125 árvores de isolamento, então passamos o modelo, os dados como entradas para a função fit_model, onde ajusta o modelo aos dados e nos fornece previsões.
- A floresta de isolamento aloca -1 para dados anômalos e 1 para dados normais, então para simplificar, nós convertemos a previsão de dados normais (1) uma 0 e a previsão de dados anômalos (-1) uma 1.
- Finalmente, traçamos as anomalias previstas pela Floresta de Isolamento.
Desvio absoluto da mediana
La desviación absoluta media es la diferencia entre cada observación y la medianaA mediana é uma medida estatística que representa o valor central de um conjunto de dados ordenados. Para calculá-lo, Os dados são organizados do menor para o maior e o número no meio é identificado. Se houver um número par de observações, Os dois valores principais são calculados em média. Este indicador é especialmente útil em distribuições assimétricas, uma vez que não é afetado por valores extremos.... de esas observaciones. Uma observação que se desvia mais do resto da observação é considerada uma anomalia..
Por que mediana em vez de média?
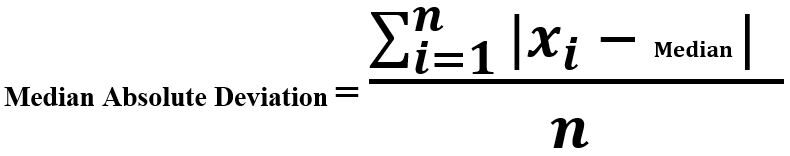
"""Desvio Mediano Absoluto"""
mad_model = MAD()
mad_df = fit_model(mad_model, dados)
plot_anomalies(mad_df)
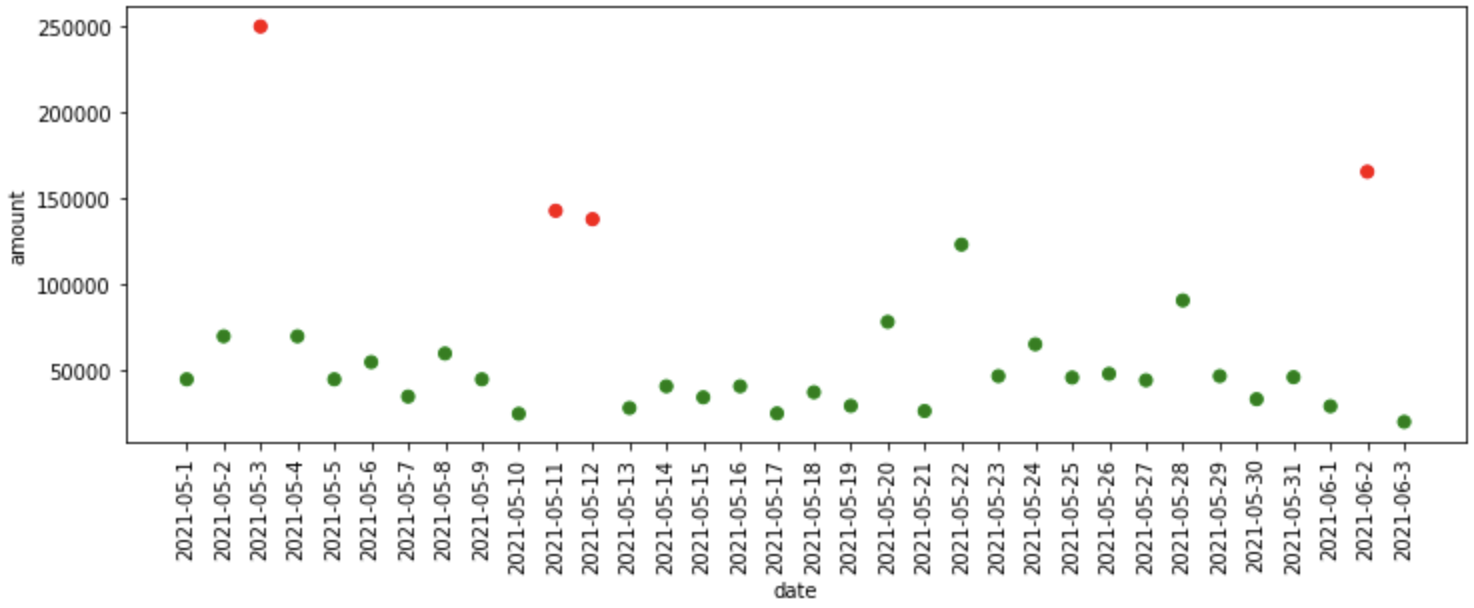
¿Qué sucedió en el código anterior?
- Primeiro, Definimos o modelo de Desvio Mediano Absoluto que está disponível na biblioteca de pyod, então passamos o modelo, os dados como entradas para a função fit_model, onde ajusta o modelo aos dados e nos fornece previsões.
- Finalmente, plotamos as anomalias previstas pelo modelo MAD.
Algoritmo de Vizinhos Mais Próximos K
O algoritmo K-vizinho mais próximo detecta anomalias usando as distâncias K de vizinhos mais próximos como pontuações de anomalias. A ideia é que se uma observação está muito longe das outras observações, então essa observação é considerada uma anomalia.
"""Detecção de outlier baseada em KNN"""
knn_model = KNN()
knn_df = fit_model(knn_model, dados)
plot_anomalies(knn_df)
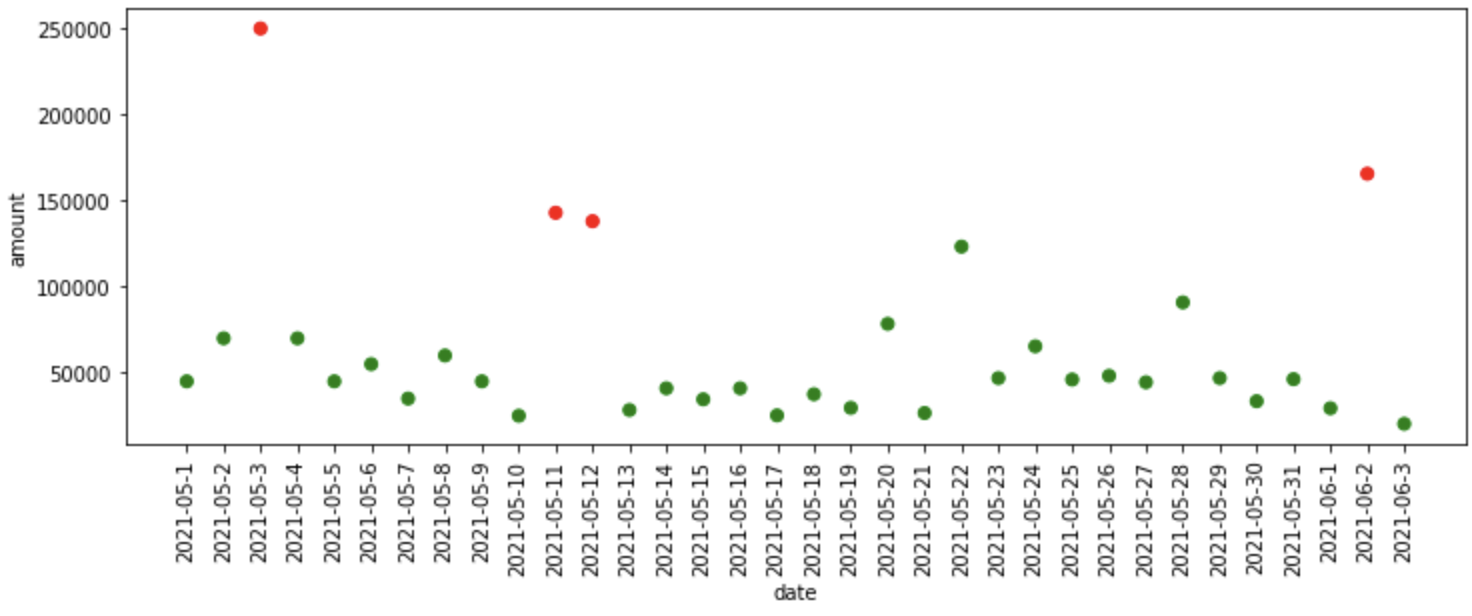
¿Qué sucedió en el código anterior?
- Primeiro, definimos o modelo vizinho mais próximo K que está disponível na biblioteca pyod, então passamos o modelo, os dados como entradas para a função fit_model, onde ajusta o modelo aos dados e nos fornece previsões.
- Finalmente, traçamos as anomalias previstas pelo modelo KNN.
Existem muitos modelos disponíveis na biblioteca PyOD, como,
- CBLOF (fator de outlier local baseado em cluster)
- LOF (fator de outlier local)
- HBOS (detecção de outlier baseada em histograma)
- OCSVM (SVM de uma classe)
Nunca se abstenham de experimentar mais algoritmos disponíveis no PyOD.
As implementações práticas dos algoritmos acima são implementadas no seguinte bloco de notas
Referências
[1] PyOD, Biblioteca de detecção de valor atípico Python
Obrigado!
A mídia mostrada neste artigo não é propriedade da DataPeaker e é usada a critério do autor.





