
Este artigo foi publicado como parte do Data Science Blogathon
GitHub é uma das plataformas de gerenciamento de código-fonte e controle de versão mais populares. É também um dos maiores sites de mídia social para programadores. Os desenvolvedores de software o usam para mostrar suas habilidades aos recrutadores e gerentes de contratação. Ao analisar repositórios no GitHub, podemos obter informações valiosas, como o comportamento do usuário, o que torna um repositório popular ou quais tecnologias estão em alta entre os desenvolvedores hoje, e muito mais.
Você pode encontrar o código completo usado no artigo aqui.
Eu tenho usado a ‘Repositórios GitHub 2020’ Conjunto de dados Kaggle, já que é mais recente.
Implementação
Vamos idiota isso começou importando as bibliotecas necessárias e lendo os dados de entrada,
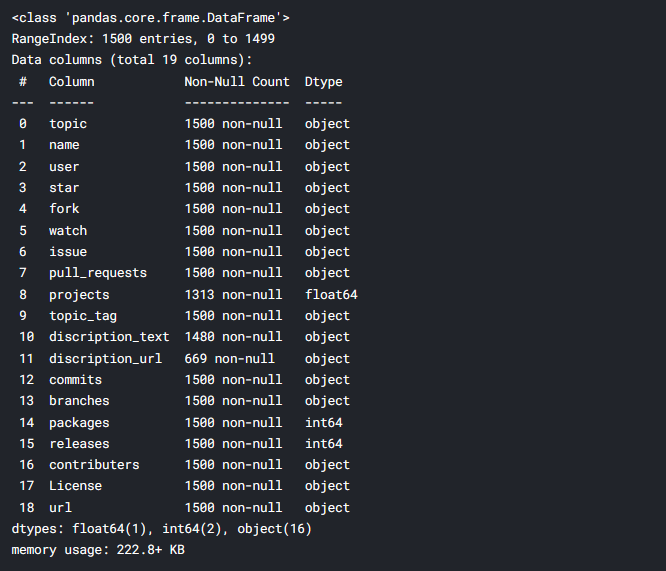
O conjunto de dados contém 19 colunas, dos quais eu escolhi 11 colunas baseadas nas terminologias mais populares do GitHub e aquelas relevantes para o contexto desta discussão. Você pode ver que há erros de digitação nos nomes das colunas, Eu os renomeei para maior clareza.
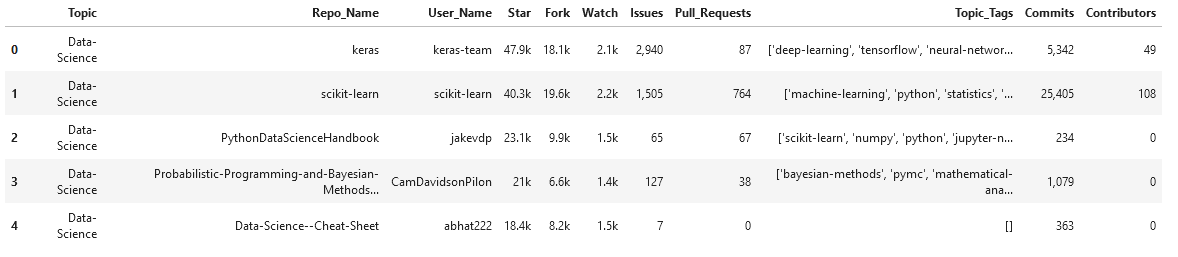
Um breve resumo sobre as colunas de dados,
- Tema – Uma tag que descreve o campo ou domínio do repositório.
- Repo_Name – Nome do repositório (nome abreviado do repositório)
- Nome de usuário – Nome do proprietário do repositório
- Estrela – Número de estrelas que um repositório recebeu
- Garfo – Número de vezes que um repositório foi bifurcado
- Olhar – Número de usuários olhando para o repositório
- Perguntas – Número de questões abertas
- Pull_Requests – Total de solicitações de pull geradas
- Topic_Tags – Lista de tags de tópico adicionadas a esse repositório pelo usuário
- Compromissos – Número total de confirmações feitas
- Colaboradores – Número de pessoas contribuindo para o repositório
Descobrir como Estrela, Garfo, e Olhar as colunas contêm ‘Kansas para denotar milhares, então vamos convertê-los em múltiplos de 1000. O que mais, substituindo o ‘,’(vírgulas) do Perguntas e Compromissos colunas.
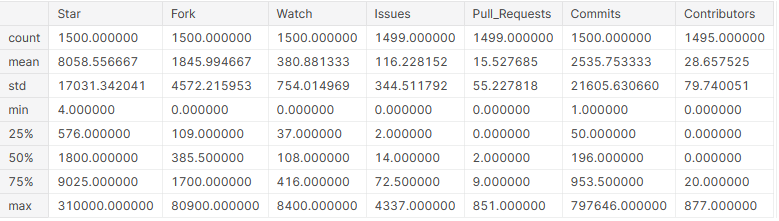
Agora que as colunas são numéricas, podemos obter informações estatísticas básicas deles.
# exibir detalhes estatísticos básicos sobre as colunas
github_df.describe()
1. Análise dos principais repositórios de acordo com sua popularidade
O que torna um repositório GitHub popular? Esta pergunta pode ser respondida com 3 Métricas: Estrela, relógio e garfo.
- Estrela: quando um usuário gosta do seu repositório ou quer mostrar alguma gratidão, marca com uma estrela.
- Assistir: quando um usuário deseja ser notificado de todas as atividades em um repositório, Vê isso.
- Garfo: quando um usuário deseja uma cópia do repositório ou pretende fazer uma contribuição, o garfo.
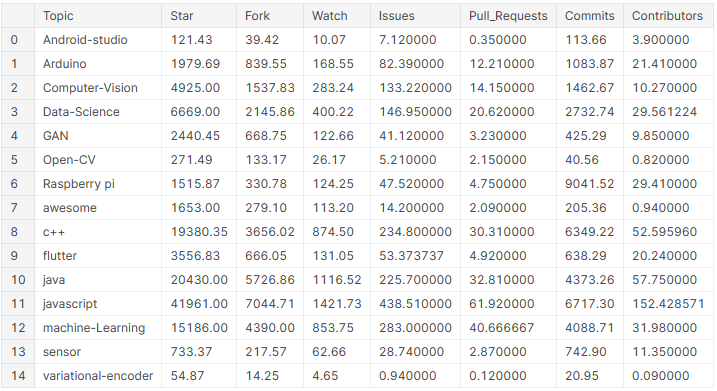
# crie um dataframe com os valores médios das colunas em todos os tópicos
pop_mean_df = github_df.groupby('Topic').quer dizer().reset_index()
pop_mean_df
1.1 Análise de estrelas
Veja o número médio de estrelas em cada tópico,
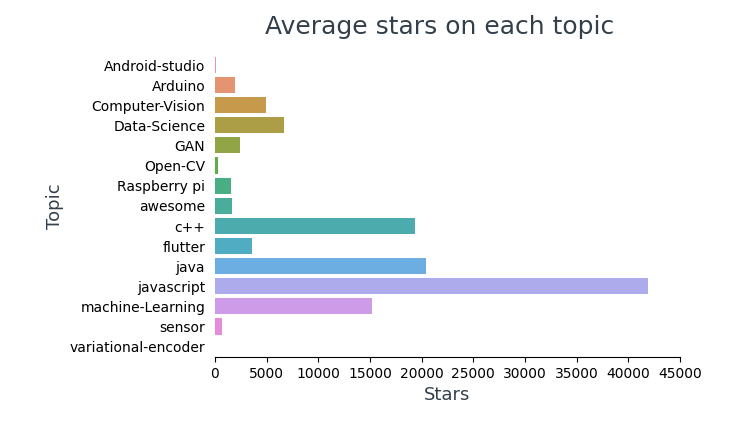
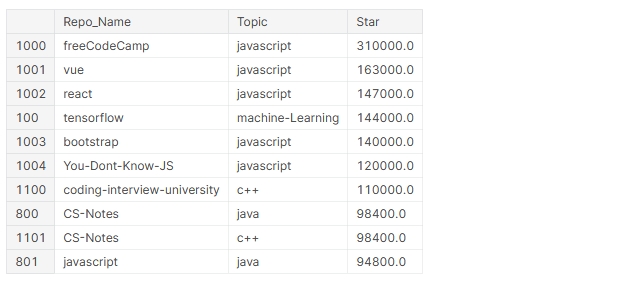
# principal 10 repositórios mais marcados com estrela
github_df.nlargest(n = 10, colunas ="Estrela")[['Repo_Name','Topic','Star']]
# Dica rápida: '33[1m' imprime uma string em negrito e '33[0m' imprime-a de volta normalmente.
imprimir('O repositório mais estrelado é {}{}{} no tópico {}{}{} com {}{}{} stars'.
      formato('33[1m',github_df.iloc[github_df['Star'].idxmax ()]['Repo_Name'], '33[0m',
             '33[1m',github_df.iloc[github_df['Star'].idxmax ()]['Topic'], '33[0m',
            '33[1m',github_df.iloc[github_df['Star'].idxmax ()]['Star'], '33[0m'))

No topo 10 repositórios mais marcados com estrela, 4 são frameworks (Visto, Reagir, TensorFlow, BootStrap) e 6 deles são sobre JavaScript.
1.2 Análise do relógio
Visualizando o número médio de observadores em cada tópico,
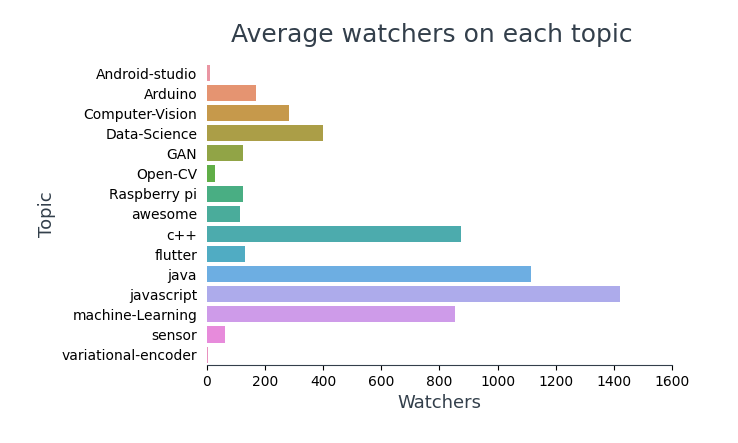
Observação: O código para o gráfico acima é o mesmo que "Média de estrelas em cada tópico", exceto para os nomes das colunas. Eu não adicionei o mesmo para evitar redundância.
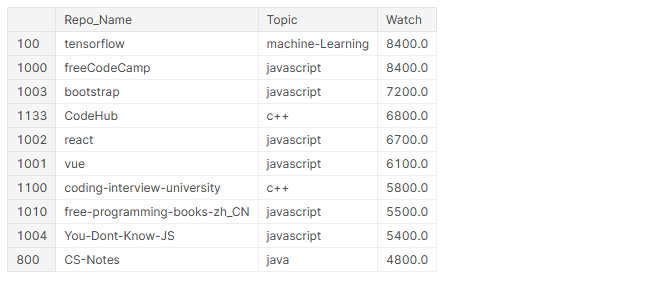
# principal 10 repos mais assistidos
github_df.nlargest(n = 10, colunas ="Assistir")[['Repo_Name','Topic','Watch']]
imprimir('O repositório mais assistido é {}{}{} no tópico {}{}'.
        formato('33[1m',github_df.iloc[github_df['Watch'].idxmax()]['Repo_Name'],
        '33[0m','33[1m',github_df.iloc[github_df['Watch'].idxmax()]['Topic']))

Nos 10 repositórios mais vistos, 4 quadros filho (TensorFlow, BootStrap, Reagir, Visto), 6 são sobre JavaScript e 5 deles contêm conteúdo de aprendizagem para programadores.
1.3 Análise de bifurcação
Veja o número médio de bifurcações em cada tópico,
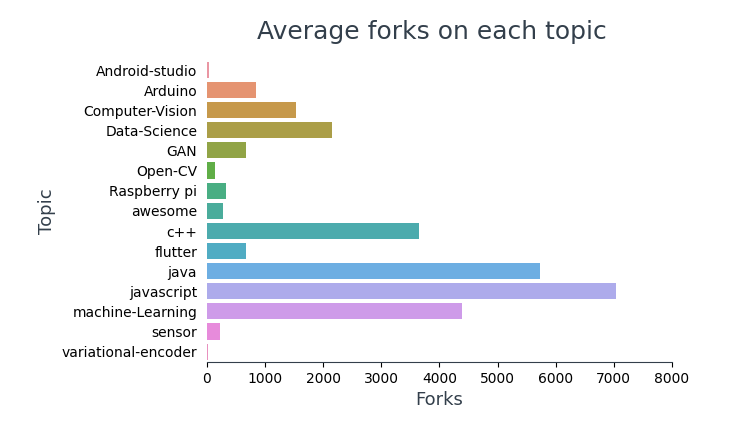
# principal 10 repositórios mais bifurcados
github_df.nlargest(n = 10, colunas ="Garfo")[['Repo_Name','Topic','Fork']]
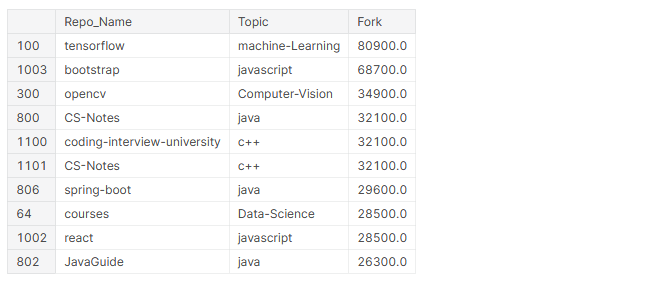
imprimir('O repositório mais bifurcado é {}{}{} no tópico {}{}'.
      formato('33[1m',github_df.iloc[github_df['Fork'].idxmax()]['Repo_Name'],'33[0m',
      '33[1m',github_df.iloc[github_df['Fork'].idxmax()]['Topic']))

Em cima 10 mais repositórios bifurcados, 4 quadros filho (TensorFlow, bootstrap, bota de mola, reagir) e 5 deles contêm conteúdo de aprendizagem para programadores.
1.4 Relacionamento estrela, grampo de cabelo e relógio
Frequentemente, os usuários bifurcam um repositório quando desejam contribuir para ele. Então, Vamos explorar a relação entre o garfo da estrela e o garfo do relógio.
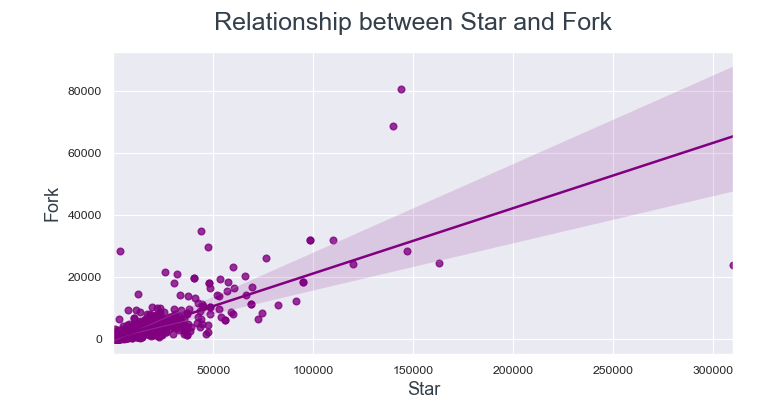
# definir o tamanho da figura e dpi
FIG, ax = plt.subplots(figsize =(8,4), dpi = 100)

# definir tema marítimo para grades de fundo
sns.set_theme('paper')

# plotar os dados
sns.regplot(data = github_df, x='Watch', y='Fork', color ="roxa");

# definir rótulos e títulos dos eixos xey
ax.set_xlabel('Watch', fontsize = 13, color ="#333F4B")
ax.set_ylabel('Fork', fontsize = 13, color ="#333F4B")
fig.subtitle('Relationship between Watch and Fork',fontsize = 18, color ="#333F4B")
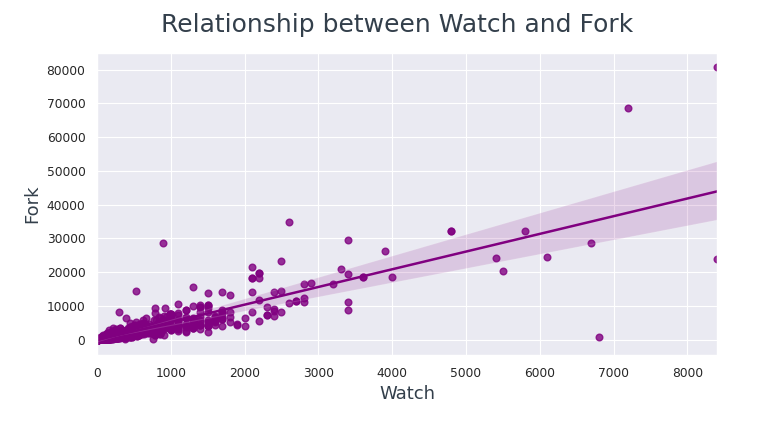
Os pontos de dados estão muito mais próximos da linha de regressão entre Watch e Fork em comparação com Star e Fork.
Disto podemos concluir, se um usuário está visualizando um repositório, mais propenso a garfo.
2. Análise de usuários com mais repositórios
Vamos dar uma olhada nos usuários que possuem repositórios mais populares.
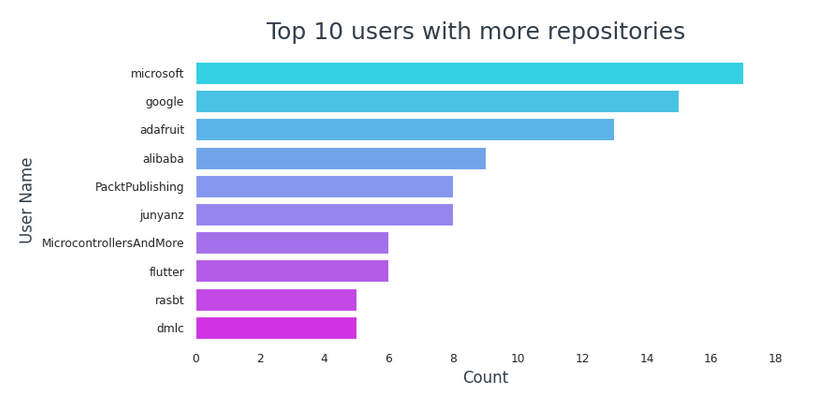
Em cima 10 usuários com mais repositórios,
- Microsoft lidera a lista com 17 repositórios.
- O Google continua com 15 repositórios.
- 6 deles são empresas ou propriedade de uma empresa (Microsoft, Google, Adafruit, Alibaba, PacktPublishing, vibração)
- 3 eles são usuários individuais (Junyanz, malandro, MicrocontrollersAndMore)
3. Compreender as atividades de contribuição em repositórios
GitHub é famoso por seu gráfico de contribuição.
Este gráfico é um registro de todas as contribuições feitas por um usuário. Sempre que um usuário faz uma confirmação, abrir um problema ou propor uma solicitação pull, é considerado uma contribuição. Existem quatro colunas relacionadas às contribuições em nosso conjunto de dados, Problemas, Pull_Requests, Compromissos, Colaboradores. Vamos ver se existe alguma relação real entre eles.
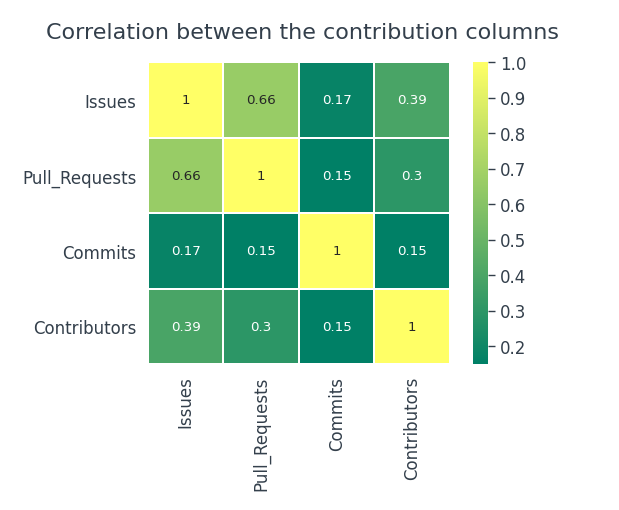
O número de confirmações não depende de nenhum problema, puxar solicitações ou contribuidores. Há uma relação positiva moderada entre problemas e solicitações pull.
Vamos explorar o 100 repositórios mais populares e vamos ver se é o mesmo,
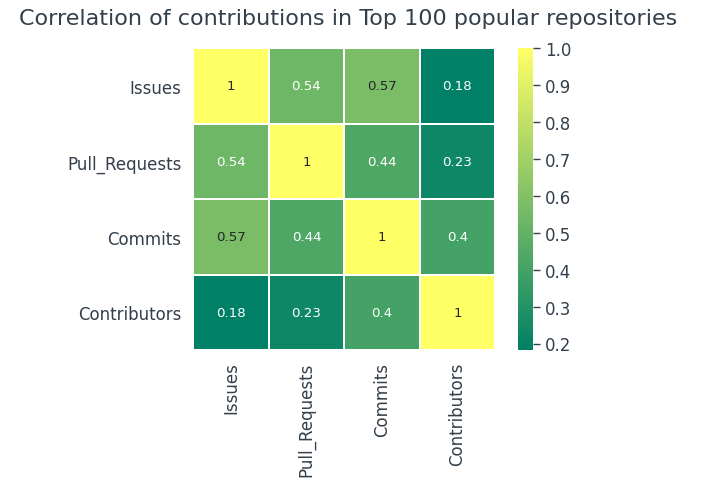
É quase o mesmo em 100 repositórios mais populares do que no conjunto de dados geral.
Vamos encontrar usuários com mais repositórios,
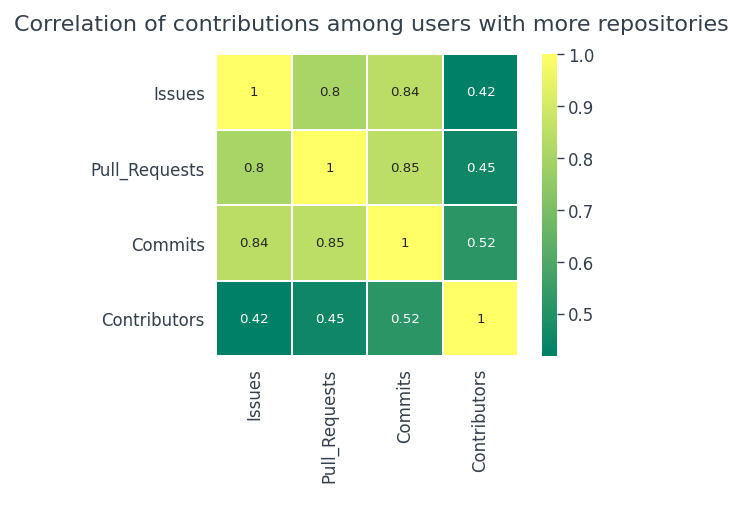
Surpreendentemente, usuários com mais repositórios tendem a ser mais ativos. Existe uma correlação positiva bastante forte entre
- Confirmar e extrair solicitações
- Compromissos e problemas
- Solicitações de pull e problemas
Em relação às contribuições,
- Não há uma relação real entre as atividades de contribuição no conjunto de dados geral.
- Também não há correlação entre as contribuições no 100 repositórios mais populares.
- Se os usuários tendem a ter mais repositórios, então as possibilidades de contribuições são muito maiores.
4. Análise de tag de tópico
A coluna topic_tags consiste em listas. Para encontrar tags populares, converter a coluna inteira em uma lista de listas e contar a ocorrência de cada rótulo. Com isso, podemos visualizar algumas das tags de tópico mais populares e ver quais tópicos tendem a ser mais marcados.
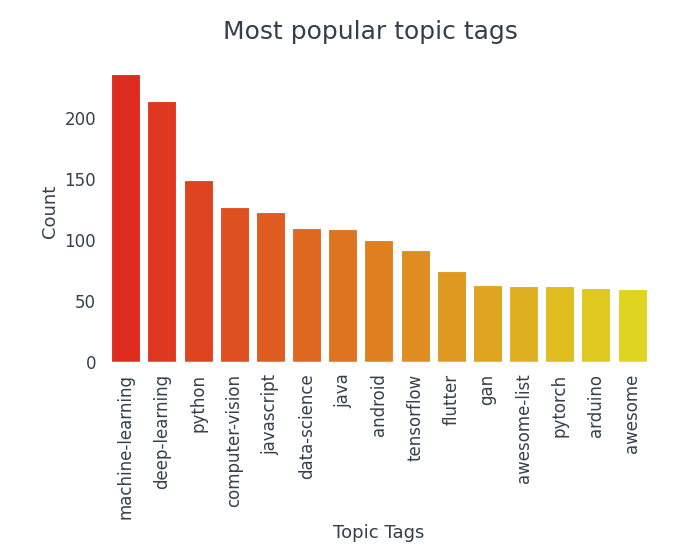
Das 15 tags mais populares, 10 pertencem ao mundo da ciência de dados.
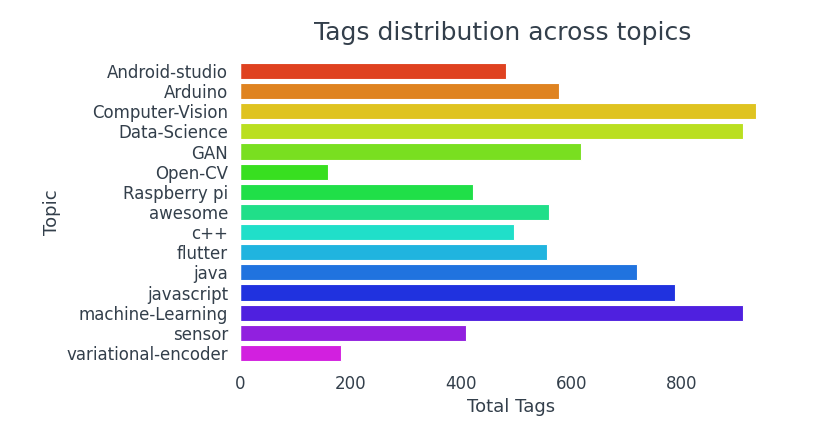
Repositórios com temas de visão computacional, Ciência de dados e aprendizado de máquina tendem a ser mais rotulados.
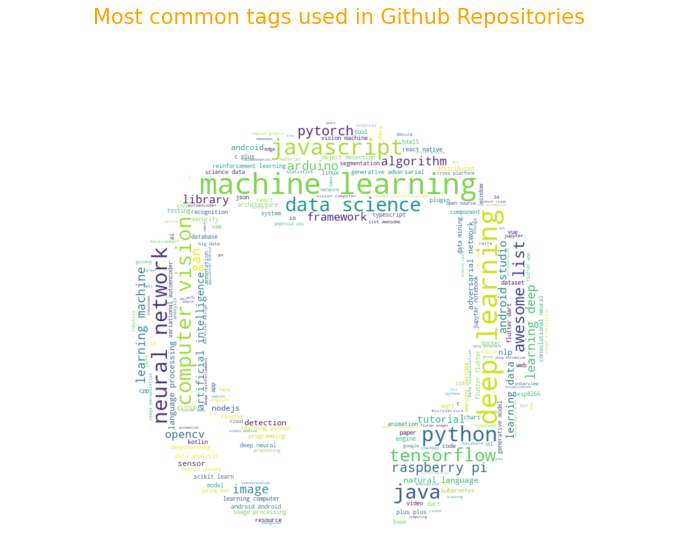
Vamos terminar com uma nuvem de palavras de topic_tags,
Inferência:
- Entre os 10 repositórios mais proeminentes, visto e bifurcado, 4 quadros filho.
- Tensorflow é o repositório mais assistido e bifurcado.
- Se um usuário estiver olhando para um repositório, mais propenso a garfo.
- Microsoft e Google tendem a ser usuários com repositórios mais populares.
- Em cima 10 usuários com repositórios mais populares, 6 deles são empresas.
- Não existe uma relação real entre as atividades de contribuição (problemas, puxar pedidos, confirmações).
- As tags mais usadas são Machine Learning, Aprendizado Profundo, Pitão, Visão Computacional, JavaScript.
- Repositórios com temas de visão computacional, Ciência de dados e aprendizado de máquina têm mais rótulos.
Se tivéssemos analisado dados de uma década atrás, essas tendências teriam sido completamente diferentes. É como se a ciência de dados tivesse apresentado um crescimento monstruoso nos últimos anos!!
Obrigado por assistir até aqui! Eu adoraria me conectar LinkedIn
Deixe-me saber na seção de comentários se você tiver alguma dúvida, comentário ou crítica. Que tenha um bom dia!
A mídia mostrada neste artigo não é propriedade da DataPeaker e é usada a critério do autor.





