
O que é regressão logística?
Este artículo asume que posee conocimientos básicos y comprensión de los conceptos de aprendizaje automático, como el vector de destino, la matriz de características y términos relacionados.
Regressão logística: probablemente uno de los algoritmos de aprendizaje automático supervisado más interesantes en el aprendizaje automático. A pesar de tener “Regressão” en su nombre, Regresión logística es un método supervisado de uso popular. Classificação Algoritmo. Regressão logística, junto con sus primos relacionados a saber. Regresión logística multinomial, nos otorga la capacidad de predecir si una observación pertenece a una determinada clase utilizando un enfoque que es sencillo, fácil de entender y sigue.
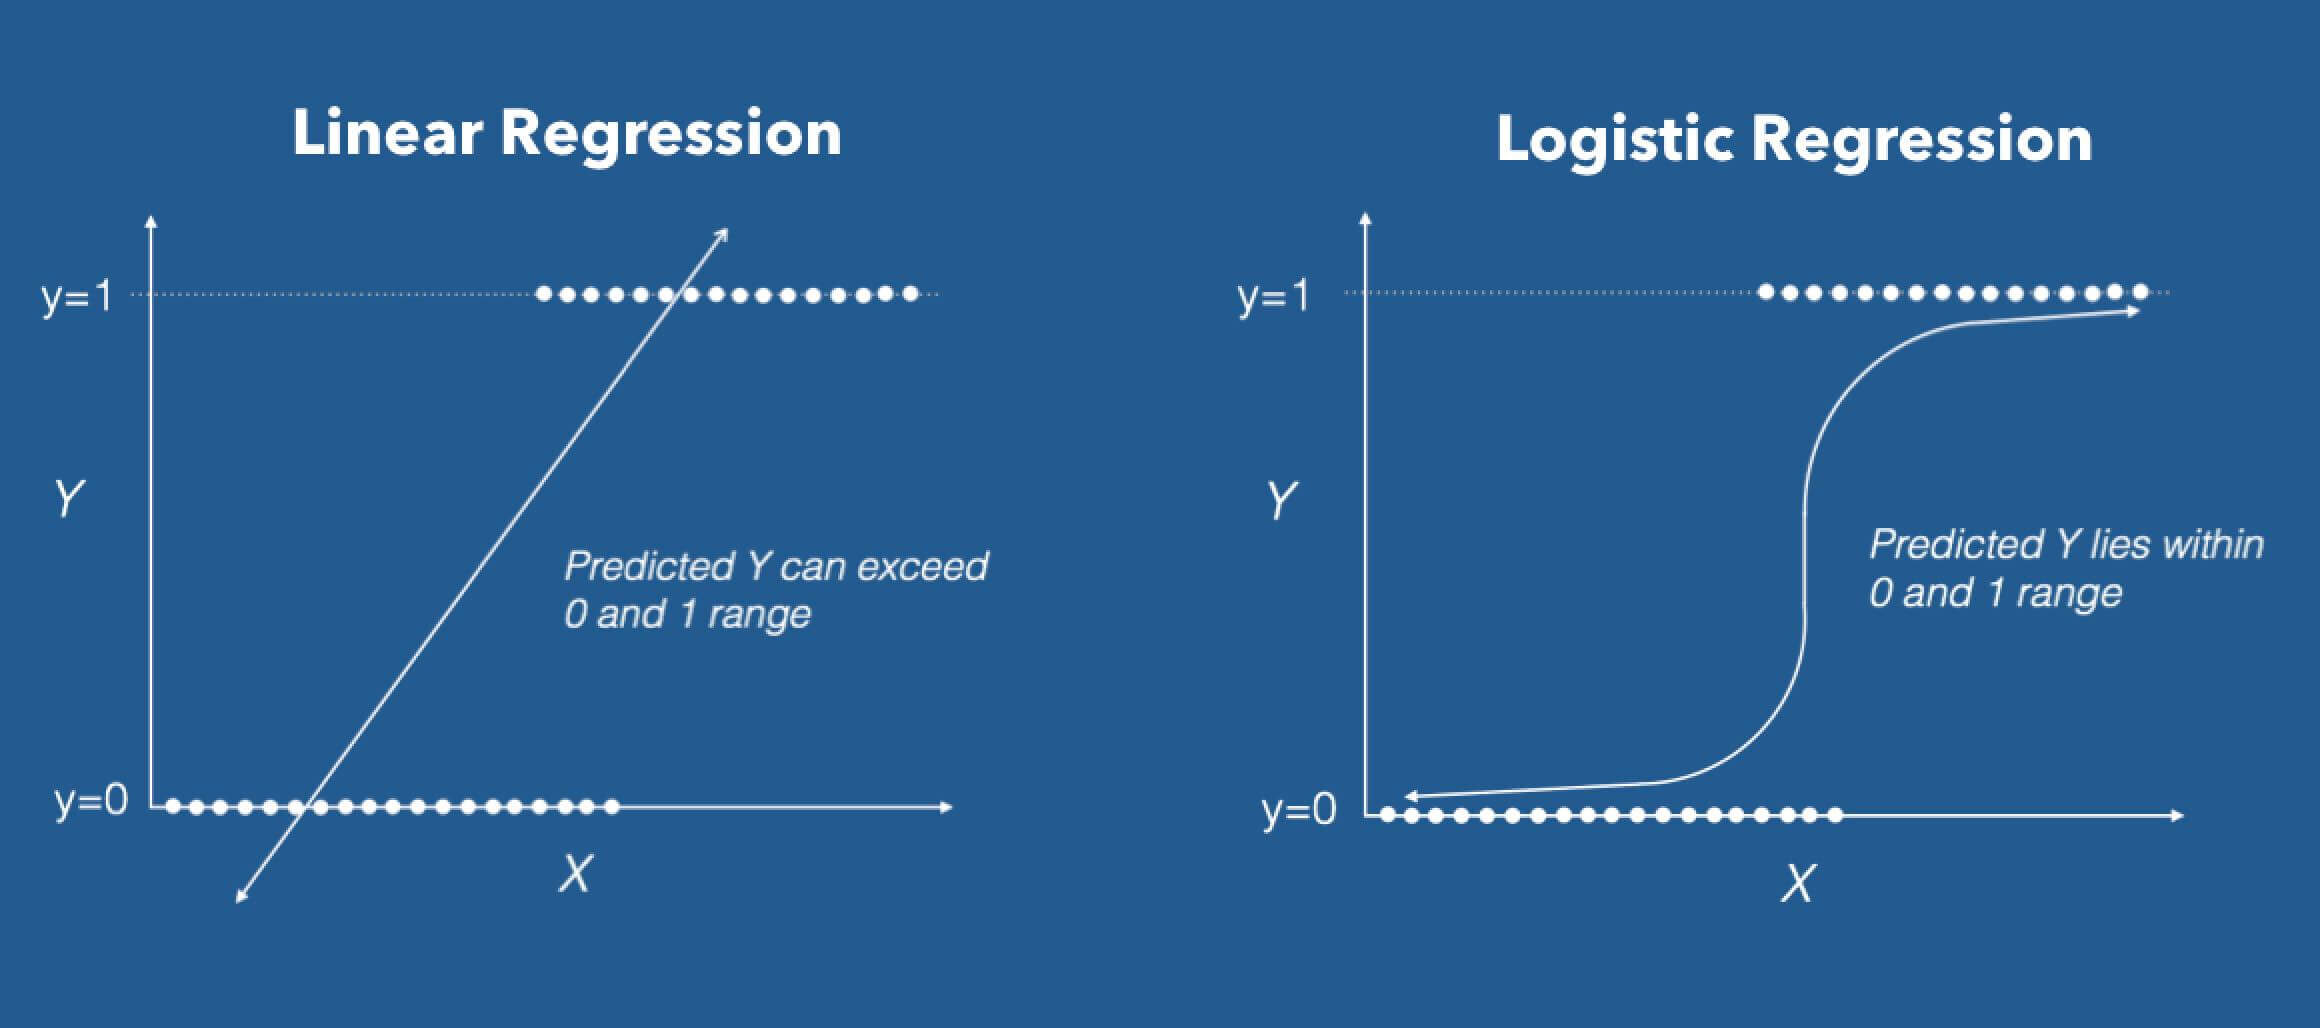
Fonte: DZone
Regresión logística en su forma base (por defecto) é um Clasificador binario. Isto significa que o vetor alvo só pode assumir um de dois valores. Na fórmula do algoritmo de regressão logística, temos um modelo linear, por exemplo, b0 + b1x, que está integrado numa função logística (também conhecida como função sigmoide). A fórmula do Classificador Binário que temos no final é a seguinte:
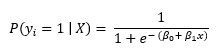

- P (eeu = 1 | X) é a probabilidade de iº Observações valor alvo, eeu pertencente à classe 1.
- Β0 y β1 são os parametroso "parametros" são variáveis ou critérios usados para definir, medir ou avaliar um fenômeno ou sistema. Em vários domínios, como a estatística, Ciência da Computação e Pesquisa Científica, Os parâmetros são essenciais para estabelecer normas e padrões que orientam a análise e interpretação dos dados. Sua seleção e manuseio adequados são cruciais para obter resultados precisos e relevantes em qualquer estudo ou projeto.... que devem ser aprendidos.
- mim representa o número de Euler.
Objetivo principal da fórmula de regressão logística.
A fórmula de regressão logística tem como objetivo limitar ou restringir a saída linear e / ou sigmoide entre um valor de 0 e 1. A razão principal é para fins de interpretação, quer dizer, podemos ler o valor como uma probabilidade simples; O que significa que se o valor for maior que 0,5, seria prevista a classe um; pelo contrário, será prevista a classe 0.
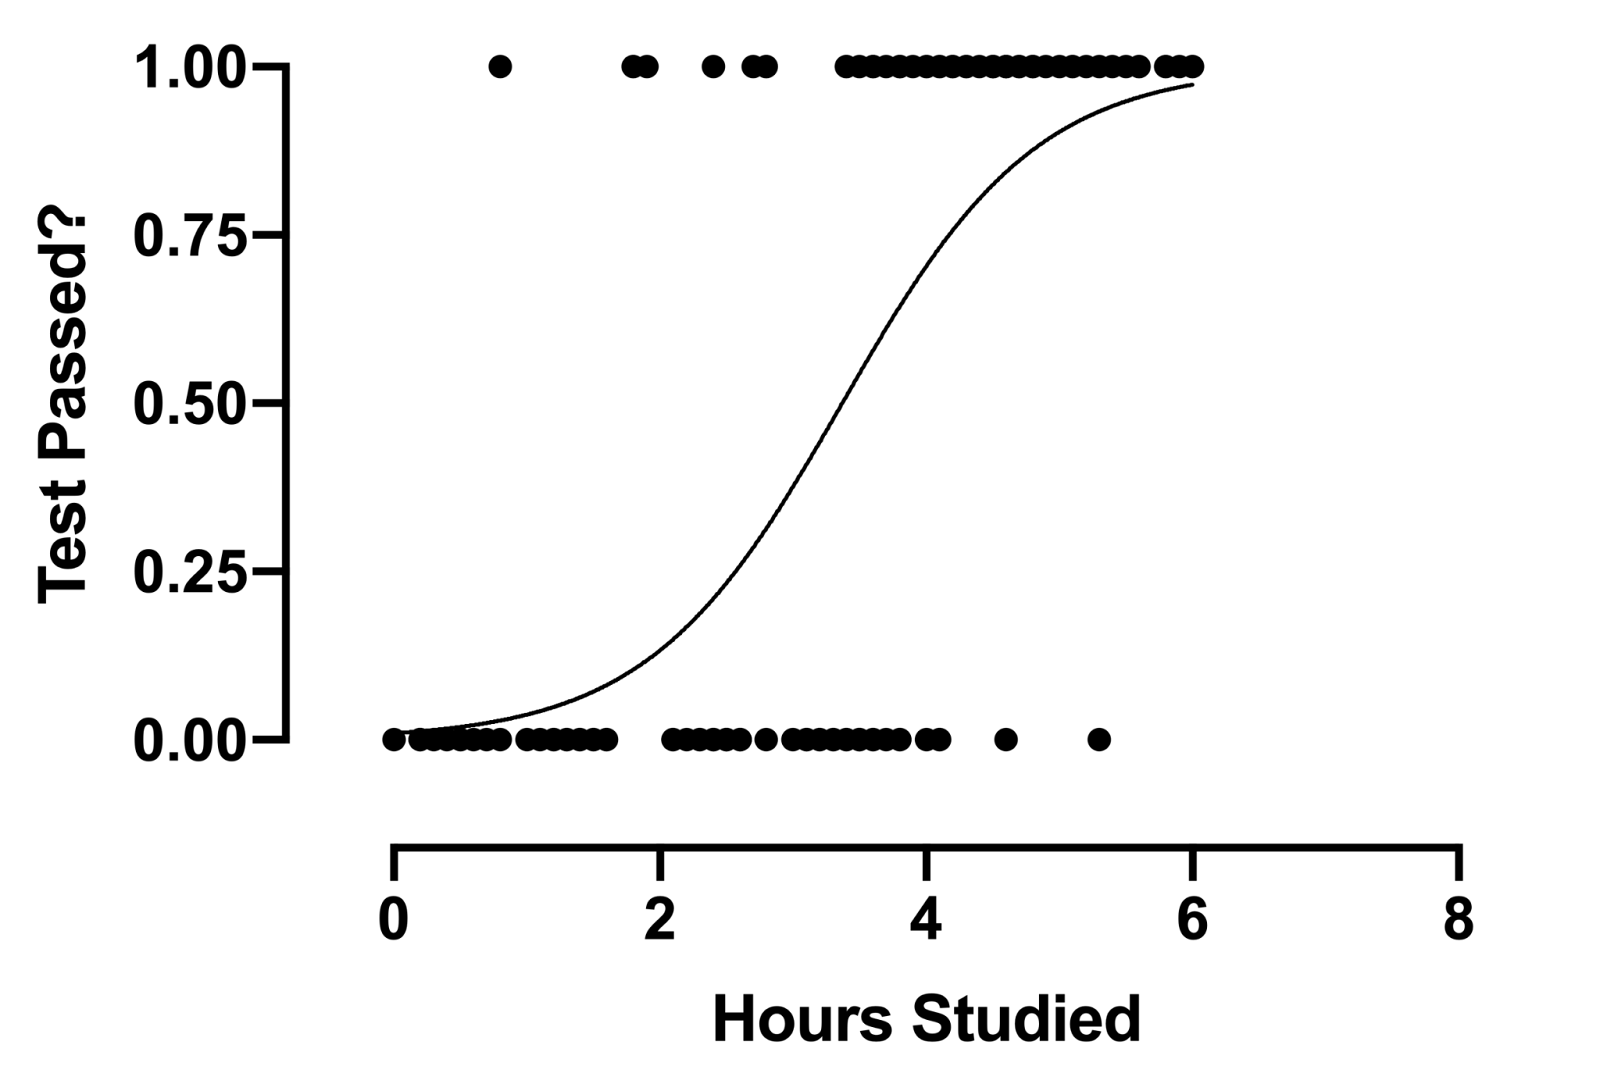
Fonte: GraphPad
Implementação Python.
Agora veremos a implementação na linguagem de programação Python. Para este exercício, usaremos o conjunto de dados da ionosfera que está disponível para download a partir do Repositório de aprendizado de máquina UCI.
# Começamos importando os pacotes necessários
# to be used for the Machine Learning problem

import pandas as pd
import numpy as np
from sklearn.linear_model import LogisticRegression
from sklearn.preprocessing import StandardScaler

# Lemos os dados para o nosso sistema usando o método do Pandas
# 'read_csv'. Isto transforma o ficheiro .csv
# num objeto Pandas DataFrame.

dataframe = pd.read_csv('ionosphere.data', header = None)

# Configuramos as definições de exibição do
# Pandas DataFrame.

pd.set_option('display.max_rows', 10000000000)
pd.set_option('display.max_columns', 10000000000)
pd.set_option('display.width', 95)

# Visualizamos a forma do dataframe. Especificamente
# o número de linhas e colunas presentes.
imprimir('Este DataFrame Tem %d Linhas e %d Colunas'%(dataframe.shape))
A saída do código anterior seria a seguinte (a forma do quadro de dados):

# Imprimimos as cinco primeiras linhas do nosso dataframe.
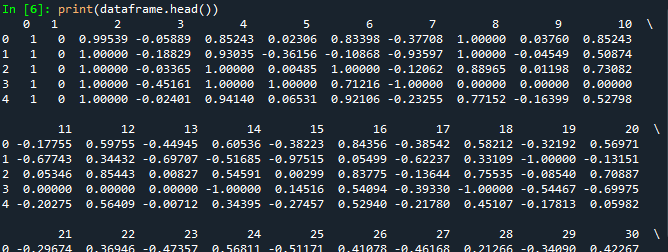
imprimir(dataframe.head())
A saída do código anterior será a seguinte (a seguinte saída está truncada):
# Isolamos a matriz de características do DataFrame.
features_matrix = dataframe.iloc[:, 0:34]

# Isolamos o vetor alvo do DataFrame.
target_vector = dataframe.iloc[:, -1]

# Verificamos a forma da matriz de características, e do vetor alvo.
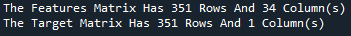
imprimir('A Matriz de Características Tem %d Linhas e %d Colunas'(s)%(features_matrix.shape))
imprimir('A Matriz Alvo Tem %d Linhas e %d Colunas'(s)%(np.array(target_vector).remodelar(-1, 1).forma))
A saída para a forma da nossa matriz de características e o vetor objetivo seria a seguinte:

# Usamos o StandardScaler do scikit-learn para
# pré-processar os dados da matriz de características. Isto irá
# garantir que todos os valores introduzidos estejam na mesma
# escala para o algoritmo.

features_matrix_standardized = StandardScaler().fit_transform(features_matrix)

# Criamos uma instância do Algoritmo LogisticRegression
# Utilizamos os valores padrão para os parâmetros e
# hiperparâmetros.

algorithm = LogisticRegression(penalty='l2', dual=False, tol=1e-4,
C=1,0, fit_intercept=True,
intercept_scaling=1, class_weight=Nenhum,
random_state = None, solver="lbfgs",
max_iter=100, multi_class="auto",
verbose = 0, warm_start=False, n_jobs=None,
l1_ratio=None)

# Utilizamos o método 'fit' para realizar o
# processo de treino na matriz das nossas características e vetor-alvo.

Logistic_Regression_Model = algoritmo.ajuste(features_matrix_standardized, target_vector)
# Criamos uma observação com valores, em ordem
# para testar o poder preditivo do nosso modelo.

observação = [[1, 0, 0.99539, -0.05889, 0.8524299999999999, 0.02306,
0.8339799999999999, -0.37708, 1.0, 0.0376,
0.8524299999999999, -0.17755, 0.59755, -0.44945, 0.60536,
-0.38223, 0.8435600000000001, -0.38542, 0.58212, -0.32192,
0.56971, -0.29674, 0.36946, -0.47357, 0.56811, -0.51171,
0.41078000000000003, -0.46168000000000003, 0.21266, -0.3409,
0.42267, -0.54487, 0.18641, -0.453]]
# Armazenamos o valor da classe prevista numa variável
# chamada 'previsões'.

previsões = Logistic_Regression_Model.prever(observação)
# Imprimimos a classe prevista do modelo para a observação.
imprimir('O Modelo Previu que a Observação Pertencesse À Classe %s'%(previsões))
La salida al bloque de código anterior deve ser la siguiente:


# Visualizamos as classes específicas para as quais o modelo foi treinado para prever.

imprimir(O Algoritmo Foi Treinado Para Prever Uma Das Duas Classes: %S'%(algorithm.classes_))
La salida al bloque de código anterior se verá de la siguiente manera:


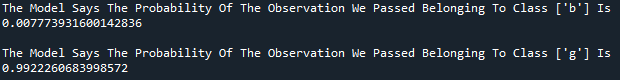
imprimir("""O modelo diz a probabilidade da observação que passámos pertencer à classe ['b'] Is %s"""%(algorithm.predict_proba(observação)[0][0]))
imprimir()
imprimir("""O modelo diz a probabilidade da observação que passámos pertencer à classe ['g'] Is %s"""%(algorithm.predict_proba(observação)[0][1]))
El resultado esperado sería el siguiente:
conclusão.
Con esto concluye mi article. Agora entendemos a lógica por detrás deste algoritmo de aprendizagem automática supervisionado e sabemos como implementarlo en um problema de classificação binaria.
Obrigado pelo seu tempo.
A mídia mostrada neste artigo não é propriedade da DataPeaker e é usada a critério do autor.





