
Este artigo foi publicado como parte do Data Science Blogathon.
Introdução
Isso tem funcionado convencionalmente com o plano de negócios e as novas tendências. Com o advento da ciência de dados e aprendizado de máquina, Diversas abordagens de pesquisa foram projetadas para automatizar este processo manual. Este processo de negociação automatizado ajudará a dar sugestões na hora certa com cálculos melhores.. Uma estratégia de negociação automatizada que oferece lucro máximo é altamente desejável para fundos mútuos e fundos de hedge.. O tipo de retorno lucrativo esperado terá algum risco potencial. Projetar uma estratégia de negociação automatizada lucrativa é uma tarefa complexa.
Todo ser humano quer ganhar seu potencial máximo no mercado de ações. É muito importante projetar uma estratégia equilibrada e de baixo risco que possa beneficiar a maioria das pessoas.. Uno de estos enfoques habla sobre el uso de agentes de Aprendizado por reforçoO aprendizado por reforço é uma técnica de inteligência artificial que permite que um agente aprenda a tomar decisões interagindo com um ambiente. Por meio de feedback na forma de recompensas ou punições, O agente otimiza seu comportamento para maximizar as recompensas acumuladas. Essa abordagem é usada em uma variedade de aplicações, De videogames a robótica e sistemas de recomendação, destacando-se por sua capacidade de aprender estratégias complexas.... para proporcionarnos estrategias comerciales automatizadas basadas en datos históricos.
Aprendizagem reforçada
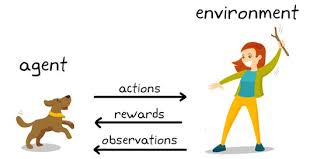
Aprendizagem por reforço é um tipo de aprendizagem de máquina em que existem ambientes e agentes. Esses agentes realizam ações para maximizar as recompensas. O aprendizado por reforço tem um potencial enorme quando usado para simulações para treinar um modelo de IA. Não há tag associada a nenhum dado, o aprendizado por reforço pode aprender melhor com muito poucos pontos de dados. Todas as decisões, neste caso, são tomadas sequencialmente. O melhor exemplo seria encontrado em Robótica e Jogos.
Q – Aprendendo
Q-learning é um algoritmo de aprendizagem por reforço sem modelo. Informa o agente sobre a ação a ser tomada com base nas circunstâncias. É um método baseado em valor que é usado para fornecer informações a um agente para uma ação iminente. É considerado um algoritmo fora da política, uma vez que a função q-learning aprende com ações que estão fora da política atual, como realizar ações aleatórias e, portanto, nenhuma política necessária.
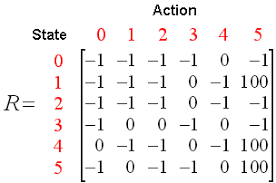
Q aqui significa qualidade. Qualidade refere-se à qualidade da ação e até que ponto essa recompensa será benéfica com base na ação realizada.. Uma tabela Q com dimensões é criada [Estado,açao]Um agente interage com o ambiente de duas maneiras: explodir e explorar. Uma opção de exploração sugere que todas as ações sejam consideradas e aquela que dê mais valor ao meio ambiente seja realizada. Uma opção de exploração é aquela em que uma ação aleatória é considerada sem considerar a recompensa futura máxima.
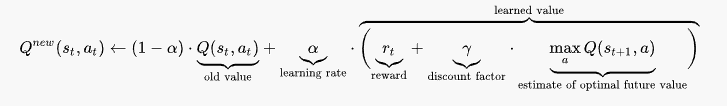
Q de st e at é representado por uma fórmula que calcula a recompensa futura máxima com desconto quando uma ação é realizada em um estado s.
La función definida nos proporcionará la recompensa máxima al final del número n de ciclos de TreinamentoO treinamento é um processo sistemático projetado para melhorar as habilidades, Conhecimento ou habilidades físicas. É aplicado em várias áreas, como esporte, Educação e desenvolvimento profissional. Um programa de treinamento eficaz inclui planejamento de metas, prática regular e avaliação do progresso. A adaptação às necessidades individuais e a motivação são fatores-chave para alcançar resultados bem-sucedidos e sustentáveis em qualquer disciplina.... o iteraciones.
A negociação pode ter as seguintes chamadas: comprar, vender ou segurar
O Q-learning avaliará cada uma das ações e aquela com o valor máximo será selecionada. O Q-Learning é baseado na aprendizagem dos valores da mesa Q. Funciona bem sem os recursos de recompensa e probabilidades de transição de estado.
Aprendizagem reforçada na negociação de ações
A aprendizagem por reforço pode resolver vários tipos de problemas. El comercio es una tarea continua sin ningún punto final. La negociación también es un proceso de decisión de Markov parcialmente observable, ya que no tenemos información completa sobre los comerciantes en el mercado. Como no conocemos la función de recompensa y la probabilidad de transición, utilizamos el aprendizaje por refuerzo sin modelo, que es Q-Learning.
Pasos para ejecutar un agente de RL:
-
Instalar bibliotecas
-
Obtenha os dados
-
Definir el agente de Q-Learning
-
Treine o agente
-
Prueba al agente
-
Trazar las señales
Instalar bibliotecas
Instale e importe as bibliotecas financeiras necessárias do NumPy, pandas, matplotlib, seaborn e yahoo.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
sns.set()
!pip install yfinance --upgrade --no-cache-dir
from pandas_datareader import data as pdr
import fix_yahoo_finance as yf
from collections import deque
import random
Import tensorflow.compat.v1 as tf
tf.compat.v1.disable_eager_execution()
Obtenha os dados
Utilize a biblioteca Yahoo Finance para obter os dados de uma ação em particular. As ações utilizadas aqui para a nossa análise são as ações da Infosys.
yf.pdr_override()
df_full = pdr.get_data_yahoo("INFY", start ="2018-01-01").reset_index()
df_full.to_csv(‘INFY.csv',index = False)
df_full.head()
Este código criará um DataFrame chamado df_full que conterá os preços das ações da INFY ao longo de 2 anos.
Definir el agente de Q-Learning
A primeira função é a classe Agente que define o tamanho do estado, tamanho da janela, Tamanho do lote, deque que é a memória utilizada, inventário como uma lista. Defina também algumas variáveis estáticas como épsilon, decair, gama, etc. São definidas duas camadas de neuronal vermelhoAs redes neurais são modelos computacionais inspirados no funcionamento do cérebro humano. Eles usam estruturas conhecidas como neurônios artificiais para processar e aprender com os dados. Essas redes são fundamentais no campo da inteligência artificial, permitindo avanços significativos em tarefas como reconhecimento de imagem, Processamento de linguagem natural e previsão de séries temporais, entre outros. Sua capacidade de aprender padrões complexos os torna ferramentas poderosas.. para a compra, reter e vender chamadas. GradientDescentOptimizer também é usado.
O Agente definiu funções para opções de chamada e venda. A função get_state e act faz uso da rede neural para gerar o próximo estado da rede neural. As recompensas são subsequentemente calculadas adicionando ou subtraindo o valor gerado pela execução da opção de chamada. A ação realizada no próximo estado é influenciada pela ação realizada no estado anterior. 1 refere-se a uma chamada de compra, enquanto que 2 refere-se a uma chamada de vendas. Em cada iteração, o estado é determinado com base no qual se toma uma ação que comprará ou venderá algumas ações. As recompensas gerais são armazenadas na variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos.... do lucro total.
df= df_full.copy()
nome ="Agente Q-learning"
classe Agente:
    def __init__(auto, state_size, window_size, tendência, pular, tamanho do batch):
        self.state_size = state_size
        self.window_size = window_size
        self.half_window = window_size // 2
        self.trend = trend
        self.skip = skip
        self.action_size = 3
        self.batch_size = batch_size
        self.memory = deque(maxlen = 1000)
        auto.inventário = []
        self.gamma = 0.95
        self.epsilon = 0.5
        self.epsilon_min = 0.01
        self.epsilon_decay = 0.999
        tf.reset_default_graph()
        self.sess = tf.InteractiveSession()
        self.X = tf.placeholder(tf.float32, [Nenhum, self.state_size])
        self.Y = tf.placeholder(tf.float32, [Nenhum, self.action_size])
        feed = tf.layers.dense(self.X, 256, activação = tf.nn.relu)
        self.logits = tf.layers.dense(feed, self.action_size)
        self.custo = tf.reduce_mean(tf.square(self.Y - self.logits))
        self.otimizador = tf.train.GradientDescentOptimizer(1e-5).minimizar(
            self.custo
        )
        self.sess.run(tf.global_variables_initializer())
    def atuar(auto, Estado):
        se random.random() <= self.epsilon:
            retorno aleatório.randrange(self.action_size)
        retorno np.argmax(
            self.sess.run(self.logits, feed_dict = {self.X: Estado})[0]
        )
    def obter_estado(auto, t):
        tamanho_janela = self.window_size + 1
        d = t - window_size + 1
        bloco = self.trend[d : t + 1] se d >= 0 outra coisa -d * [self.trend[0]] + self.trend[0 : t + 1]
        res = []
        para eu no alcance(window_size - 1):
            res.append(bloquear[eu + 1] - bloquear[eu])
        retorno np.array([res])
    def reproduzir(auto, tamanho do batch):
        mini_batch = []
        l = len(auto.memória)
        para eu no alcance(eu - tamanho do batch, eu):
            mini_batch.append(auto.memória[eu])
        tamanho_replay = len(mini_lote)
        X = np.empty((tamanho_replay, self.state_size))
        Y = np.empty((tamanho_replay, self.action_size))
        estados = np.array([uma[0][0] para a em mini_lote])
        novos_estados = np.array([uma[3][0] para a em mini_lote])
        Q = self.sess.run(self.logits, feed_dict = {self.X: estados})
        Q_novo = self.sess.run(self.logits, feed_dict = {self.X: novos_estados})
        para eu no alcance(len(mini_lote)):
            Estado, açao, recompensa, next_state, concluído = mini_lote[eu]
            alvo = Q[eu]
            alvo[açao] = reward
            if not done:
                alvo[açao] += self.gamma * np.amax(Q_novo[eu])
            X[eu] = state
            Y[eu] = target
        cost, _ = self.sess.run(
            [self.custo, self.otimizador], feed_dict = {self.X: X, self.Y: E}
        )
        se self.epsilon > self.epsilon_min:
            self.epsilon *= self.epsilon_decay
        return cost
    def buy(auto, dinheiro_inicial):
        starting_money = initial_money
        states_sell = []
        states_buy = []
        inventário = []
        state = self.get_state(0)
        para t no intervalo(0, len(self.trend) - 1, self.skip):
            ação = self.act(Estado)
            next_state = self.get_state(t + 1)
            se a ação == 1 e dinheiro_inicial >= self.trend
                inventário.append(self.trend
                dinheiro_inicial -= self.trend
                states_buy.append
                print('dia %d: comprar 1 unidade ao preço %f, saldo total %f'% (t, self.trend
            elif ação == 2 e len(inventário):
                preço_compra = inventário.pop(0)
                dinheiro_inicial += self.trend
                states_sell.append
                try:
                    investir = ((fechar
                exceto:
                    investir = 0
                imprimir(
                    'dia %d, vender 1 unidade ao preço %f, investimento %f %%, saldo total %f,'
                    % (t, fechar
                )
            state = next_state
        invest = ((dinheiro_inicial - dinheiro_inicial) / dinheiro_inicial) * 100
        ganhos_totais = dinheiro_inicial - starting_money
        return states_buy, states_sell, total_gains, invest
    def train(auto, Iterações, Ponto de verificação, dinheiro_inicial):
        para eu no alcance(Iterações):
            total_profit = 0
            inventário = []
            state = self.get_state(0)
            starting_money = initial_money
            for t in range(0, len(self.trend) - 1, self.skip):
                ação = self.act(Estado)
                next_state = self.get_state(t + 1)
                se a ação == 1 e starting_money >= auto.tendência
 inventário.anexar(auto.tendência
 starting_money -= self.trend
 ação Elif == 2 e len(inventário) > 0:
                    preço_compra = inventário.pop(0)
                    total_profit += self.trend
 starting_money += self.trend
 investir = ((dinheiro_inicial - dinheiro_inicial) / dinheiro_inicial)
                self.memory.append((Estado, açao, investir,
                                    next_state, dinheiro_inicial < dinheiro_inicial))
                state = next_state
                batch_size = min(self.batch_size, len(auto.memória))
                custo = auto.repetição(tamanho do batch)
            E se (i+1) % checkpoint == 0:
                imprimir('época: %d, recompensas totais: %f.3, custar: %f, dinheiro total: %f'%(eu + 1, total_profit, custar,
                                                                                  dinheiro_inicial))
Treine o agente
Una vez definido el agente, inicialícelo. Especifique el número de iteraciones, dinero inicial, etc. para capacitar al agente para que decida las opciones de compra o venta.
close = df. Close.values.tolist()
initial_money = 10000
window_size = 30
skip = 1
batch_size = 32
agente = Agente(state_size = window_size,
              window_size = window_size,
              trend = close,
              skip = skip,
              batch_size = batch_size)
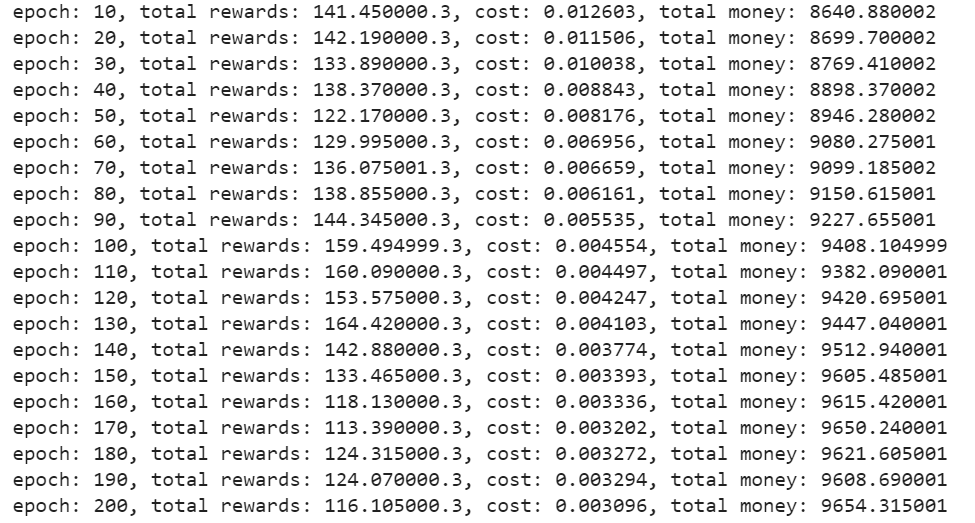
agent.train(iterações = 200, checkpoint = 10, initial_money = initial_money)
Produção –
Prueba al agente
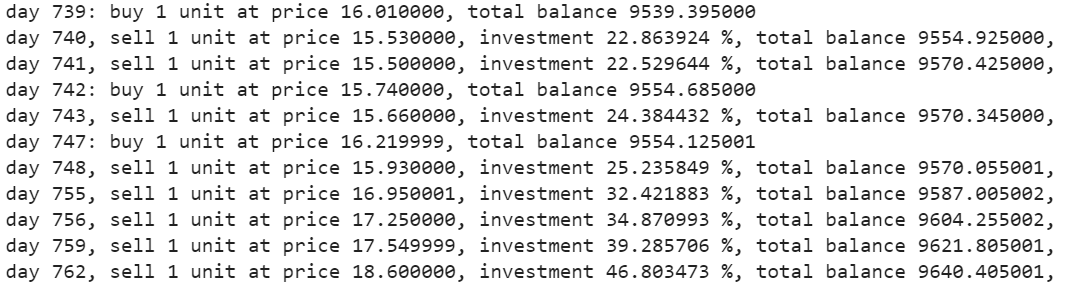
La función de compra devolverá las cifras de compra, oferta, lucro e investimento.
estados_comprar, states_sell, total_gains, invest = agent.buy(initial_money = initial_money)
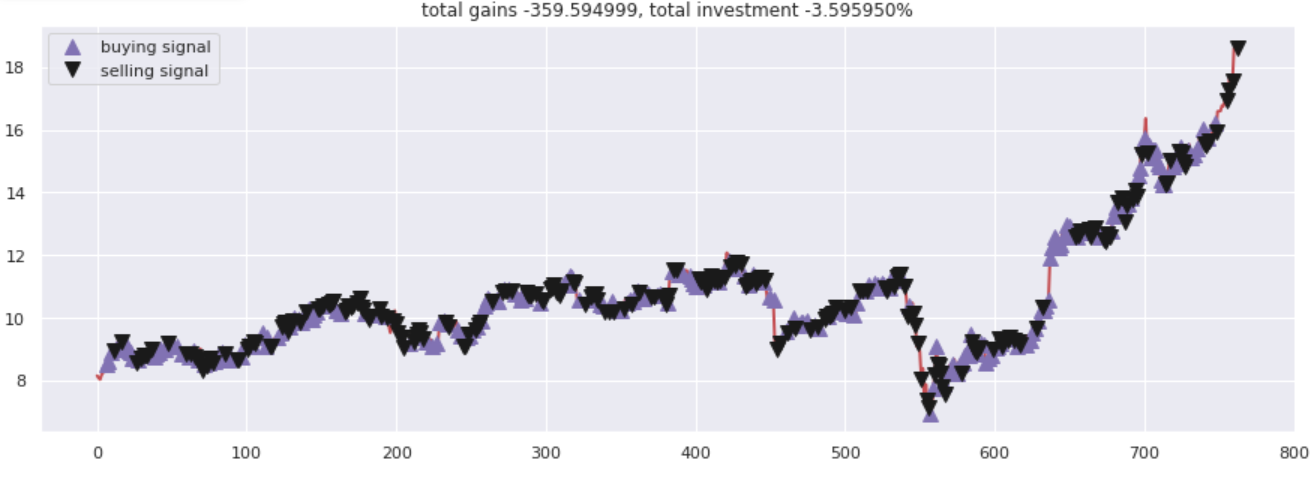
Rastrear chamadas
Traçar ganhos totais versus valores investidos. Todas as opções de compra e venda foram devidamente marcadas de acordo com as opções de compra / venda sugerida por rede neural.
fig = plt.figure(figsize = (15,5))
plt.plot(fechar, color ="r", lw = 2.)
plt.plot(fechar, '^', markersize = 10, color ="m", rótulo ="sinal de compra", markevery = states_buy)
plt.plot(fechar, 'v', markersize = 10, color ="k", rótulo ="sinal de venda", markevery = states_sell)
plt.title('total gains %f, total investimento %f%'%(total_gains, investir))
plt.legend()
plt.savefig(name+'.png')
plt.show()
Produção –
Notas finais
Q-Learning é uma técnica que o ajuda a desenvolver uma estratégia de negociação automatizada. Pode ser usado para experimentar opções de compra ou venda. Existem muitos outros agentes de aprendizagem por reforço comerciais para experimentar. Tente brincar com os diferentes tipos de agentes RL com ações diferentes.
A mídia mostrada neste artigo não é propriedade da DataPeaker e é usada a critério do autor.





