
Introdução:
datos no estructurados en un formato estructurado? Aquí es donde entra en escena el Web Scraping.
O que é Web Scraping?
En lenguaje sencillo, Raspado web, cosecha web, o extracción de datos web es un proceso automatizado de recopilación de datos grandes (não estruturado) de sitios web. El usuario pode extrair todos los dados en sitios particulares o los datos específicos según el requisito. Los datos recopilados se pueden almacenar en un formato estruturado para su posterior análisis.
Usos del web scraping:
No mundo real, el web scraping ha ganado mucha atenção y tiene una amplia gama de usos. Alguns deles estão listados abaixo:
- Análise del sentimiento de las redes sociales
- Geração de leads en el domínio de marketing
- Análise de mercado, comparação de precios en línea en el domínio de comércio electrónico
- Recopile datos de TreinamentoO treinamento é um processo sistemático projetado para melhorar as habilidades, Conhecimento ou habilidades físicas. É aplicado em várias áreas, como esporte, Educação e desenvolvimento profissional. Um programa de treinamento eficaz inclui planejamento de metas, prática regular e avaliação do progresso. A adaptação às necessidades individuais e a motivação são fatores-chave para alcançar resultados bem-sucedidos e sustentáveis em qualquer disciplina.... y prueba en aplicaciones de aprendizaje automático
Pasos involucrados en el web scraping:
- Busque la URL de la página web que desea raspar
- Seleccione los elementos particulares inspeccionando
- Escribe el código para obter el contenido de los elementos seleccionados
- Armazene los datos en el formato requerido
¡¡Así de simples chicos .. !!
Las bibliotecas / herramientas populares que se utilizan para el web scraping son:
- Selénio: un marco para probar aplicaciones web
- BeautifulSoup: biblioteca de Python para obter datos de HTML, XML y otros lenguajes de marcado
- Pandas: biblioteca de Python para manipulación y análisis de datos
Neste artigo, crearemos nosso próprio conjunto de datos extrayendo reseñas de Domino's Pizza del sitio web. consumeraffairs.com/food.
Nós vamos usar vamos cobri-los mais tarde neste artigo e Sopa linda por raspado y análisis os dados.
Paso 1: procure a URL da página web que deseja raspar
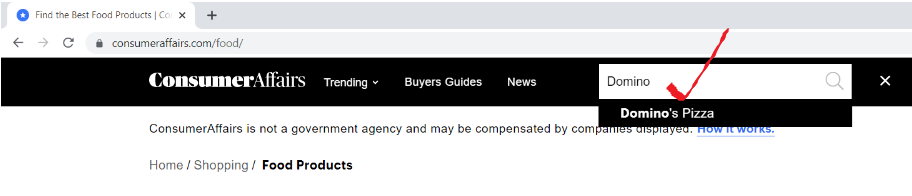
Abra a URL “consumeraffairs.com/foodE procure Domino's Pizza na barra de pesquisa e prima Enter.
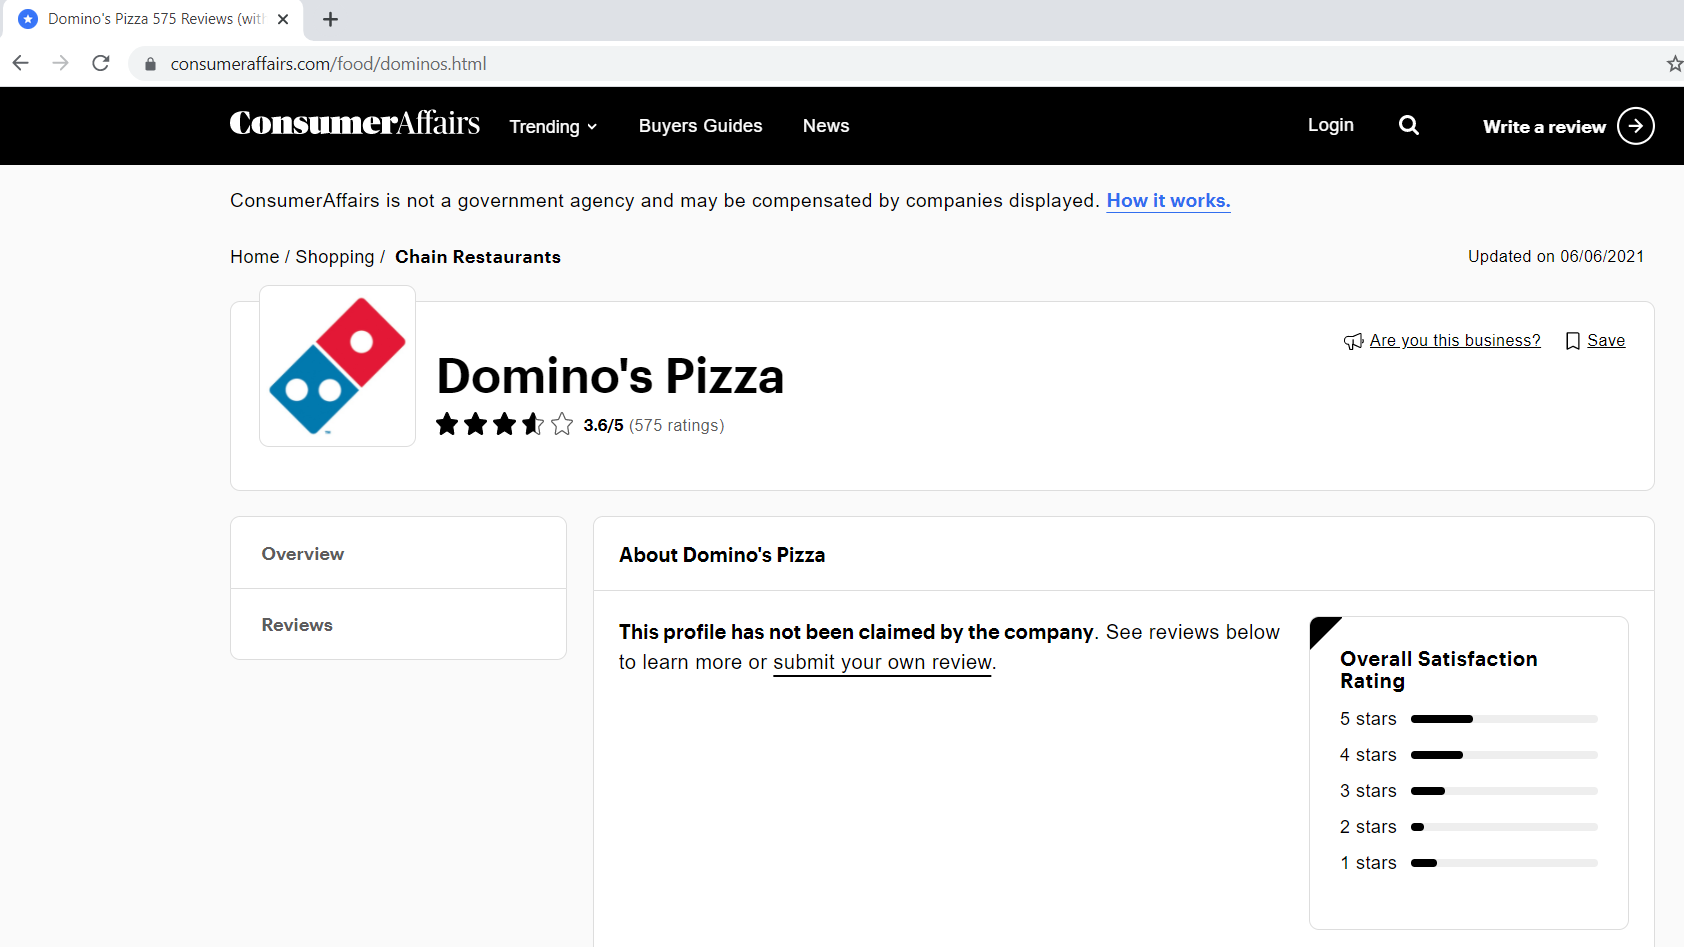
A seguir é mostrado como a nossa página de avaliações se apresenta.
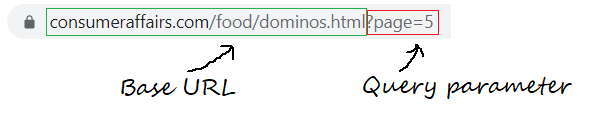
Paso 1.1: Definição da URL base, parametroso "parametros" são variáveis ou critérios usados para definir, medir ou avaliar um fenômeno ou sistema. Em vários domínios, como a estatística, Ciência da Computação e Pesquisa Científica, Os parâmetros são essenciais para estabelecer normas e padrões que orientam a análise e interpretação dos dados. Sua seleção e manuseio adequados são cruciais para obter resultados precisos e relevantes em qualquer estudo ou projeto.... de consulta
A URL base é a parte consistente do seu endereço web e representa o caminho para a função de pesquisa do site.
base_url = "https://www.consumeraffairs.com/food/dominos.html?page ="
Os parâmetros de consulta representam valores adicionais que podem ser declarados na página.
query_parameter = "?page ="+str(eu) # i representa o número da página
Paso 2: selecione os elementos específicos inspecionando
A seguir é apresentada uma imagem de uma avaliação de exemplo. Cada reseña tiene muchos elementos: la calificación otorgada por el usuario, o nome de usuário, la fecha de la reseña y el texto de la reseña junto con alguna información sobre cuántas personas le gustó.
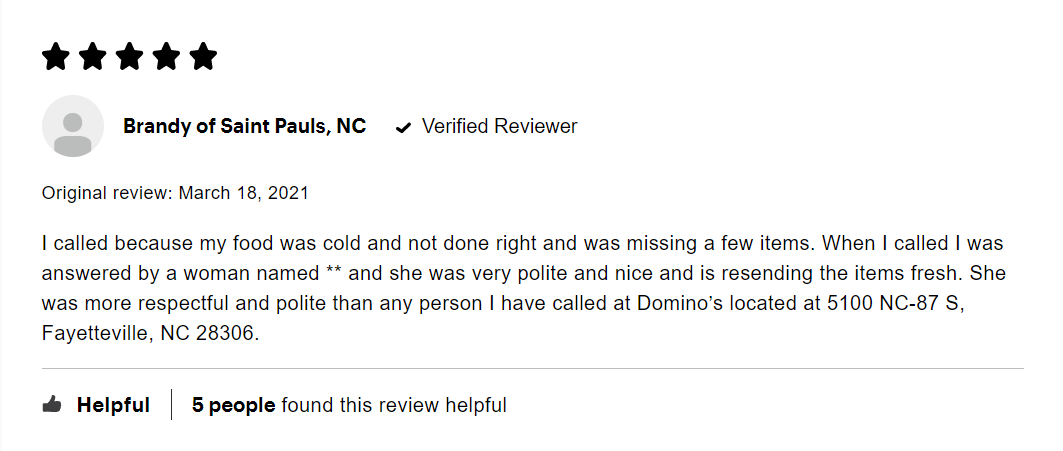
Nuestro interés es extraer solo el texto de la reseña. Para isso, necesitamos inspeccionar la página y obtener las etiquetas HTML, los nombres de los atributos del elemento de destino.
Para inspeccionar una página web, haga clic con el botón derecho en la página, seleccione Inspeccionar o use el atajo de teclado Ctrl + Mudança + eu.
No nosso caso, el texto de revisión se almacena en la etiqueta HTML
del div con el nombre de clase “rvw-bd“
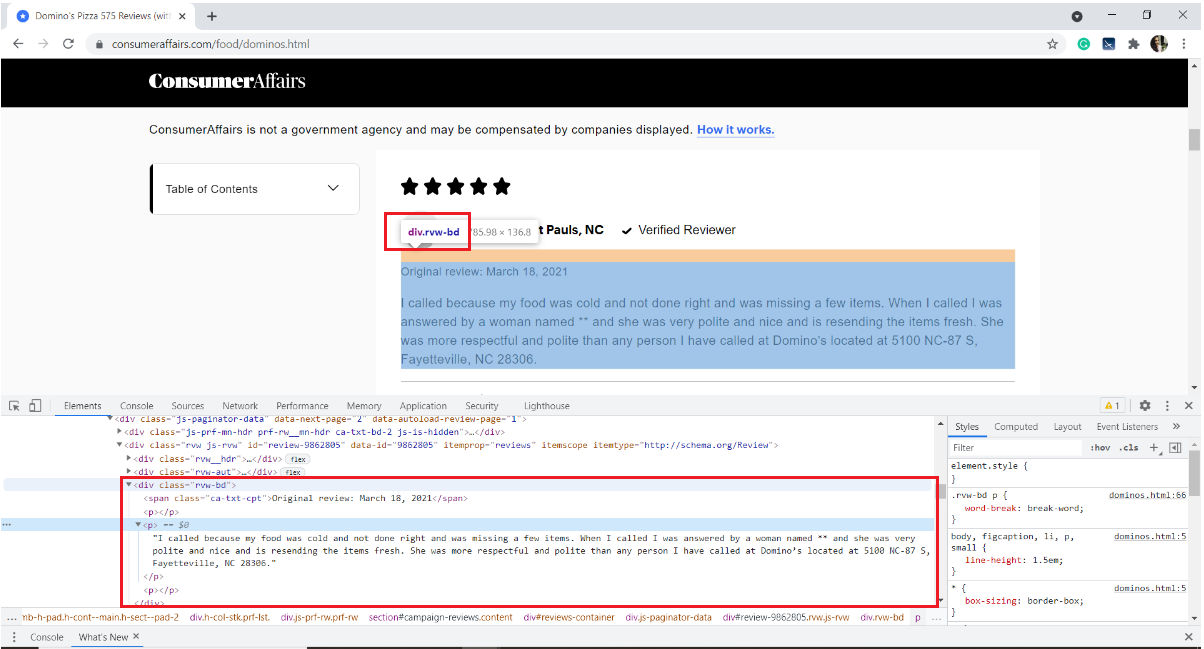
Com isto, nos familiarizamos con la página web. Saltemos rápidamente al raspado.
Paso 3: Escribe el código para obter el contenido de los elementos seleccionados
Comience instalando los módulos / paquetes necesarios
pip install pandas requests BeautifulSoup4
Importar bibliotecas necessárias
import pandas as pd
import requests
from bs4 import BeautifulSoup as bs
pandas – para criar um marco de datos
solicitudes: para enviar pedidos HTTP e aceder ao conteúdo HTML desde a página web de destino
BeautifulSoup: es una biblioteca de Python para analisar dados HTML estruturados
Cree una lista vacía para almacenar todas las reseñas extraídas
all_pages_reviews = []
definir una función de raspador
def scraper():
Dentro de la función de raspador, escriba un para que el bucle recorra el número de páginas que le gustaría raspar. Me gustaría raspar las reseñas de cinco páginas.
para eu no alcance(1,6):
Creating una lista vacía para almacenar las reseñas de cada página (a partir de 1 uma 5)
pagewise_reviews = []
Construye la URL
url = base_url + query_parameter
Envie o pedido HTTP para a URL através de requests e armazene a resposta
resposta = solicitações.get(url)
Crie um objeto soup e analise a página HTML
soup = bs(response.content, 'html.parser')
Encontre todos os elementos div com o nome da classe “rvw-bd” e guarde-os em uma variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos....
rev_div = soup.findAll("Div",attrs={"classe","rvw-bd"})
Percorra todo o rev_div e adicione o texto da revisão à lista pagewise
para j no intervalo(len(rev_div)):
			# finding all the p tags to fetch only the review text
			pagewise_reviews.append(rev_div[j].achar("p").texto)
Anexar todas as reviews das páginas numa única lista “all_pages sobre”
para k em alcance(len(pagewise_reviews)):
   all_pages_reviews.append(pagewise_reviews[k])
No final da função, devolve a lista final de reviews.
return all_pages_reviews
Chame a função scraper() e guarde o output numa variável 'reviews'
# Driver code
reviews = scraper()
Paso 4: armazene os dados no formato exigido
4.1 armazenamento num DataFrame do pandas
i = range(1, len(avaliações)+1)
reviews_df = pd.DataFrame({'review':avaliações}, index=i)
Agora vamos dar uma vista de olhos no nosso conjunto de dados
imprimir(reviews_df)
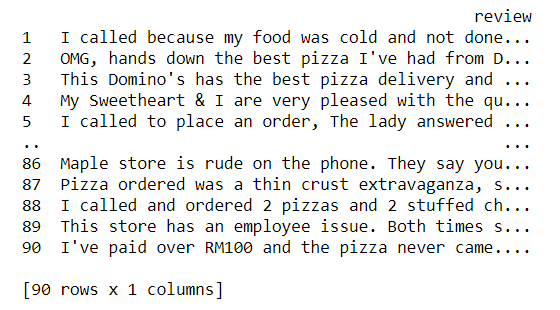
4.2 Escrever o conteúdo do DataFrame num ficheiro de texto
reviews_df.to_csv('reviews.txt', sep='t')
Com isto, Terminámos de extrair as avaliações e armazená-las num ficheiro de texto. Mmm, é bastante simples, não?
Código Python completo:
# !pip install pandas requests BeautifulSoup4
import pandas as pd
import requests
from bs4 import BeautifulSoup as bs
base_url = "https://www.consumeraffairs.com/food/dominos.html"
all_pages_reviews =[]
-
def scraper():
    para eu no alcance(1,6): # fetching reviews from five pages
        pagewise_reviews = []
        query_parameter = "?page ="+str(eu)
	url = base_url + query_parameter
	response = requests.get(url)
	soup = bs(response.content, 'html.parser')
	rev_div = soup.findAll("Div",attrs={"classe","rvw-bd"})

    para j no intervalo(len(rev_div)):
    # finding all the p tags to fetch only the review text
        pagewise_reviews.append(rev_div[j].achar("p").texto)

    para k em alcance(len(pagewise_reviews)):
        all_pages_reviews.append(pagewise_reviews[k])
        return all_pages_reviews

# Driver code
reviews = scraper()
i = range(1, len(avaliações)+1)
reviews_df = pd.DataFrame({'review':avaliações}, index=i)
reviews_df.to_csv('reviews.txt', sep='t')
Notas finais:
No final deste artigo, aprendemos o processo passo a passo de extrair conteúdo de qualquer página web e guardá-lo num ficheiro de texto.
- inspecionar o elemento alvo utilizando as ferramentas de desenvolvimento do navegador
- utilizar requests para descarregar o conteúdo HTML
- analisar o conteúdo HTML usando BeautifulSoup para extrair os dados necessários
Podemos desenvolver mais este exemplo raspando nomes de utilizador, revisando texto. Realizar uma vetorização no texto de revisão limpo e agrupar os utilizadores de acordo com as revisões escritas. Podemos usar Word2Vec ou CountVectorizer para converter texto em vetores e aplicar qualquer um dos algoritmos de agrupamentoo "agrupamento" É um conceito que se refere à organização de elementos ou indivíduos em grupos com características ou objetivos comuns. Este processo é usado em várias disciplinas, incluindo psicologia, Educação e biologia, para facilitar a análise e compreensão de comportamentos ou fenômenos. No campo educacional, por exemplo, O agrupamento pode melhorar a interação e o aprendizado entre os alunos, incentivando o trabalho.. Machine Learning.
Referências:
Biblioteca BeautifulSoup: Documentação, Tutorial em vídeo
Link do repositório GitHub para descarregar o código fonte
Espero que este blog ayude a comprender el web scraping en Python usando la biblioteca BeautifulSoup. Boa aprendizagem !! 😊
A mídia mostrada neste artigo não é propriedade da DataPeaker e é usada a critério do autor.





