
Este artigo foi publicado como uma entrada para o Data Science Blogathon.
Introdução
As cadeias de Markov são excepcionalmente úteis para modelar um processo estocástico em espaço discreto em tempo discreto de vários domínios, como finanças. (movimento do preço das ações), Algoritmos de PNL (transdutores de estado finito, Modelo oculto de Markov para rotulagem de PDV), ou mesmo em engenharia física ( movimento browniano).
Tendo em conta a imensa utilidade deste conceito em vários domínios e a sua importância fundamental para um número significativo de algoritmos em ciência de dados, vamos cobrir neste artigo os seguintes aspectos da Cadeia de Markov:
- Formulação da cadeia de Markov e explicação intuitiva
- Aspectos e características de uma cadeia de Markov
- Aplicativos e casos de uso
Formulação da cadeia de Markov e explicação intuitiva
Para entender o que é uma cadeia de Markov, primeiro vamos ver o que é um processo estocástico, uma vez que a cadeia de Markov é um tipo especial de processo estocástico.
Um processo estocástico é definido como uma coleção de variáveis aleatórias X = {Xt: t∈T} definido em um espaço de probabilidade comum, tomando valores em um conjunto comum S (espaço estadual), e indexado por um conjunto T, Não frequente [0, ∞) e pensado como o tempo (discreto ou contínuo respectivamente) (Oliver, 2009). Isso significa que temos observações em um determinado momento e o resultado é aleatório variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos..... Basta colocar, um processo estocástico é qualquer processo que descreve a evolução no tempo de um fenômeno aleatório.
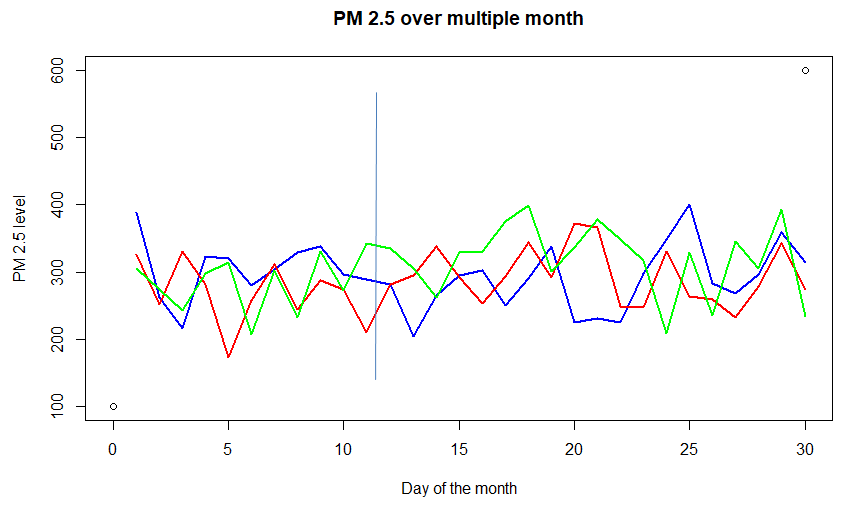
Considere o gráfico acima de concentração de PM (assunto particular) 2.5 no ar sobre uma cidade por diferentes meses. Cada uma das linhas coloridas - vermelho, azul, e verde - (chamado caminho de amostra) representa uma função aleatória de tempo. Também, considere qualquer dia (diga 15 de cada mês), representa uma variável aleatória. Portanto, pode ser considerado um processo estocástico, ou seja, um processo que leva diferentes entradas funcionais em momentos diferentes. Este exemplo particular é um caso para tempo discreto (como o tempo não é contínuo, observado uma vez por dia) com um estado contínuo (pode assumir qualquer valor positivo, não necessariamente um inteiro).
Agora que temos uma intuição básica de um processo estocástico, vamos começar a entender um dos conceitos matemáticos mais úteis para a ciência de dados: Cadeias de Markov!
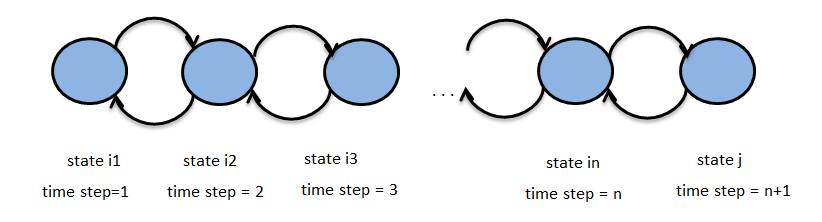
A figura acima representa uma cadeia de Markov, com estados eu1, eu2 ,… , eun , j para passos de tempo 1, 2, .., n + 1. Deixar {COMn}n∈N ser o processo estocástico acima com espaço de estado S. N aqui é o conjunto de inteiros e representa o horário definido e Zn representa o Estado da cadeia de Markov no tempo n. Suponha que temos a propriedade :
P(COMn + 1 = j | COMn = in , COMn-1 = in-1 , … , COM1 = i1) = P(COMn + 1 = j | COMn = in)
então {COMn}n∈N é chamado de Cadeia de Markov.
Este termo P(COMn + 1 = j | COMn= in) é chamado probabilidade de transição. Assim, podemos ver intuitivamente que, a fim de descrever a Cadeia de Markov probabilisticamente, nós precisamos (uma) a distribuição de estado inicial e (b) probabilidades de transição.
Vamos pegar a Cadeia de Markov mostrada abaixo para entender esses dois termos mais formalmente,
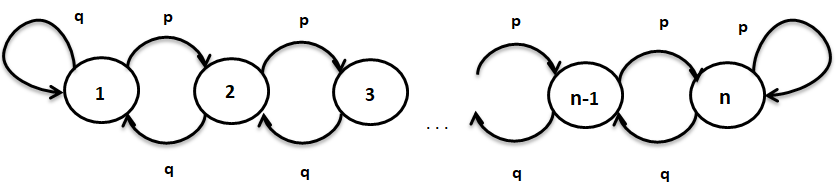
Na cadeia de Markov acima, estados são 1, 2, …, ne a probabilidade de ir de qualquer estado k para k + 1 (para k = 1, 2, …, n-1) é p e indo do estado k para k-1 é q, onde"ONDE" é um termo em inglês que se traduz como "Onde" em espanhol. Usado para fazer perguntas sobre a localização das pessoas, Objetos ou eventos. Em contextos gramaticais, Pode funcionar como advérbio de lugar e é fundamental na formação de perguntas. Sua correta aplicação é essencial na comunicação cotidiana e no ensino de idiomas, facilitando a compreensão e troca de informações sobre posições e direções.... q = 1-p.
- o distribuição de estado inicial é definido como
Pi(0) = [P(X0= 1), P(X0= 2), … , P(X0 = n)]
A expressão anterior é um vetor linha com elemento que denota a probabilidade de que a cadeia de Markov tenha o estado i, onde i = 1, 2,…, n. Todos os elementos deste vetor somam 1.
- a matriz de probabilidade de transição é como mostrado abaixo :
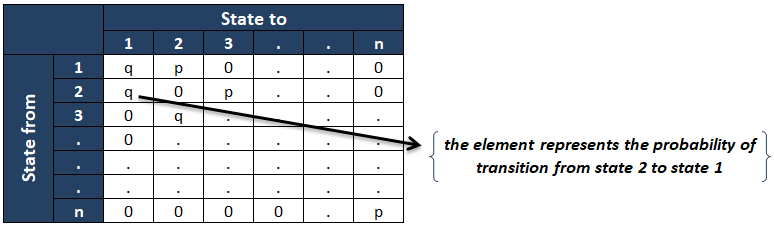
El ijº elemento da matriz de probabilidade de transição representa o a probabilidade condicional da cadeia está no estado j, pois estava no estado i no momento anterior. Se a matriz de probabilidade de transição não depende de “n” (clima), então a corrente é chamada a Cadeia de Markov homogênea.
Aspectos e características de uma cadeia de Markov
Nesta secção, veremos os seguintes aspectos principais de uma cadeia de Markov:
- Hora do primeiro hit: geu(k)
- Tempo médio de impacto (tempo de absorção): hUMA(k)
O objetivo das duas análises anteriores é que, se tivermos um conjunto de estados desejados (digamos um), e queremos calcular quanto tempo levará para atingir o estado desejado.
Primeira hora de golpe
Imagine, se quisermos saber a probabilidade (condicional) que nossa cadeia de Markov, que começa em algum estado inicial k, alcançar o estado l (um dos muitos estados desejados em A) contanto que alcance qualquer estado em A. Como fazemos isso? esse?
Vamos entender definindo alguns termos básicos. Deixe TUMA seja o primeiro tempo que leva para alcançar qualquer um dos estados no conjunto A e k seja algum estado no espaço de estados, mas não em A.
Deixe geu(k) ser definido como a probabilidade condicional de atingir o estado l no tempo TUMA do estado k.
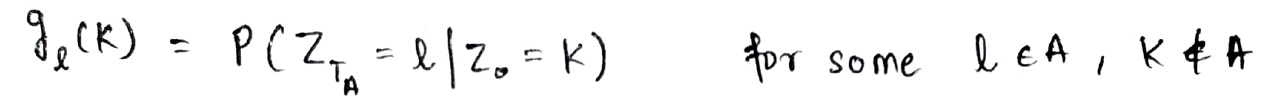
Agora, usando a propriedade Markov, Vamos considerar a passagem do estado no tempo = 0 para o estado no tempo = TUMA como passar o estado no tempo = 0 para o estado no tempo = 1 e depois ir de um estado para outro = 1 para o estado no tempo = TA. O mesmo é representado abaixo:
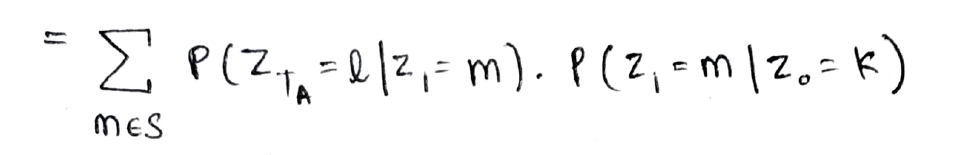
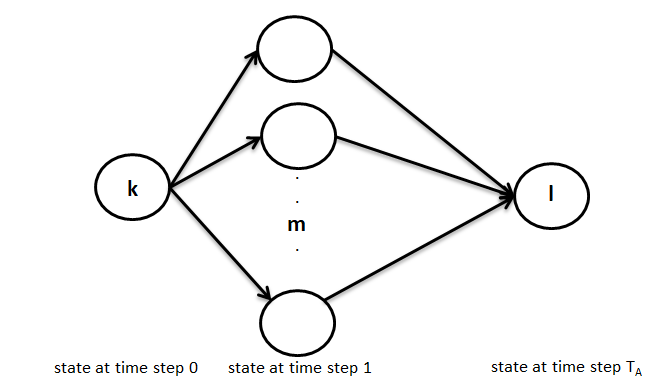
A equação acima pode ser interpretada graficamente como mostrado abaixo, quer dizer, na primeira etapa, você pode ir do estado k para qualquer um dos estados m em uma etapa e depois ir em TUMA-1 passagem do estado m para o estado desejado l.
Agora, o primeiro termo pode ser representado como geu(m) e o segundo termo representa a probabilidade de transição do estado k para o estado m
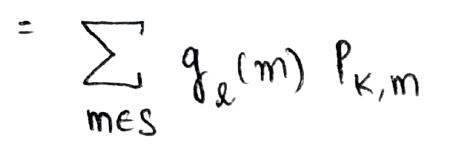
Esta é a maneira recursiva que calculamos a probabilidade desejada e a abordagem usada acima é chamada Análise do primeiro passo (ao analisá-lo em termos da primeira etapa que o estado leva no tempo = 0 para o estado no tempo = 1)
Tempo médio de acerto
Usando uma abordagem semelhante à acima, também podemos calcular o tempo médio (esperado) para alcançar um conjunto desejado de estados (digamos um) de um estado k de A.
Definamos hUMA(k) como o tempo esperado necessário para atingir um conjunto A do estado k. Isso é definido conforme mostrado abaixo:
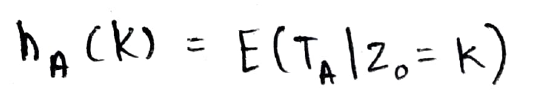
Agora que sabemos qual é a primeira etapa da análise, Por que não usar de novo?
Então, agora escrevemos o termo de expectativa em termos da primeira etapa (quer dizer, alcançar o estado Z1) Como mostrado abaixo:
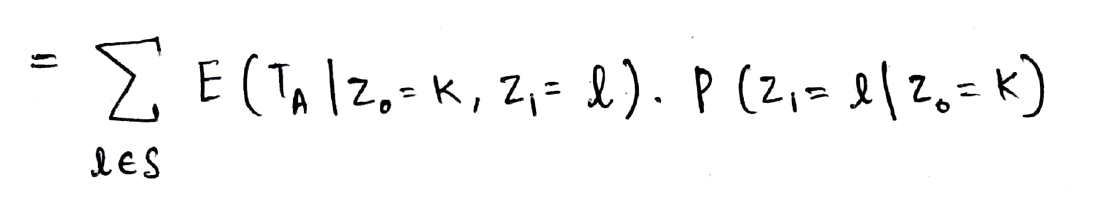
Agora, usando a propriedade Markov, podemos eliminar o Z0 termo como conhecemos o estado em Z1. O segundo termo no produto acima é a probabilidade de transição do estado k para o estado l (vimos tanto esse conceito que agora parece um cálculo 2 + 2 = 4 🙂)
Observe que o termo de expectativa abaixo é em termos de Z1 (e não Z0) e, portanto, não podemos escrevê-lo diretamente como hUMA(k). Portanto, nós usamos um truque de matemática, nós adicionamos 1 na expectativa e subtraímos 1 também para que possamos escrever matematicamente o estado como Z0 = l
E agora podemos escrever como hUMA(k).
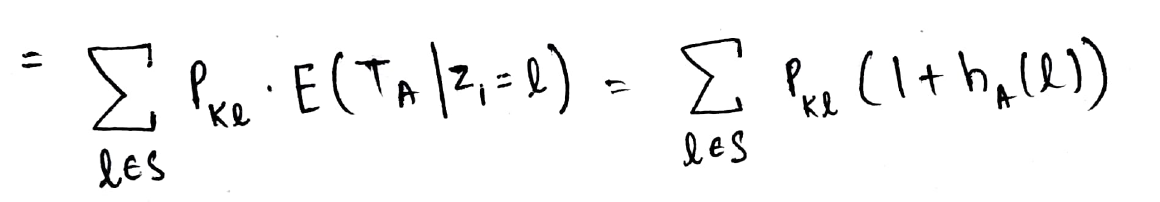
Esta é a forma recursiva de calcularmos a Expectativa desejada!!
Agora sabemos a abordagem fundamental para derivar qualquer propriedade de Markov com as duas novas ferramentas que temos: Compreensão de matriz de probabilidade de transição e Abordagem de análise de primeira etapa.
Aplicativos e casos de uso
Uma vez que agora estamos confortáveis com o conceito e os aspectos de uma cadeia de Markov, Vamos explorar e compreender intuitivamente a seguinte aplicação e casos de uso de cadeias de Markov.
- PNL: modelo de Markov oculto para etiquetagem de ponto de venda
- Caminhada aleatória como uma cadeia de Markov
PNL: modelo de Markov oculto para etiquetagem de ponto de venda
Rotulagem de classes gramaticais (POS) é uma aplicação importante da PNL. O objetivo nesses problemas é marcar cada palavra em uma determinada frase com um POS apropriado (substantivo, verbo, advérbio, etc.). No modelo, temos probabilidades de transição de rótulo, quer dizer, uma vez que o rótulo da palavra anterior é dito ti-1, O teu será o rótulo da palavra atual. E o segundo conceito do modelo é a probabilidade de que, dado o rótulo da palavra atual, seja teu, a palavra será weu. Para ser mais claro: o modelo oculto de Markov é um tipo de Modelos gerativos (conjuntos) em que o oculto está (aqui etiquetas de PDV) são considerados dados e os dados observados são considerados gerados.
O teu No figura"Figura" é um termo usado em vários contextos, Da arte à anatomia. No campo artístico, refere-se à representação de formas humanas ou animais em esculturas e pinturas. Em anatomia, designa a forma e a estrutura do corpo. O que mais, em matemática, "figura" está relacionado a formas geométricas. Sua versatilidade o torna um conceito fundamental em várias disciplinas.... O seguinte refere-se às tags POS do estado YWeu refere-se às palavras emitidas pelos estados.
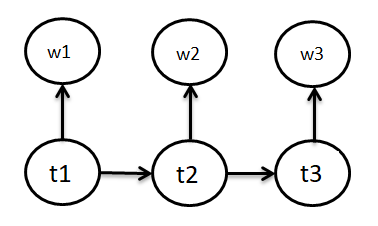
Agora, vamos dar uma olhada mais de perto no elemento do modelo para ver o processo de Markov nele ainda mais claramente. Os elementos do modelo oculto de Markov são:
- Um conjunto de estados: aqui POS Labels
- A saída de cada estado: aqui ‘palavra’
- Estado inicial: aqui eu começo a frase
- Probabilidade de transição de estado: aqui P (tNorte | tn-1)
Além de ser muito útil neste aspecto da PNL, transdutores de estado finito e muitos outros algoritmos são baseados em cadeias de Markov.
Caminhada aleatória
Outro fenômeno interessante é o passeio aleatório, que novamente é uma Cadeia de Markov.
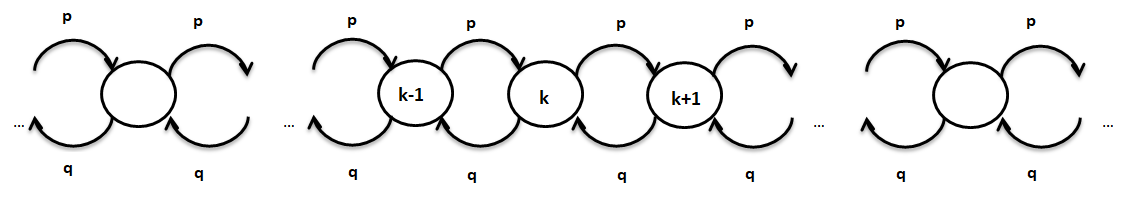
Vamos considerar o passeio aleatório, como mostrado acima, quer dizer, o movimento um passo à frente de qualquer estado pode ocorrer com probabilidade p e o movimento para trás um passo pode ocorrer com a probabilidade q. Aqui, o movimento para a frente do estado k para k + 1 depende apenas do estado k e, portanto, Random Walk é uma cadeia de Markov.
Agora, vamos avançar e entender o passeio aleatório como uma cadeia de Markov usando simulação. Aqui, consideramos o caso da caminhada unidimensional, onde a pessoa pode avançar ou recuar de qualquer tamanho (Tamanho> = 1) com igual probabilidade.
Aqui, Eu tracei 30 passeios aleatórios para desenvolver intuição em torno do fenômeno. Aqui, o estado inicial da cadeia de Markov é 0 (zero etapas cumulativas inicialmente). Coisas para manter em mente são:
- Espaço de estado e tempo definido são discretos (inteiros)
- É visualmente claro que em qualquer etapa de tempo, o próximo estado é determinado apenas pelo estado atual e as etapas de tempo atrás da etapa de tempo atual não ajudam a prever onde o estado da cadeia estará na próxima etapa de tempo.
- Uma vez que a probabilidade de movimento para frente é a mesma do movimento para trás, o valor esperado do número cumulativo de etapas é 0.
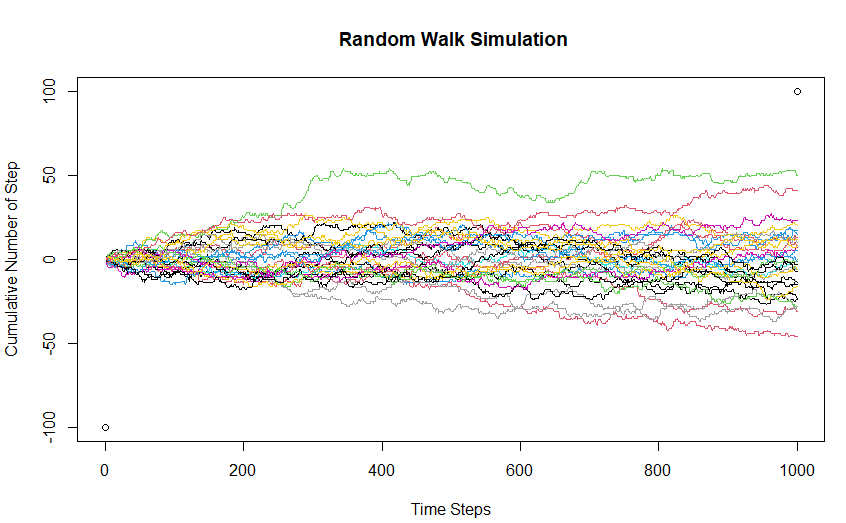
O código para simular um passeio aleatório básico em R é dado abaixo:
enredo(c(0,1000),c(-100,100), xlab = "Passos de tempo", ylab = "Número cumulativo de etapas" , main = " Simulação de caminhada aleatória")
para (eu em 1:30) {
  x <- as.integer(norma(1000))
  linhas(cumsum(x), tipo = "eu", col = amostra(1:10,1))
}
A cadeia de Markov é uma técnica muito poderosa e eficaz para modelar um processo estocástico de tempo e espaço discretos.. A compreensão das duas aplicações anteriores, juntamente com o conceito matemático explicado, pode ser usada para compreender qualquer tipo de processo de Markov..
Nota sobre o autor: Eu sou um estudante PGDBA (Diploma de Graduação em Análise de Negócios) e IIM Calcutá, IIT Kharagpur e ISI Kolkata, e eu concluí meu B.TECH da IIT DELHI e tenho uma experiência de trabalho de ~ 3,5 anos em análises avançadas.
Sinta-se à vontade para entrar em contato para qualquer discussão sobre o assunto em Parth Tyagi | LinkedIn ou escreva-me um e-mail para [e-mail protegido]
A mídia mostrada neste artigo não é propriedade da DataPeaker e é usada a critério do autor.





