
Esta postagem foi tornada pública como parte do Data Science Blogathon
Introdução
Python é uma linguagem de programação fácil de aprender, tornando-o a escolha preferida para iniciantes em ciência de dados, análise de dados e aprendizado de máquina. Ele também tem uma grande comunidade de alunos online e excelentes bibliotecas centradas em dados..
Com tantos dados gerados, é essencial que os dados que usamos para aplicativos de ciência de dados, como aprendizado de máquina e modelagem preditiva, sejam limpos. Mas, O que entendemos por dados limpos? E o que bagunça os dados em primeiro lugar?
Dados sujos significam apenas dados ruins. Duplicação de registros, Dados incompletos ou desatualizados e análises incorretas podem bagunçar os dados. Esses dados devem ser limpos. Limpeza de dados (ou limpeza de dados) refere-se ao procedimento de “limpar” esses dados sujos, identificar erros nos dados e, em seguida, retificá-los.
A limpeza de dados é uma etapa importante em um projeto de aprendizado de máquina, e vamos cobrir algumas técnicas básicas de limpeza de dados (e Python) neste post.
Limpeza de dados em Python
Aprenderemos mais sobre a limpeza de dados em Python com a ajuda de um conjunto de dados de amostra. Nós vamos usar o Conjunto de dados de habitação russo em Kaggle.
Começaremos importando as bibliotecas imperdíveis.
# import libraries
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt
%matplotlib inline
Baixe os dados e leia-os em um Pandas DataFrame usando o read_csv () e especificando o caminho do arquivo. Subseqüentemente, usar o atributo de forma para verificar o número de linhas e colunas no conjunto de dados. O código para isso é o seguinte:
df = pd.read_csv('housing_data.csv')
df.shape
O conjunto de dados tem 30 471 linhas e 292 colunas.
Agora vamos separar as colunas numéricas das colunas categóricas.
# select numerical columns
df_numeric = df.select_dtypes(incluir =[np.number])
numeric_cols = df_numeric.columns.values
# select non-numeric columns
df_non_numeric = df.select_dtypes(excluir=[np.number])
non_numeric_cols = df_non_numeric.columns.values
Agora terminamos com os passos preliminares.. Agora podemos passar para a limpeza de dados. Começaremos identificando colunas que contêm valores faltantes e tentaremos corrigi-los.
Valores ausentes
Começaremos calculando a porcentagem de valores faltantes em cada coluna e, em seguida, armazenando essas informações em um DataFrame..
# % of values missing in each column
values_list = list()
cols_list = lista()
para col em df.columns:
    pct_missing = np.média(df[col].é nulo())*100
    cols_list.append(col)
    values_list.append(pct_missing)
pct_missing_df = pd. DataFrame()
pct_missing_df['col'] = cols_list
pct_missing_df['pct_missing'] = lista_valores
O DataFrame pct_missing_df agora contém a porcentagem de valores ausentes em cada coluna junto com os nomes das colunas.
Também podemos criar uma imagem a partir dessas informações para um melhor entendimento usando o seguinte código:
pct_missing_df.loc[pct_missing_df.pct_missing > 0].enredo(kind='bar', figsize =(12,8))
plt.show()
O resultado após a execução da linha de código acima deve ser semelhante a este:
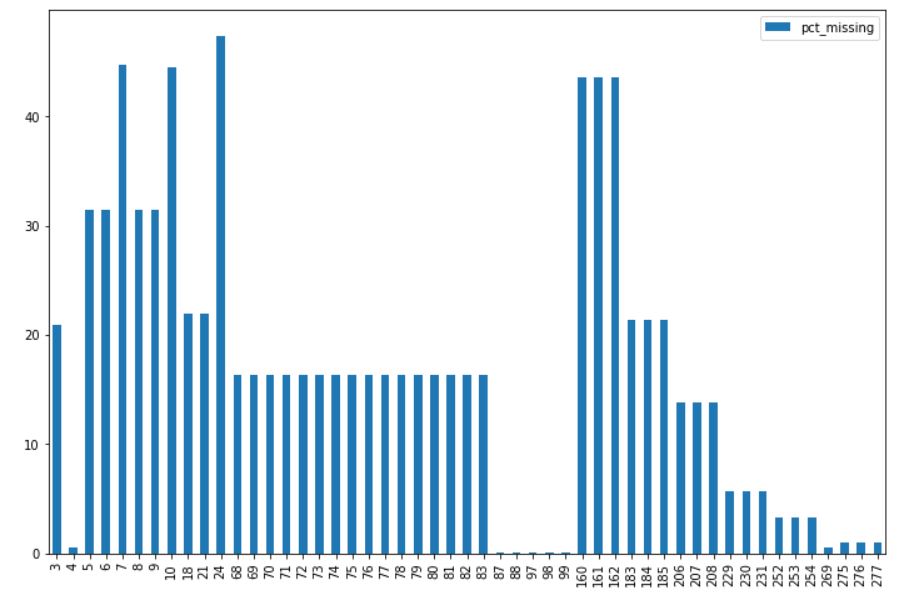
É claro que algumas colunas estão faltando poucos valores, enquanto outras colunas estão perdendo uma porcentagem substancial de valores. Agora vamos corrigir esses valores ausentes.
Existem várias maneiras de corrigir esses valores ausentes. Alguns deles são”
Observações de queda
Uma maneira pode ser descartar as observações que contêm algum valor nulo para qualquer uma das colunas. Isso funcionará quando a porcentagem de valores ausentes em cada coluna for muito menor. Eliminaremos as observações que contêm nulos nas colunas com menos de 0,5% nulo. Essas colunas seriam metro_min_walk, metro_km_walk, railroad_station_walk_km, railroad_station_walk_min e ID_railroad_station_walk.
less_missing_values_cols_list = list(pct_missing_df.loc[(pct_missing_df.pct_missing < 0.5) & (pct_missing_df.pct_missing > 0), 'col'].valores)
df.dropna(subconjunto = less_missing_values_cols_list, inplace = True)
Isso reduzirá o número de registros em nosso conjunto de dados para 30,446 registros.
Apagar colunas (funções)
Outra maneira de resolver os valores ausentes em um conjunto de dados seria excluir as colunas ou recursos que têm uma porcentagem significativa de valores ausentes.. essas colunas não contêm muitas informações e podem ser completamente excluídas do conjunto de dados. No nosso caso, vamos eliminar todas as colunas que faltam mais do que o 40% de valores. Essas colunas seriam build_year, Estado, hospital_beds_raion, cafe_sum_500_min_price_avg, cafe_sum_500_max_price_avg e cafe_avg_price_500.
# queda de colunas com mais de 40% null values
_40_pct_missing_cols_list = list(pct_missing_df.loc[pct_missing_df.pct_missing > 40, 'col'].valores)
df.drop(colunas=_40_pct_missing_cols_list, inplace = True)
O número de recursos em nosso conjunto de dados é agora 286.
Imputar valores perdidos
Os dados ainda estão faltando em nosso conjunto de dados. Agora vamos imputar os valores faltantes em cada coluna numérica com o valor médio dessa coluna.
df_numeric = df.select_dtypes(incluir =[np.number])
numeric_cols = df_numeric.columns.values
for col in numeric_cols:
    faltando = df[col].é nulo()
    num_missing = np.sum(desaparecido)
    se num_missing > 0:  # impute values only for columns that have missing values
        med = df[col].Mediar() #impute with the median
        df[col] = df[col].Fillna(Med)
Valores perdidos em colunas numéricas são agora corrigidos. No caso de colunas categóricas, vamos substituir os valores perdidos com os valores da moda dessa coluna.
df_non_numeric = df.select_dtypes(excluir=[np.number])
non_numeric_cols = df_non_numeric.columns.values
for col in non_numeric_cols:
    faltando = df[col].é nulo()
    num_missing = np.sum(desaparecido)
    se num_missing > 0:  # impute values only for columns that have missing values
        mod = df[col].descrever()['top'] # impute with the most frequently occuring value
        df[col] = df[col].Fillna(Mod)
Todos os valores faltantes em nosso conjunto de dados já foram abordados. Podemos verificar isso executando o seguinte código:
df.isnull().soma().soma()
Se a saída for zero, significa que agora não há valores ausentes deixados em nosso conjunto de dados.
Além disso, podemos substituir os valores ausentes por um valor específico (O que -9999 o ‘faltante’) que indicará o fato de que os dados estavam faltando neste lugar. Este pode ser um substituto para a imputação de valor perdido.
Valores atípicos
Um outlier é uma observação incomum que se desvia da maioria dos dados. Valores discrepantes podem afetar significativamente o desempenho de um modelo de aprendizado de máquina. Por isso, identificar outliers e resolvê-los é essencial.
Vamos pegar a coluna ‘life_sq’ como exemplo. Primeiro usaremos o método de descrição () para olhar as estatísticas descritivas e ver se podemos coletar informações a partir delas.
df.life_sq.describe()
A saída ficará assim:
contar    30446.000000
quer dizer        33.482658
std         46.538609
min          0.000000
25%         22.000000
50%         30.000000
75%         38.000000
max       7478.000000
Nome: life_sq, tipo d: float64
De partida, é claro que algo não está correto. O valor máximo parece ser anormalmente grande em comparação com os valores médios e medianos. Vamos fazer um gráfico de caixa desses dados para ter uma ideia melhor.
df.life_sq.plot(tipo='caixa', figsize =(12, 8))
plt.show()
A saída ficará assim:
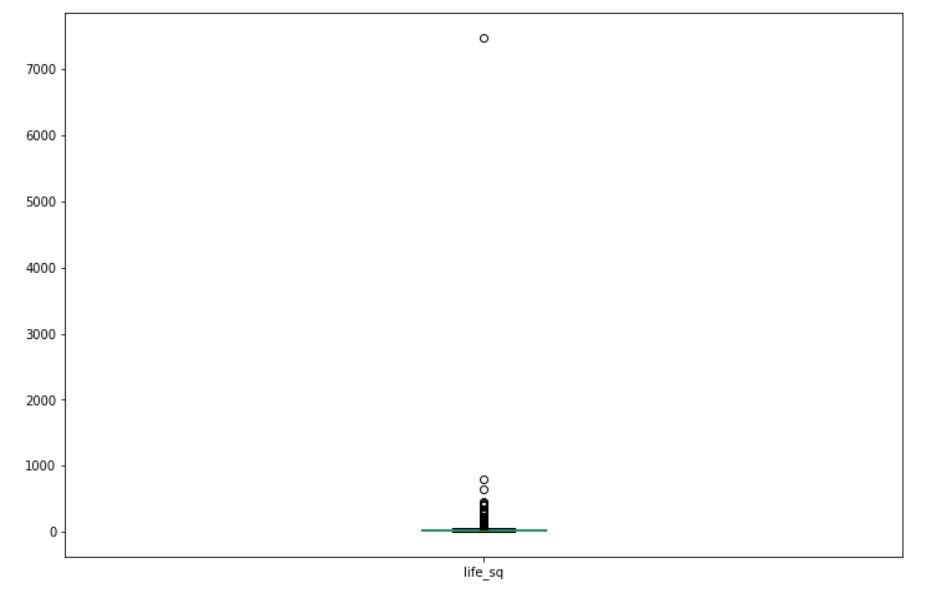
A partir do gráfico de caixa, é claro que a observação para o valor máximo (7478) é um outlier nestes dados. Estatísticas descritivas, a plotagens de caixaDiagramas de caixa, Também conhecido como diagramas de caixa e bigode, são ferramentas estatísticas que representam a distribuição de um conjunto de dados. Esses diagramas mostram a mediana, Quartis e outliers, permitindo que a variabilidade e a simetria dos dados sejam visualizadas. Eles são úteis na comparação entre diferentes grupos e na análise exploratória, facilitando a identificação de tendências e padrões nos dados.... y los diagramas de dispersión nos ayudan a identificar valores atípicos en los datos.
Podemos lidar com outliers como fizemos com valores ausentes. Podemos excluir as observações que consideramos discrepantes, ou podemos substituir outliers por valores adequados, ou podemos fazer algum tipo de transformação nos dados (como logaritmo ou exponencial). No nosso caso, vamos excluir o registro onde o valor de 'life_sq’ isto é 7478.
# removing the outlier value in life_sq column
df = df.loc[df.life_sq < 7478]
Registros duplicados
As vezes, dados podem conter valores duplicados. É essencial limpar registros duplicados do seu conjunto de dados antes de prosseguir com qualquer projeto de aprendizado de máquina. Em nossos dados, uma vez que a coluna ID é um identificador único, vamos remover registros duplicados considerando todos, exceto a coluna ID.
# dropping duplicates by considering all columns other than ID
cols_other_than_id = list(df.columns)[1:]
df.drop_duplicates(subconjunto=cols_other_than_id, inplace = True)
Isso nos ajudará a limpar registros duplicados. Ao usar o método de forma, você pode verificar que os registros duplicados foram realmente excluídos. O número de observações é agora 30,434.
Corrigindo o tipo de dados
Frequentemente, no conjunto de dados, os valores não são armazenados no tipo de dados correto. Isso pode criar um obstáculo em estágios posteriores e podemos não obter o resultado desejado ou obter erros durante a execução.. Um erro comum de tipo de dados são datas. As datas são frequentemente analisadas como objetos em Python. Há um tipo de dados separado para datas em Pandas, chamado DateTime.
Vamos primeiro verificar o tipo de dados da coluna de carimbo de data / hora em nossos dados.
df.timestamp.dtype
Isso retorna o tipo de dados 'objeto'. Agora sabemos que o estamp de tempo não é armazenado corretamente. Para consertar este problema, converter a coluna de datamp para o formato de data-hora.
# converting timestamp to datetime format
df['timestamp'] = pd.to_datetime(df.timestamp, format ="%Y-%m-%d")
Agora temos o estamp de tempo no formato certo. de forma similar, pode haver colunas onde inteiros são armazenados como objetos. É essencial identificar tais características e corrigir o tipo de dados antes de prosseguir com o aprendizado de máquina.. Sorte para nós, não temos esses problemas em nosso conjunto de dados.
EndNote
Neste post, Discutimos algumas maneiras básicas de limpar dados em Python antes de iniciar nosso projeto de aprendizado de máquina. Precisamos identificar e apagar os valores ausentes, identificar e resolver outliers, limpe os registros duplicados e corrija o tipo de dados de todas as colunas em nosso conjunto de dados antes de continuar com nossa tarefa de AA.
O autor desta postagem é Vishesh Arora. Você pode se conectar comigo em LinkedIn.
A mídia mostrada nesta postagem sobre o credenciamento de linguagem de sinais não é propriedade da DataPeaker e é usada a critério do autor.





