
Neste artigo, aprenderemos como podemos lidar com múltiplas variáveis de categoria usando a técnica de engenharia da função One Hot Encoding.
Mas antes de continuar, vamos ter uma breve discussão sobre engenharia de função e One Hot Encoding.
Engenharia de funções
Então, A engenharia de recursos é o processo de extrair recursos de dados brutos usando o conhecimento de domínio do problema. Essas funções podem ser usadas para melhorar o desempenho de algoritmos de aprendizado de máquina e, se o desempenho aumentar, fornecerá a melhor precisão. Também podemos dizer que a engenharia de funções é o mesmo que o aprendizado de máquina aplicado. A engenharia de recursos é a arte mais importante no aprendizado de máquina que cria uma grande diferença entre um modelo bom e um modelo ruim. Esta é a terceira etapa no ciclo de vida de qualquer projeto de ciência de dados.
O conceito de transparência para modelos de aprendizado de máquina é um tanto complicado, já que diferentes modelos geralmente requerem diferentes abordagens para diferentes tipos de dados. Tal como:-
- Dados contínuos
- Características categóricas
- Valores ausentes
- NormalizaçãoA padronização é um processo fundamental em várias disciplinas, que busca estabelecer padrões e critérios uniformes para melhorar a qualidade e a eficiência. Em contextos como engenharia, Educação e administração, A padronização facilita a comparação, Interoperabilidade e compreensão mútua. Ao implementar normas, a coesão é promovida e os recursos são otimizados, que contribui para o desenvolvimento sustentável e a melhoria contínua dos processos....
- Datas e horas
Mas aqui vamos discutir apenas as características categóricas, características categóricas são aquelas características em que o tipo de dados é um tipo de objeto. O valor do ponto de dados em qualquer característica categórica não está na forma numérica, mas na forma de um objeto.
Existem muitas técnicas para lidar com variáveis categóricas, alguns são:
- Codificação de tag ou codificação ordinal
- Uma codificação quente
- Codificação fictícia
- Codificação de efeitos
- Codificação binária
- Codificação Basel
- Codificação de hash
- Codificação de destino
Então, aqui lidamos com características categóricas por One Hot Encoding, portanto, em primeiro lugar, discutiremos One Hot Encoding.
Uma codificação quente
Sabemos que as variáveis categóricas contêm os valores do rótulo em vez de valores numéricos. O número de valores possíveis é frequentemente limitado a um conjunto fixo. Variáveis categóricas são frequentemente chamadas de nominais. Muitos algoritmos de aprendizado de máquina não podem operar diretamente nos dados da tag. Exigir que todas as variáveis de entrada e saída sejam numéricas.
Isso significa que os dados categóricos devem ser convertidos para um formato numérico. Se o variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos.... categorical é uma variável de saída, você também pode querer converter as previsões do modelo de volta para a forma categórica para apresentar ou usar em algum aplicativo.
por exemplo dados sobre gênero estão na forma de ‘masculino’ e 'mulher'.
Mas se usarmos codificação one-hot, codificar e permitir que o modelo assuma uma ordem natural entre as categorias pode resultar em baixo desempenho ou resultados inesperados.
A codificação one-hot pode ser aplicada à representação de inteiros. É aqui que a variável codificada por inteiro é removida e uma nova variável binária é adicionada para cada valor inteiro único.
Por exemplo, nós codificamos a variável de cor,
| cor vermelha | Cor azul |
| 0 | 1 |
| 1 | 0 |
| 0 | 1 |
Agora vamos começar nossa jornada. Na primeira etapa, pegamos um conjunto de dados de previsão de preços de casas.
Conjunto de dados
Aqui, usaremos o conjunto de dados de house_price que é usado para prever o preço da casa de acordo com o tamanho da área.
Se você quiser fazer o download do conjunto de dados de previsão de preços de casas, Clique em aqui.
Importação de módulo
Agora, temos que importar módulos python importantes para serem usados para codificação one-hot
# importando pandas
importar pandas como pd
# importando numpy
importar numpy como np
# importando OneHotEncoder
de sklearn.preprocessing import OneHotEncoder()
Aqui, usamos pandas que são usados para análise de dados, NumPyused para matrizes n-dimensionais, e do sklearn, usaremos um codificador ativo de classe Um importante para codificação categórica.
Agora temos que ler esses dados usando Python.
Leia o conjunto de dados
Geralmente, o conjunto de dados está no formato CSV, e o conjunto de dados que usamos também está no formato CSV. Para ler o arquivo CSV, usaremos a função read_csv do pandas (). Veja abaixo:
# lendo conjunto de dados
df = pd.read_csv('house_price.csv')
df.head()
Produção:-
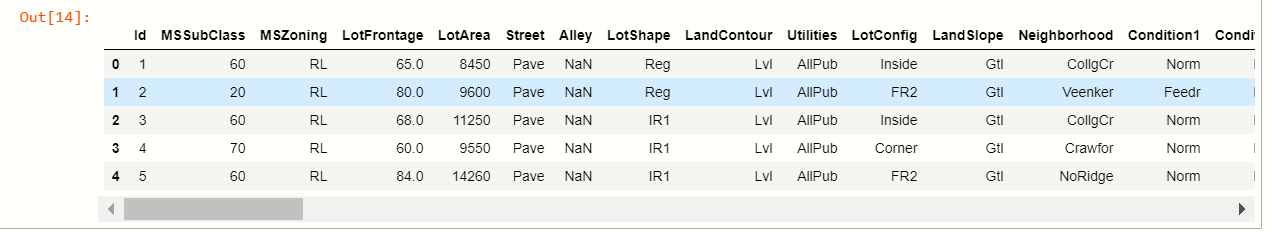
Mas só temos que usar variáveis categóricas para um codificador ativo e vamos apenas tentar explicar com variáveis categóricas para fácil compreensão.
para particionar variáveis categóricas de dados, temos que verificar quantas características têm valores categóricos.
Verificando valores categóricos
Para verificar os valores usamos a função pandas select_dtypes que é usada para selecionar os tipos de dados da variável.
# verificando recursos
cat = df.select_dtypes(incluir ="O").chaves()
# exibir variáveis
gato
Produção:-
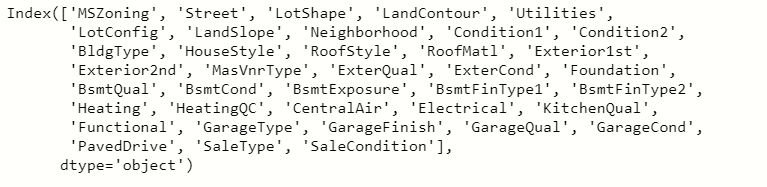
Agora temos que remover essas colunas numéricas do conjunto de dados e usaremos esta variável categórica para nosso uso. Nós só usamos 3-4 colunas categóricas do conjunto de dados para aplicar codificação one-hot.
Crie um novo quadro de dados
Agora, usar variáveis categóricas, vamos criar um novo quadro de dados a partir de colunas categóricas selecionadas.
# criando novo df
# definindo colunas que usamos
new_df = pd.read_csv('house_price.csv',usecols =['Neighborhood','Exterior1st','Exterior2nd'])
new_df.head()
Produção:-
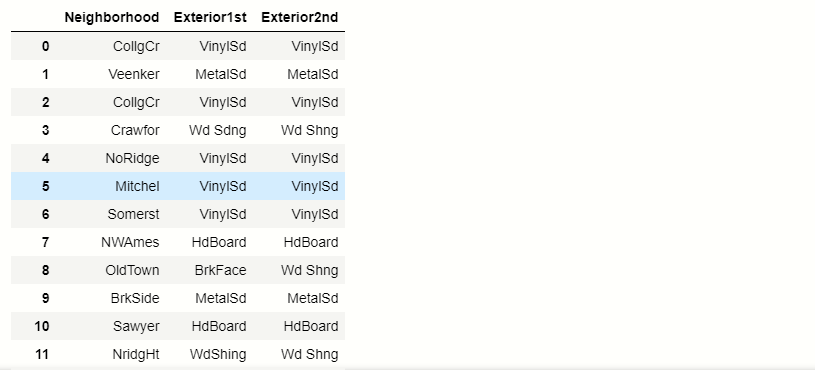
Agora temos que descobrir quantas categorias exclusivas estão presentes em cada coluna categórica.
Encontre valores únicos
Para encontrar valores únicos, usaremos a função única do pandas ().
# valores únicos em cada coluna
para x em new_df.columns:
    #imprimindo valores únicos
    imprimir(x ,':', len(new_df[x].exclusivo()))
Produção:-
| Vizinhança: 25 |
| Exterior 1ª: 15 |
| Exterior 2ª: 16 |
Agora, usaremos nossa técnica para aplicar a codificação one-hot em variáveis multicategorias.
Técnica para variáveis multicategorias
A técnica é limitar a codificação one-hot para 10 rótulos mais frequentes da variável. Isso significa que faríamos uma variável binária apenas para cada um dos 10 tags mais frequentes, isso é equivalente a agrupar todas as outras tags em uma nova categoria, que neste caso será eliminado. A) Sim, as 10 novas variáveis fictícias indicam se uma das 10 as tags mais frequentes estão presentes é 1 ou não então 0 para uma observação particular.
Variáveis mais frequentes
Aqui iremos selecionar o 20 variáveis mais frequentes.
Suponha que tomemos uma variável categórica Vizinhança.
# encontrando o topo 20 categorias
new_df.Neighborhood.value_counts().sort_values(ascendente = falso).cabeça(20)
Produção:
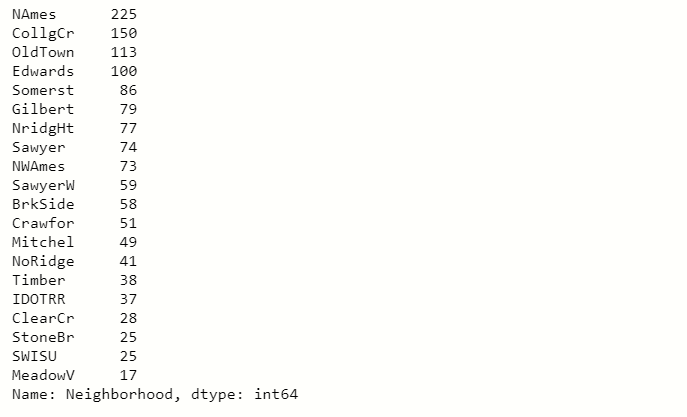
Quando você vê nesta imagem de saída, você vai notar que o Nomes O rótulo se repete 225 vezes nas colunas da vizinhança e vamos diminuindo esse número está diminuindo.
Então pegamos o 10 resultados principais do início e nós convertemos este resultado principal 10 em codificação one-hot e os rótulos à esquerda tornam-se zero.
Produção:-
Lista das variáveis categóricas mais frequentes
# fazer lista com o melhor 10 variáveis
top_10 = [x para x em new_df.Neighborhood.value_counts().sort_values(ascendente = falso).cabeça(10).índice]
top_10
Produção:-
[‘NAmes’,
‘CollgCr’,
'Cidade antiga',
‘Edwards’,
‘Somerst’,
‘Gilbert’,
‘NridgHt’,
'Serrador',
‘NWAmes’,
‘SawyerW’]
Existem os 10 Principais rótulos categóricos na coluna Vizinhança.
Faça binário
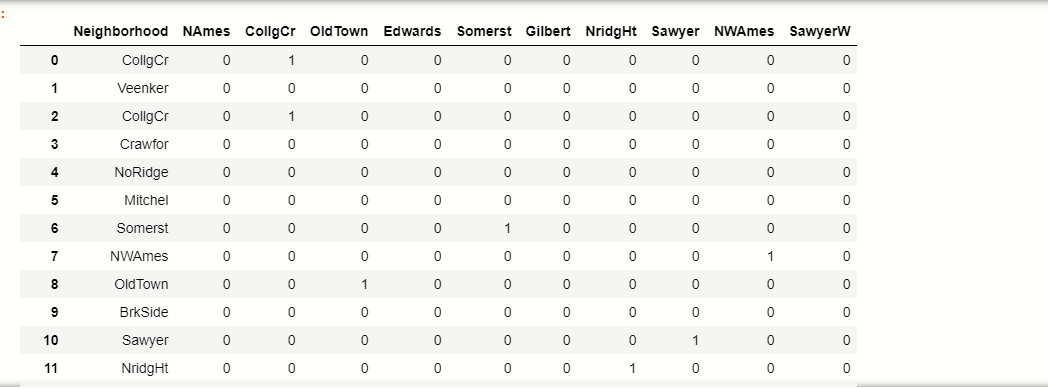
Agora, temos que fazer o 10 variáveis binárias dos rótulos top_10:
# fazer rótulos binários
para tag em top_10:
new_df[rótulo] = np.where (new_df['Vizinhança']== etiqueta, 1,0)
new_df[['Vizinhança']+ top_10]
Produção:-
| Nomes | CollgCr | Cidade antiga | Edwards | Somerst | Gilbert | NridgHt | Serrador | NWAmes | SawyerW | ||
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | CollgCr | 0 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 1 | Veenker | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 2 | CollgCr | 0 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 3 | Crawfor | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 4 | NoRidge | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 5 | Mitchel | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 6 | Somerst | 0 | 0 | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 0 |
| 7 | NWAmes | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 |
| 8 | Cidade antiga | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 9 | BrkSide | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 10 | Serrador | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 0 |
| 11 | NridgHt | 0 | 0 | 0 | 0 | 0 | 0 | 1 | 0 | 0 | 0 |
Você pode ver como as tags top_10 agora são convertidas para o formato binário.
Vamos dar um exemplo, veja na tabela onde 1 índiceo "Índice" É uma ferramenta fundamental em livros e documentos, que permite localizar rapidamente as informações desejadas. Geralmente, é apresentado no início de um trabalho e organiza os conteúdos de forma hierárquica, incluindo capítulos e seções. Sua correta preparação facilita a navegação e melhora a compreensão do material, tornando-se um recurso essencial para estudantes e profissionais de várias áreas.... Veenker que não pertenciam a nossa tag top_10 categorias, então vai resultar em 0 todas as colunas.
Agora faremos isso para todas as variáveis categóricas que selecionamos anteriormente.
Todas as variáveis selecionadas em OneHotEncoding
# para todas as variáveis categóricas que selecionamos def top_x(df2, variável,top_x_labels): para rótulo em top_x_labels: df2[variable+'_'+label] = np.where(dados[variável]== etiqueta,1,0) # leia os dados novamente data = pd.read_csv('D://xdatasets/train.csv',usecols = ['Neighborhood','Exterior1st','Exterior2nd']) #codifique a vizinhança no 10 categorias mais frequentes top_x(dados,'Neighborhood',top_10) # mostrar dados data.head()
Produção:-
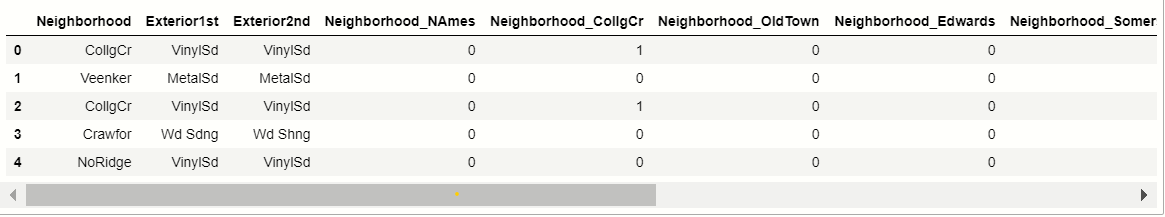
Agora, aqui aplicamos codificação one-hot em todas as variáveis multicategorias.
Agora veremos as vantagens e desvantagens de One Hot Encoding para várias variáveis.
Vantagem
- Fácil de implementar
- Não requer muito tempo para exploração variável.
- Não expande enormemente o espaço de recursos.
Desvantagens
- Não adiciona nenhuma informação que possa tornar a variável mais preditiva
- Não salve informações sobre variáveis ignoradas.
Notas finais
Então, o resumo disso é que aprendemos como lidar com variáveis de várias categorias. Se você se deparar com este problema, então esta é uma tarefa muito difícil. Então, obrigado por ler este artigo..
Conecte-se comigo no Linkedin: Perfil
Leia meus outros artigos: https://www.analyticsvidhya.com/blog/author/mayurbadole2407/
Obrigado
A mídia mostrada neste artigo não é propriedade da DataPeaker e é usada a critério do autor.





