
Este artigo foi publicado como parte do Data Science Blogathon.
O que é aprendizado de máquina?
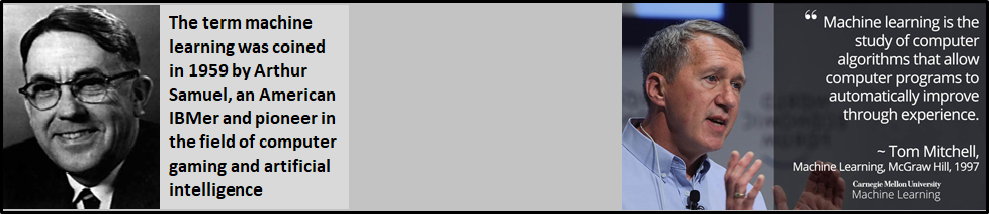
Aprendizado de máquina: Aprendizado de máquina (ML) es un proceso altamente iterativo y ML Los modelos se aprenden de experiencias pasadas y también para analizar los datos históricos. O que mais, los modelos ML pueden identificar los patrones para fazer predicciones sobre el futuro del conjunto de datos dado.
C¿Por qué es importante el aprendizaje automático?
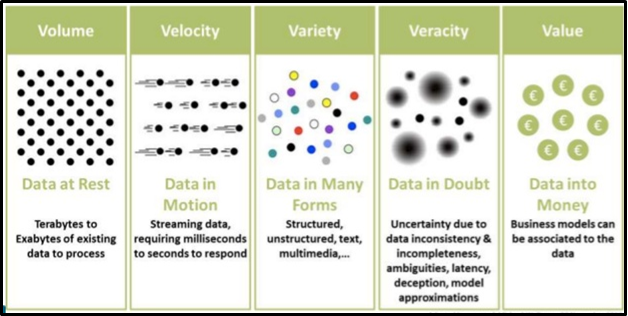
Dado que las 5V están dominando el mundo digital actual (volume, variedad, visibilidad de variación y valor), la mayoría de las industrias están a desenvolver vários modelos para analisar sua presença y oportunidades no mercado, basándose en este resultado, están entregando los mejores productos. servicios a sus clientes a gran escala.
¿Cuáles son las principales aplicaciones de aprendizaje automático?
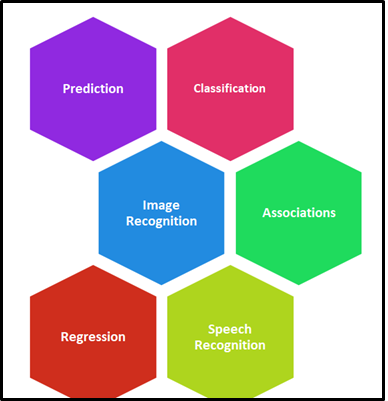
Aprendizado de máquina (ML) es amplamente aplicável en muchas industrias y la implementación y mejora de sus procesos. Atualmente, ML se ha utilizado en múltiplos campos e indústrias sin limits. O seguinte figura"Figura" é um termo usado em vários contextos, Da arte à anatomia. No campo artístico, refere-se à representação de formas humanas ou animais em esculturas e pinturas. Em anatomia, designa a forma e a estrutura do corpo. O que mais, em matemática, "figura" está relacionado a formas geométricas. Sua versatilidade o torna um conceito fundamental em várias disciplinas.... representa a área onde ML juega um papel vital.
¿Dónde está el aprendizaje automático en el espacio de la IA?
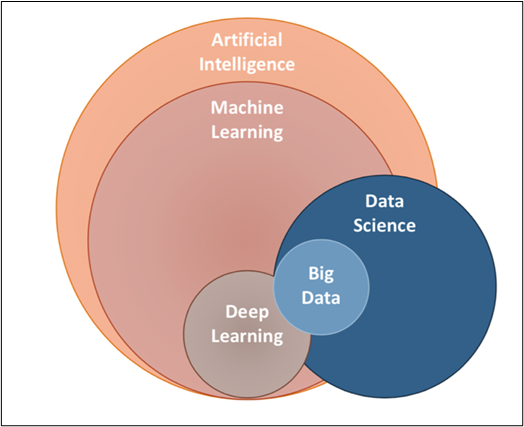
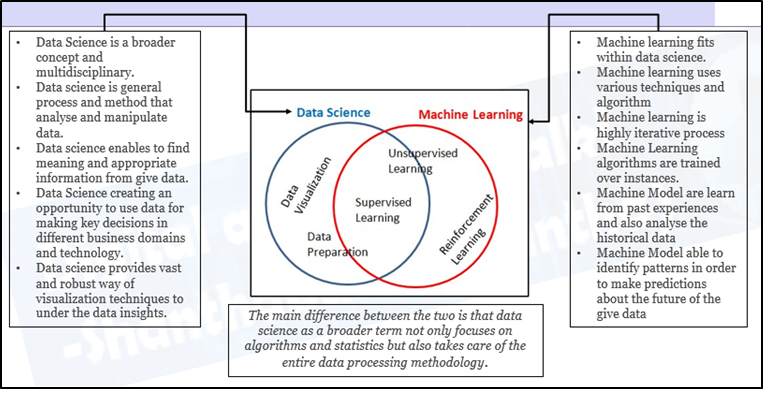
Solo eche un vistazo al Diagrama de Venn, podremos entender dónde está el ML no espaço da IA e como se relaciona com outros componentes de la IA IA.
Como sabemos os Jargões que vuelan a nosso alrededor, veamos rapidamente de qué habla exatamente cada componente.
Como se relacionam a ciência de dados e o aprendizado automático?
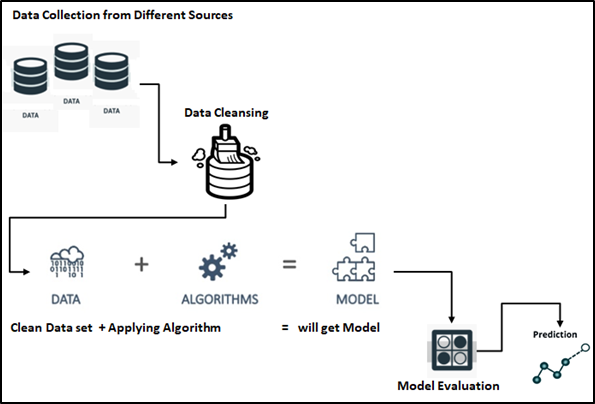
Processo de aprendizagem automático, es el primer paso en el proceso de ML para tomar los datos de múltiples fuentes y seguido de un proceso de datos afinado, estos datos serían la fuente para los algoritmos de ML basados en la declaración del problema, como los modelos predictivos, de classificação y outros que están disponíveis no espaço del mundo ML. Discutamos cada proceso uno por uno aqui.
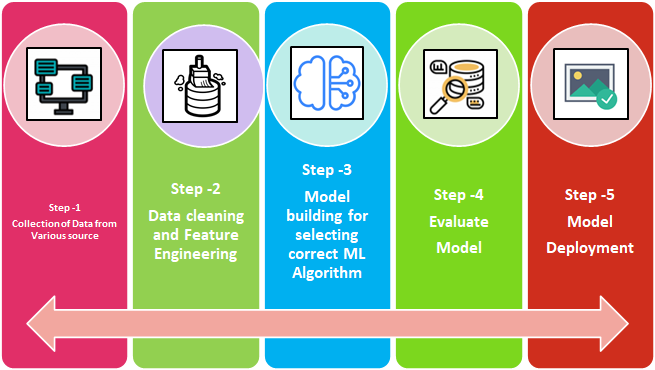
Aprendizado de máquina – Etapas: Podemos dividir las etapas del proceso de AA en 5 como se menciona a continuación en el diagrama de flujo.
- Conjunto de dados
- Negociación de datos
- Construção do modelo
- Avaliação de modelo
- Implantação de modelo
Identificación de los problemas comerciais, antes de passar a las etapas anteriores. Então, devemos ter claro o objetivo del propósito de la implementación del ML. Encontrar la solução al problema dado / identificado. debemos compilar los datos y realizar un seguimento adequado de las etapas siguientes.
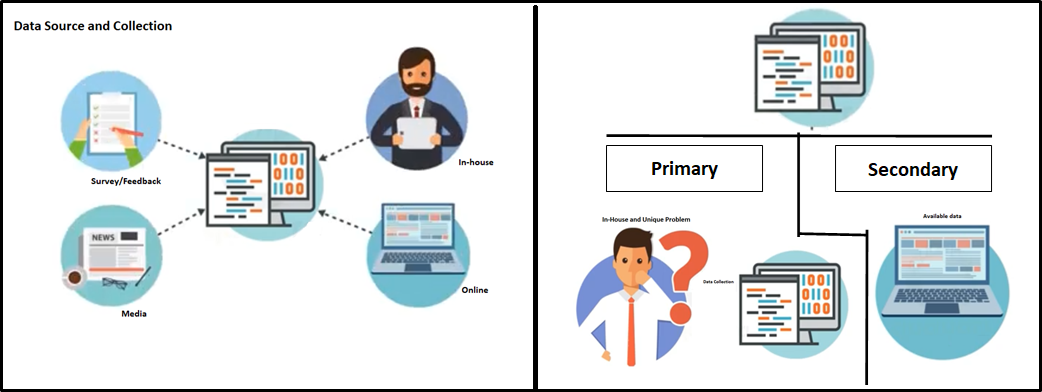
Conjunto de dados
La recopilación de datos de diferentes fontes puede ser interna y / o externa para satisfacer los requisitos / problemas comerciais. Los datos pueden estar en cualquier formato. CSV, XML.JSON, etc., aquí Big Data juega un papel vital para assegurarse de que los datos correctos estejam no formato y estrutura esperados.
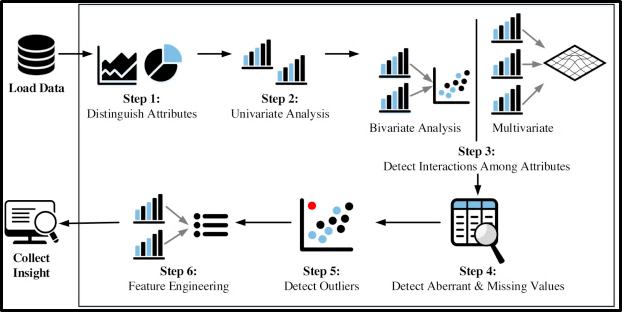
Negociación de datos y procesamiento de datos: El objetivo principal de esta etapa y enfoque son los siguientes.
Processamento de dados (EDA):
- Compreender el conjunto de datos dado y ayudar a limpar el conjunto de datos dado.
- Le brinda una mejor compreensão de las características y las relaciones entre ellas
- Extraer variables esenciales y dejar atrás / eliminar variables no esenciales.
- Gestão de valores perdidos ou erro humano.
- Identificação de valores atípicos.
- O processo de EDA maximizaria o conhecimento de um conjunto de dados.
Engenharia de funções:
- Gestão de valores perdidos nas variáveis
- Converter categórico em numérico, pois a maioria dos algoritmos necessita de características numéricas.
- Necessita corrigir não gaussiano (normal). Os modelos lineares assumem que as variáveis têm distribuição gaussiana.
- Encontrar valores atípicos presentes nos dados, portanto, truncamos os dados acima de um limite ou transformamos os dados mediante a transformação de logs.
- Escalonar as características. Isto é necessário para dar a mesma importância a todas as características e não mais àquela cujo valor é maior.
- La ingeniería de características es un proceso costoso y que requiere mucho tiempo.
- La ingeniería de características puede ser un proceso manual, se puede automatizar
a tela de configurações do calendárioO treinamento é um processo sistemático projetado para melhorar as habilidades, Conhecimento ou habilidades físicas. É aplicado em várias áreas, como esporte, Educação e desenvolvimento profissional. Um programa de treinamento eficaz inclui planejamento de metas, prática regular e avaliação do progresso. A adaptação às necessidades individuais e a motivação são fatores-chave para alcançar resultados bem-sucedidos e sustentáveis em qualquer disciplina.... y pruebas:
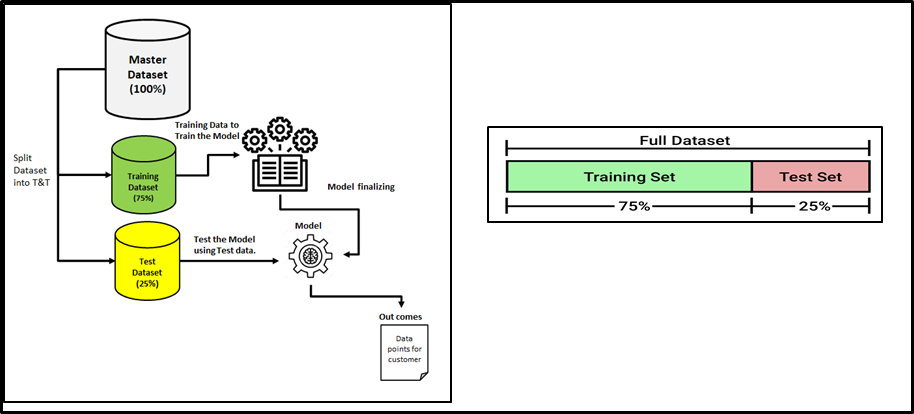
- Los datos de entrenamiento se utilizan para asegurarse de que la máquina reconozca los patrones de los datos, se utiliza la validación cruzada de los datos para garantir una mejor precisión y
la eficiência del algoritmo que se utiliza para entrenar la máquina. - Los datos de prueba se utilizan para ver qué tan bien la máquina puede predecir nuevas respuestas en función de su entrenamiento.
- El procedimiento de división de prueba de tren se utiliza para estimar el rendimiento de ML de los algoritmos cuando se utilizan para hacer predicciones sobre datos que no son
utilizado para entrenar el modelo.
Treinamento
- Los datos de entrenamiento son el conjunto de datos en el que entrena el modelo.
- Entrene datos de los que el modelo ha aprendido las experiencias.
- Los conjuntos de entrenamiento se utilizan para ajustar y ajustar sus modelos.
Pruebas
- Los datos de prueba son los datos que se utilizan para verificar si el modelo tiene
aprendió lo suficientemente bien de las experiencias que obtuvo en el conjunto de datos de trenes. - Conjuntos de prueba
son datos “invisibles” para evaluar sus modelos.
Datos del tren: Entrena nuestro algoritmo de aprendizaje automático
e depois verifique se o segundo parâmetro tem um valor: Depois de treinar o modelo, los datos de prueba se utilizan para probar su eficiencia y rendimiento del modelo.
El propósito del estado aleatorio en la división de prueba de tren: estado aleatorio asegura que el divisões que generas son reproducibles. a estado aleatorio que proporcionas se utiliza como semilla para el aleatória generador de números. Esto asegura que el aleatória los números se generan en el mismo orden.
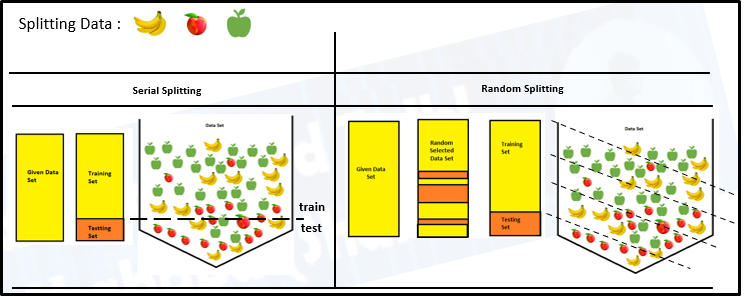
Datos divididos en conjunto de entrenamiento / prova
- Solíamos dividir un conjunto de datos en datos de entrenamiento y datos de prueba en el espacio de aprendizaje automático.
- El rango dividido suele ser del 20% al 80% entre las etapas de prueba y entrenamiento del conjunto de datos dado.
- Se gastaría una gran cantidad de datos para entrenar su modelo
- El resto de la cantidad se puede gastar para evaluar su modelo de prueba.
- Pero no puede mezclar / reutilizar los mismos datos para fins de entrenamiento y prueba
- Si evalúa su modelo con los mismos datos que utilizó para entrenarlo, su modelo podría estar muy sobreajustado. Luego se plantea la cuestión de si los modelos podem predecir nuevos datos.
- Portanto, debe tener subconjuntos de prueba y entrenamiento separados de su conjunto de datos.
AVALIAÇÃO DEL MODELO: Cada modelo tiene su propia mitología de evaluación de modelos, algunas de las mejores evaluaciones están aquí.
- Evaluar la regresión Modelo.
- Suma del error al cuadrado (SSE)
- Raiz do erro quadrático médio (MSE)
- Raiz do erro quadrático médio (RMSE)
- Erro médio absoluto (MUITO DE)
- Coeficiente de determinación (R2)
- R2 ajustado
- Evaluar Classificação Modelo.
- Matriz de confusão.
- Puntuación de precisión.
- AUC y ROC.
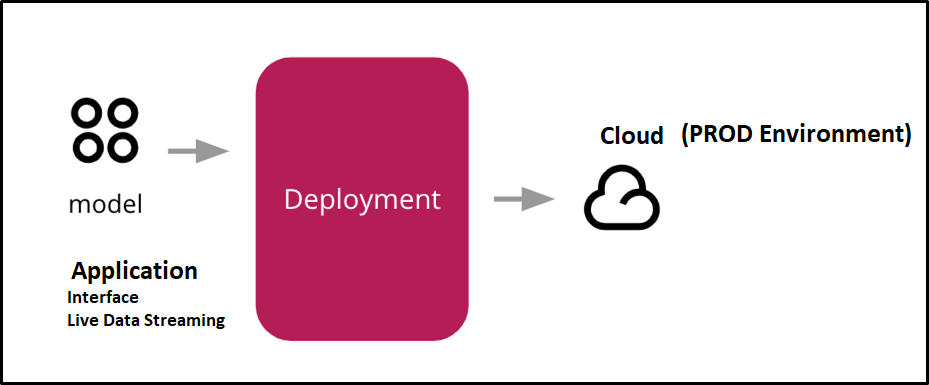
Desdobramento, desenvolvimento de um ML-modelo simplesmente significa la integración del modelo finalizado en un entorno de producción y la obtención de resultados para tomar decisões comerciais.
Portanto, espero que possa compreender o fluxo do processo de ponta a ponta do aprendizado automático e acredito que seria útil para si. Obrigado pelo seu tempo.





