
Foto de Daddy Mohlala no Unsplash
Dados são água, purificá-los para torná-los comestíveis é uma função do analista de dados: Rastogi Kashish
Tabela de conteúdo:
- Exposição do problema
- Descrição dos dados
- Limpeza de texto com PNL
- Descubra se o texto tem: com espaço
- Limpeza de texto com biblioteca de pré-processador
- Análise de sentimento dos dados
- Visualização de dados
Estou pegando os dados do twitter que estão disponíveis aqui na plataforma DataPeaker.
Importação de bibliotecas
importar pandas como pd
importar re
import plotly.express as px
importar nltk
import Spacy
Estou carregando um modelo pequeno e espaçoso. Existem 3 tamanhos de modelo que você pode baixar spacy (pequeno, médio e grande) de acordo com seus requisitos.
nlp = spacy.load('en_core_web_sm')
Os dados são assim
df = pd.read_csv(r'localização do ficheiro')
do DF['id']
df.head(5)
Exposição do problema
O ponto principal é encontrar o sentimento dos dados de texto. O texto fornecido é de clientes de várias empresas de tecnologia que fazem telefones, laptops, aparelhos, etc. A tarefa é identificar se os tweets têm um sentimento negativo, positivo ou neutro em relação à empresa.
Descrição dos dados
Rótulo: A coluna de rótulo tem 2 valores únicos 0 e 1.
Pío: As colunas do tweet têm o texto fornecido pelos clientes
Manipulação de dados
Encontre a forma dos dados
Existem 2 colunas e 7920 filas.
df.shape
Classificação de tweets
fig = px.pie(df, names = df.label, buraco = 0,7, título ="Classificação de Tweets",
             altura = 250, color_discrete_sequence = px.colors.qualitative.T10)
fig.update_layout(margem = dict(t = 100, b = 40, l = 60, r = 40),
                  plot_bgcolor ="#2d3035", paper_bgcolor ="#2d3035",
                  title_font = dict(tamanho = 25, color ="#a5a7ab", familia ="Lado, sem serifa"),
                  font = dict(color ="#8a8d93"),
                  )
Reserve um momento e observe os dados. O que você vê?
Fonte da imagem: https://unsplash.com/photos/LDcC7aCWVlo
- Não há marcação para analisar, é texto simples (¡Yaa!).
- Existem muitas coisas para filtrar, como:
-
- O identificador do Twitter está mascarado (@Nome do usuário), o que não tem utilidade para nós.
- Etiquetas
- Links (editar)
- Caracteres especiais
- Vemos que o texto tem valor numérico neles.
- Existem muitos erros de digitação e contrações no texto.
- Existem muitos nomes de empresas (Sony, maçã).
- O texto não está em minúsculas
Vamos limpar o texto
Descubra se o texto tem:
- Nomes de usuário do Twitter
- Etiquetas
- Valores numéricos
- Links (editar)
Excluindo se o texto tiver:
- Nome de usuário do Twitter porque você não fornecerá nenhuma informação adicional neste momento, já que por razões de segurança, nome de usuário foi alterado para nomes fictícios
- Palavras de hashtag não fornecem nenhum significado útil para o texto na análise de sentimento.
- O link do URL também não adicionará informações ao texto.
- Removendo
- Pontuação para texto limpo
- Palavras mais curtas que 3 são seguros para remover do texto porque as palavras serão como (soja, soja, isto é) que não têm nenhum significado ou função específica no texto
- Palavras irrelevantes são sempre a melhor opção para remover
Removendo Nome de usuário do texto
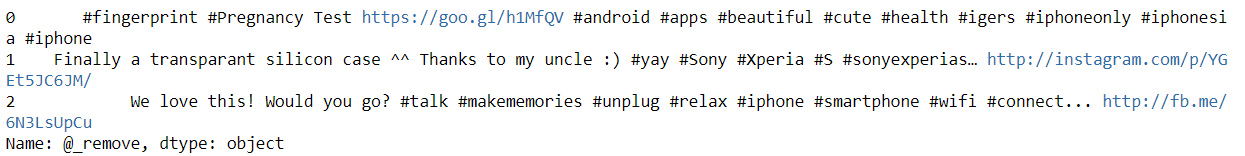
Faça uma função para remover o nome de usuário do texto com o simples encontrar tudo() função de pandas. Onde vamos selecionar as palavras que começam com ‘@’.
def remove_pattern(input_txt):
    r = re.findall(r"@(w +)", input_txt)
    para eu em r:
        input_txt = re.sub(eu, '', input_txt)
    return input_txt
df['@_remove'] = np.vectorize(remove_pattern)(df['tweet'])
df['@_remove'][:3]
Encontrando Etiquetas no texto
Fazendo uma função para extrair hashtags de texto com o simples encontrar tudo() função de pandas. Onde vamos selecionar as palavras que começam com ‘#’ e armazená-los em um quadro de dados.
hashtags = []
def hashtag_extract(x):
    # Faça um loop sobre as palavras do tweet
    para i em x:
        ht = re.findall(r"#(w +)", eu)
        hashtags.append(ht)
    devolver hashtags

Passando função e extraindo hashtags agora podemos visualizar quantas hashtags existem em tweets positivos e negativos
# extração de hashtags de tweets neg / pos
dff_0 = hashtag_extract(df['tweet'][df['label'] == 0])
dff_1 = hashtag_extract(df['tweet'][df['label'] == 1])
dff_all = hashtag_extract(df['tweet'][df['label']])
# lista desaninhada
dff_0 = soma(dff_0,[])
dff_1 = soma(dff_1,[])
dff_all = sum(dff_all,[])
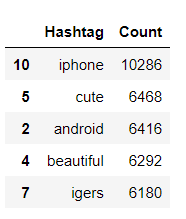
Contando as hashtags frequentes usadas quando label = 0. FreqDist significa que nos dirá quantas vezes aquela palavra apareceu em todo o documento.
data_0 = nltk.FreqDist(dff_0)
data_0 = pd.DataFrame({'Hashtag': Lista(data_0.keys()),
                  'Count': Lista(data_0.values())}).sort_values(by='Count', ascendente = falso)
data_0[:5]
Se você quiser saber mais sobre o Plotly e como usá-lo, visitas é Blog. Cada gráfico é bem explicado com diferentes parâmetros que você precisa ter em mente ao traçar gráficos.
fig = px.bar(data_0[:30], x='Hashtag', y='Count', altura = 250,
             título ="Principal 30 hashtags",
             color_discrete_sequence = px.colors.qualitative.T10)
fig.update_yaxes(showgrid = False),
fig.update_xaxes(ordem de categorias ="total descendente")
fig.update_traces(hovertemplate = Nenhum)
fig.update_layout(margem = dict(t = 100, b = 0, l = 60, r = 40),
                  hovermode ="x unificado",
                  xaxis_tickangle = 300,
                  xaxis_title =" ", yaxis_title =" ",
                  plot_bgcolor ="#2d3035", paper_bgcolor ="#2d3035",
                  title_font = dict(tamanho = 25, color ="#a5a7ab", familia ="Lado, sem serifa"),
                  font = dict(color ="#8a8d93")
                  )
Texto de passagem
sentenças = nlp(str(texto))
Encontrando Nortevalores numéricos no texto
spacy fornece funções como_num que indica se o texto tem valores numéricos ou não
para token em frases:
    if token.like_num:
        text_num = token.text
imprimir(text_num)
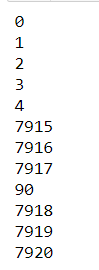
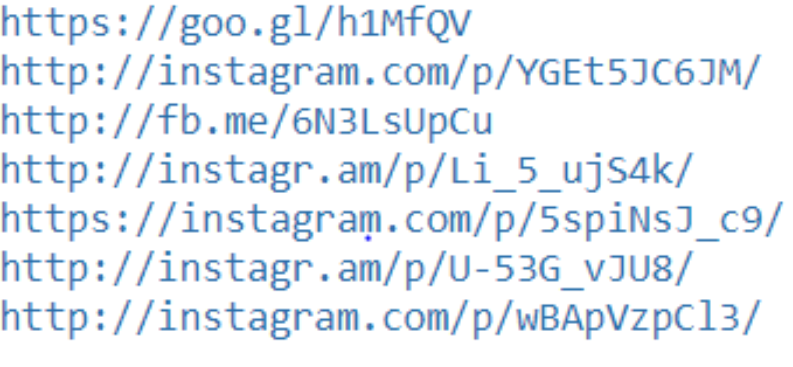
Encontrando Link de URL no texto
spacy fornece a função like_url que indica se o texto tem um link de url ou não
# encontrar links
para token em frases:
    if token.like_url:
        text_links = token.text
        imprimir(text_links)
Existe uma biblioteca em Python que ajuda a limpar o texto, você pode encontrar a documentação. aqui
Atualmente, esta biblioteca suporta limpeza, tokenização e análise
- URLs
- Etiquetas
- Menções
- Palavras reservadas (RT, FAV)
- Emojis
- Emoticons
Importando biblioteca
!pip instalar pré-processador de tweet
importar pré-processador como p
Chame uma função para limpar o texto
def preprocess_tweet(fileira):
    texto = linha['tweet']
    text = p.clean(texto)
    texto de retorno
df['clean_tweet'] = df.apply(preprocess_tweet, eixo = 1)
df[:6]
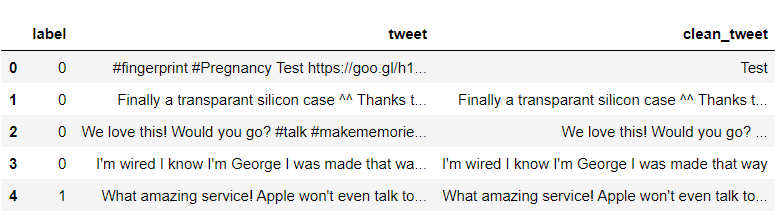
Como vemos, colunas clean_tweet só têm texto, todos os nomes de usuário são removidos, hashtag e links de url
Algumas das etapas para limpeza ainda são como
- baixando todo o texto
- Removendo pontuações
- Remova os números
Código:
def preprocessing_text(texto):
     # Faça minúsculas
     text = text.str.lower()
     # Remover pontuação
     text = text.str.replace('[^ ws]', '', regex = True)
     # Remover dígitos
     text = text.str.replace('[d]+', '', regex = True)
     texto de retorno
 pd.set_option('max_colwidth', 500)
 df['clean_tweet'] = preprocessing_text(df['clean_tweet'])
 df['clean_tweet'][:5]
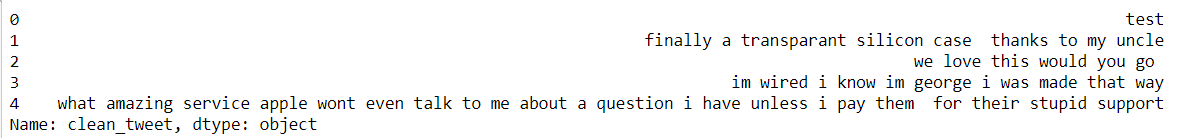
Temos nosso texto limpo, vamos remover as palavras vazias.
O que são palavras vazias? Você precisa remover as palavras irrelevantes?
Palavras irrelevantes são as palavras mais comuns em qualquer linguagem natural. Palavras vazias são como eu, soja, sua, quando, etc., não adicione nenhuma informação adicional ao texto.
Não há necessidade de remover palavras irrelevantes sempre que depender do estudo de caso, aqui estamos encontrando o sentimento do texto, então não precisamos parar as palavras.
de nltk.corpus import stopwords
# Remover palavras de parada
stop = stopwords.words('inglês')
df['clean_tweet'] = df['clean_tweet'].Aplique(lambda x: ' '.join([palavra por palavra em x.split() se a palavra não estiver em (Pare)]))
df['clean_tweet'][:5]
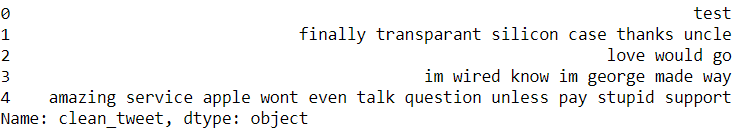
Depois de implementar todas as etapas, obtivemos nosso texto limpo. Agora, O que fazer com o texto?
- Podemos descobrir quais palavras são usadas com frequência?
- Quais palavras são usadas mais negativamente / positivamente no texto?
Tokenizar palavras e calcular a frequência e contagem de palavras e armazená-los em um quadro de dados.
Uma distribuição de frequência registra o número de vezes que cada palavra ocorreu. Por exemplo, uma nova palavra tem sido usada com frequência em dados completos seguida por outras palavras iPhone, Telefone, etc.
a = df['clean_tweet'].str.cat(sep=' ')
words = nltk.tokenize.word_tokenize(uma)
word_dist = nltk.FreqDist(palavras)
dff = pd.DataFrame(word_dist.most_common(),
                    colunas =['Word', 'Frequency'])
dff['Word_Count'] = dff.Word.apply(len)
dff[:5]
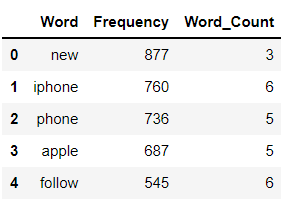
fig = px.histogram(dff[:20], x='Word', y='Frequency', altura = 300,
                   título ="Mais comum 20 palavras em tweets", color_discrete_sequence = px.colors.qualitative.T10)
fig.update_yaxes(showgrid = False),
fig.update_xaxes(ordem de categorias ="total descendente")
fig.update_traces(hovertemplate = Nenhum)
fig.update_layout(margem = dict(t = 100, b = 0, l = 70, r = 40),
                        hovermode ="x unificado",
                        xaxis_tickangle = 360,
                        xaxis_title =" ", yaxis_title =" ",
                        plot_bgcolor ="#2d3035", paper_bgcolor ="#2d3035",
                        title_font = dict(tamanho = 25, color ="#a5a7ab", familia ="Lado, sem serifa"),
                        font = dict(color ="#8a8d93"),
                          )
fig = px.bar(dff.tail(10), x='Word', y='Frequency', altura = 300,
                   título ="Menos comum 10 palavras em tweets", color_discrete_sequence = px.colors.qualitative.T10)
fig.update_yaxes(showgrid = False),
fig.update_xaxes(ordem de categorias ="total descendente")
fig.update_traces(hovertemplate = Nenhum)
fig.update_layout(margem = dict(t = 100, b = 0, l = 70, r = 40),
                        hovermode ="x unificado",
                        xaxis_title =" ", yaxis_title =" ",
                        plot_bgcolor ="#2d3035", paper_bgcolor ="#2d3035",
                        title_font = dict(tamanho = 25, color ="#a5a7ab", familia ="Lado, sem serifa"),
                        font = dict(color ="#8a8d93"),
                          )
fig = px.bar(uma, altura = 300, título ="Frequência de palavras em tweets",
             color_discrete_sequence = px.colors.qualitative.T10)
fig.update_yaxes(showgrid = False),
fig.update_xaxes(ordem de categorias ="total descendente")
fig.update_traces(hovertemplate = Nenhum)
fig.update_layout(margem = dict(t = 100, b = 0, l = 70, r = 40), showlegend = False,
                        hovermode ="x unificado",
                        xaxis_tickangle = 360,
                        xaxis_title =" ", yaxis_title =" ",
                        plot_bgcolor ="#2d3035", paper_bgcolor ="#2d3035",
                        title_font = dict(tamanho = 25, color ="#a5a7ab", familia ="Lado, sem serifa"),
                        font = dict(color ="#8a8d93"),
                          )
Análise de sentimentos
from nltk.sentiment.vader import SentimentIntensityAnalyzer
from nltk.sentiment.util import *
#Análise de sentimentos
SIA = SentimentIntensityAnalyzer()
df["clean_tweet"]= df["clean_tweet"].astype(str)
# Aplicando modelo, Criação de Variável
df['Polarity Score']= df["clean_tweet"].Aplique(lambda x:SIA.polarity_scores(x)['compound'])
df['Neutral Score']= df["clean_tweet"].Aplique(lambda x:SIA.polarity_scores(x)['neu'])
df[Negative Score']= df["clean_tweet"].Aplique(lambda x:SIA.polarity_scores(x)['neg'])
df['Positive Score']= df["clean_tweet"].Aplique(lambda x:SIA.polarity_scores(x)['pos'])
# Convertendo 0 para 1 Pontuação decimal para uma variável categórica
df['Sentiment']=''
df.loc[df['Polarity Score']>0,'Sentiment']='Positive'
df.loc[df['Polarity Score']==0,'Sentiment']='Neutral'
df.loc[df['Polarity Score']<0,'Sentiment']='Negative'
df[:5]
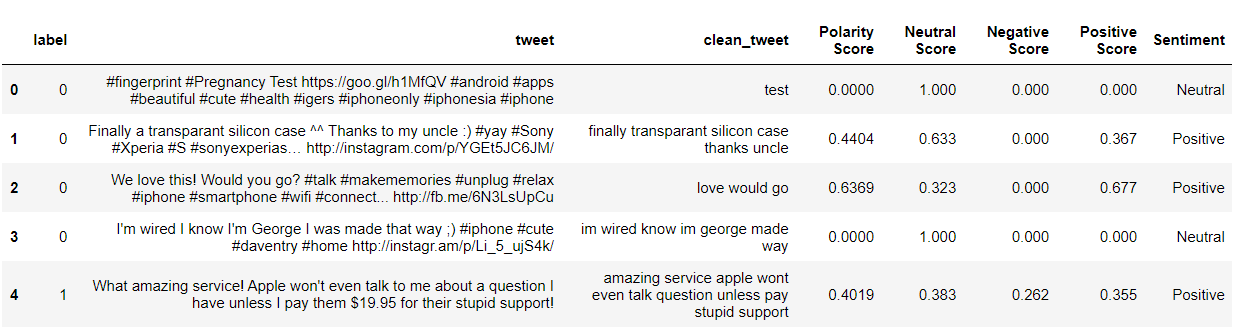
Classificação de tweets com base no sentimento
fig_pie = px.pie(df, nomes ="Sentimento", título ="Classificação de Tweets", altura = 250,
                 buraco = 0,7, color_discrete_sequence = px.colors.qualitative.T10)
fig_pie.update_traces(textfont = dict(color ="#fff"))
fig_pie.update_layout(margem = dict(t = 80, b = 30, l = 70, r = 40),
                      plot_bgcolor ="#2d3035", paper_bgcolor ="#2d3035",
                      title_font = dict(tamanho = 25, color ="#a5a7ab", familia ="Lado, sem serifa"),
                      font = dict(color ="#8a8d93"),
                      legend = dict(orientação ="h", yanchor ="fundo", y = 1, xanchor ="direito", x = 0,8)
                      )
conclusão:
Vimos como limpar dados de texto quando temos um nome de usuário do Twitter, hashtag, Links de URL, dígitos e fez análise de sentimento em dados de texto.
Vimos como descobrir se o texto contém links de URL ou dígitos com a ajuda de spacy.
Sobre o autor:
Você pode me conectar
A mídia mostrada neste artigo não é propriedade da DataPeaker e é usada a critério do autor.





