
Este artigo foi publicado como parte do Data Science Blogathon.
Visão geral
- Cada componente básico e fundamental necessário para a análise de sentimento.
- Usei uma abordagem simples para explicar todos os fundamentos, para que mesmo um leitor iniciante possa obter uma compreensão completa de todos os conceitos.
- Tópicos: Pré-processamento de texto, Corpus de vocabulário, Extração de recursos (Representação esparsa e dicionário de frequência), Modelo de regressão logística para análise de sentimento.
A análise de sentimento é uma técnica de aprendizado de máquina supervisionada usada para analisar e prever a polaridade dos sentimentos em um texto (ou positivo ou negativo).
Muitas vezes, é usado por negócios e empresas para entender a experiência de seus usuários, emoções, respostas, etc. para que possam melhorar a qualidade e flexibilidade de seus produtos e serviços.
Agora, vamos nos aprofundar no entendimento de como os engenheiros de aprendizado de máquina usam essa técnica de análise de sentimento para examinar o sentimento de vários textos.
Juntando informação
"MAIS DADOS, MELHOR! “
Existem tantas fontes de dados abertas que podem ser usadas para treinar modelos de ML, portanto, é uma escolha pessoal coletar dados você mesmo ou usar conjuntos de dados abertos para treinar nosso algoritmo.
Conjuntos de dados baseados em texto são geralmente distribuídos como JSONJSON, o Notação de objeto JavaScript, É um formato leve de troca de dados que é fácil para os humanos lerem e escreverem, e fácil para as máquinas analisarem e gerarem. É comumente usado em aplicativos da web para enviar e receber informações entre um servidor e um cliente. Sua estrutura é baseada em pares de valores-chave, tornando-o versátil e amplamente adotado no desenvolvimento de software.. o CSV formatos, então usá-los, podemos recuperar os dados em uma lista python ou em um dicionário / objeto de quadro de dados.
Os dados devem ser divididos no trem, conjuntos de validação e teste de uma maneira comum de 60% 20% 20% o 70% 15% 15%.
O popular conjunto de dados do Twitter pode ser baixado de aqui.
Pipeline
Cada tarefa de Machine Learning deve ter um PipelinePipeline é um termo usado em uma variedade de contextos, principalmente em tecnologia e gerenciamento de projetos. Refere-se a um conjunto de processos ou etapas que permitem o fluxo contínuo de trabalho desde a concepção de uma ideia até sua implementação final. Na área de desenvolvimento de software, por exemplo, Um pipeline pode incluir agendamento, Teste e implantação, garantindo assim maior eficiência e qualidade no.... Pipelines são usados para dividir seus fluxos de trabalho de aprendizado de máquina em partes modulares independentes, reutilizável, que pode ser canalizado para melhorar continuamente a precisão do modelo e obter um algoritmo de sucesso.
Seguiremos uma estrutura básica de pipeline para nosso problema, para que um leitor possa entender facilmente cada parte do pipeline usado em nosso fluxo de trabalho. Nosso pipeline incluirá as seguintes etapas:
- Pré-processamento de texto e construção de vocabulário: Eliminação de textos indesejados (palavras vazias), pontuação, URLs, identificadores, etc. que não tem valor sentimental. E, em seguida, adicione palavras únicas pré-processadas a um vocabulário.
- Extração de recursos: Iterando em cada exemplo de dados para extrair características usando um dicionário de frequência e, finalmente, criar uma matriz de características.
- Modelo de TreinamentoO treinamento é um processo sistemático projetado para melhorar as habilidades, Conhecimento ou habilidades físicas. É aplicado em várias áreas, como esporte, Educação e desenvolvimento profissional. Um programa de treinamento eficaz inclui planejamento de metas, prática regular e avaliação do progresso. A adaptação às necessidades individuais e a motivação são fatores-chave para alcançar resultados bem-sucedidos e sustentáveis em qualquer disciplina....: Em seguida, usaremos nossa matriz de recursos para treinar um modelo de regressão logística para usar esse modelo para prever sentimentos..
- Padrão de teste: Usando nosso modelo treinado para obter as previsões de dados que você nunca viu.
Pré-processamento de dados
É uma etapa importante em nosso portfólio de projetos. O pré-processamento de texto pode ser usado para remover palavras e pontuações de dados de texto que não têm valor sentimental, já que o pré-processamento de texto pode melhorar significativamente nosso tempo de treinamento, uma vez que o tamanho dos nossos dados será reduzido e será limitado a palavras que tenham algum valor sentimental. O pré-processamento inclui o manuseio de
-
Por palavras
Palavras que não têm valor / peso semântico ou sentimental em uma frase. por exemplo: e, isto é, a, tu, etc.
Como processá-los? Criaremos uma lista que inclui todas as palavras irrelevantes possíveis, como
['nós mesmos', 'dela', 'entre', 'você mesma', 'mas', 'novamente', 'lá', 'cerca de', 'uma vez', 'no decorrer', 'Fora', 'muito', 'tendo', 'com', 'elas', 'ter', 'um', 'ser', 'algum', 'para', 'Faz', 'Está', 'Sua', 'tal', 'em', 'do', 'maioria', 'em si', 'de outros', 'desligado', 'é', 'S', 'sou', 'ou', 'quem', 'Como', 'a partir de', 'dele', 'cada', 'a', 'eles mesmos', 'até', 'abaixo', 'estão', 'nós', 'esses', 'sua', 'seu', 'Através dos', 'vestir', 'nem', 'mim', 'estavam', 'dela', 'mais', 'ele mesmo', 'isto', 'baixa', 'deve', 'nosso', 'seus', 'enquanto', 'acima de', 'Ambas', 'acima', 'para', 'nosso', 'teve', 'ela', 'tudo', 'não', 'quando', 'no', 'algum', 'antes', 'eles', 'mesmo', 'e', 'estive', 'tenho', 'no', 'vai', 'sobre', 'faz', ‘Vocês’, 'então', 'naquela', 'Porque', 'o que', 'sobre', 'porque', 'tão', 'posso', 'fez', 'não', 'agora', 'debaixo', 'ele', 'tu', 'ela própria', 'tem', 'somente', 'Onde', 'também', 'só', 'Eu mesmo', 'que', 'Essa', 'eu', 'depois de', 'alguns', 'o qual', ‘T’, 'ser', 'E se', 'Deles', 'minha', 'contra', 'uma', 'por', 'fazendo', 'isto', 'Como as', 'avançar', 'era', 'aqui', 'que']
Iremos agora iterar através de cada exemplo em nossos dados e remover cada palavra de nossos dados que está presente na lista de palavras irrelevantes.
-
Pontuações
Os sinais de pontuação são símbolos que usamos para enfatizar nosso texto. por exemplo:! , @, #, $, etc.
Como processá-los? Vamos processá-los de maneira semelhante a como processamos palavras irrelevantes, vamos criar uma lista deles e processar cada exemplo com essa lista.
-
URLs e identificadores
URLs são os links que começam com a declaração do protocolo Http, por exemplo. ‘Https: //…’ e identificadores são usados para mencionar pessoas nas redes sociais, por exemplo. '@Nome do usuário’ ambos compartilham um significado sentimental nulo.
Como processá-los? Processe-os criando alguma função ‘process_handles_urls ()’ que pegará os dados de nosso trem e eliminará as palavras que começam com ‘https: //’ o ‘@’ de cada exemplo.
-
Derivado
Derivação é um processo de redução de uma palavra à sua palavra raiz. Por exemplo, 'vez’ é uma palavra raiz de turno, vez, vez, etc. Uma vez que a palavra raiz oferece o mesmo valor sentimental para todas as suas palavras com sufixo, podemos reduzir cada palavra à sua raiz básica, o que pode reduzir o tamanho do nosso vocabulário e tempo de treinamento. assim como.
Como processá-los? Processe-os criando alguma função ‘do_stemming ()’ que pegará os dados e derivará as palavras de cada exemplo.
-
Invólucro inferior
Devemos usar maiúsculas e minúsculas semelhantes para cada palavra nos dados para representar 'Palavra', 'PALAVRA', 'palavra’ deve haver apenas um caso a seguir, quer dizer, minúsculas, isso também pode ajudar a reduzir o tamanho do vocabulário e eliminar a repetição de palavras.
Como processá-los? iterar em cada exemplo, use o método .lower () para converter cada pedaço de texto em minúsculas.
Corpus de vocabulário
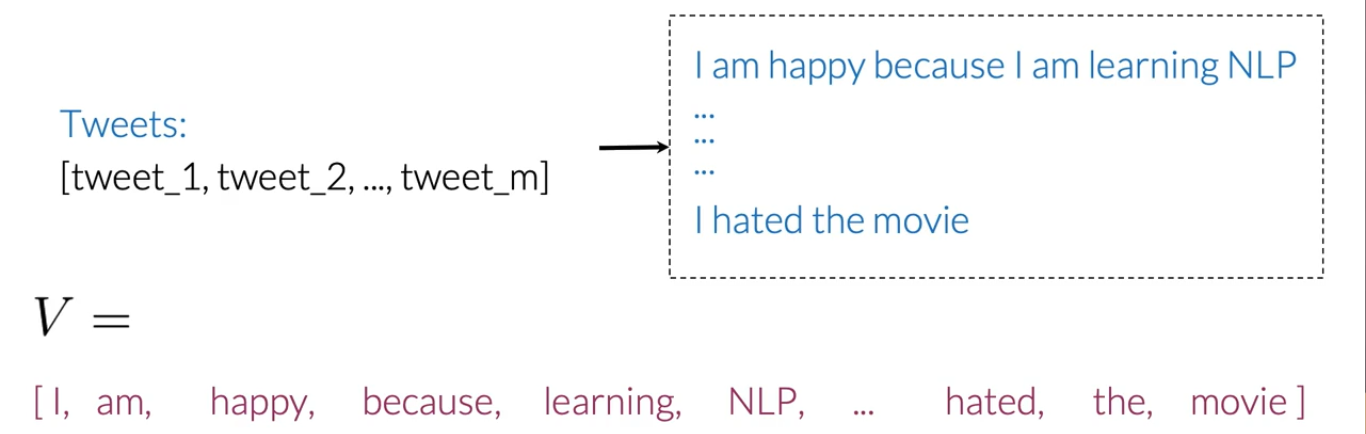
Depois de pré-processar os dados, é hora de criar um vocabulário que armazene cada palavra única e atribua algum valor numérico a cada palavra diferente (isso também é chamado de tokenização).
Usaremos este dicionário de vocabulário para extração de recursos.
Extração de recursos
Um dos problemas, ao trabalhar com processamento de linguagem, é que algoritmos de aprendizado de máquina não podem funcionar diretamente em texto bruto. Então, precisamos de algumas técnicas de extração de recursos para converter texto em um array (o vetor) características numéricas.
Vamos dar alguns exemplos de tweets positivos e negativos:
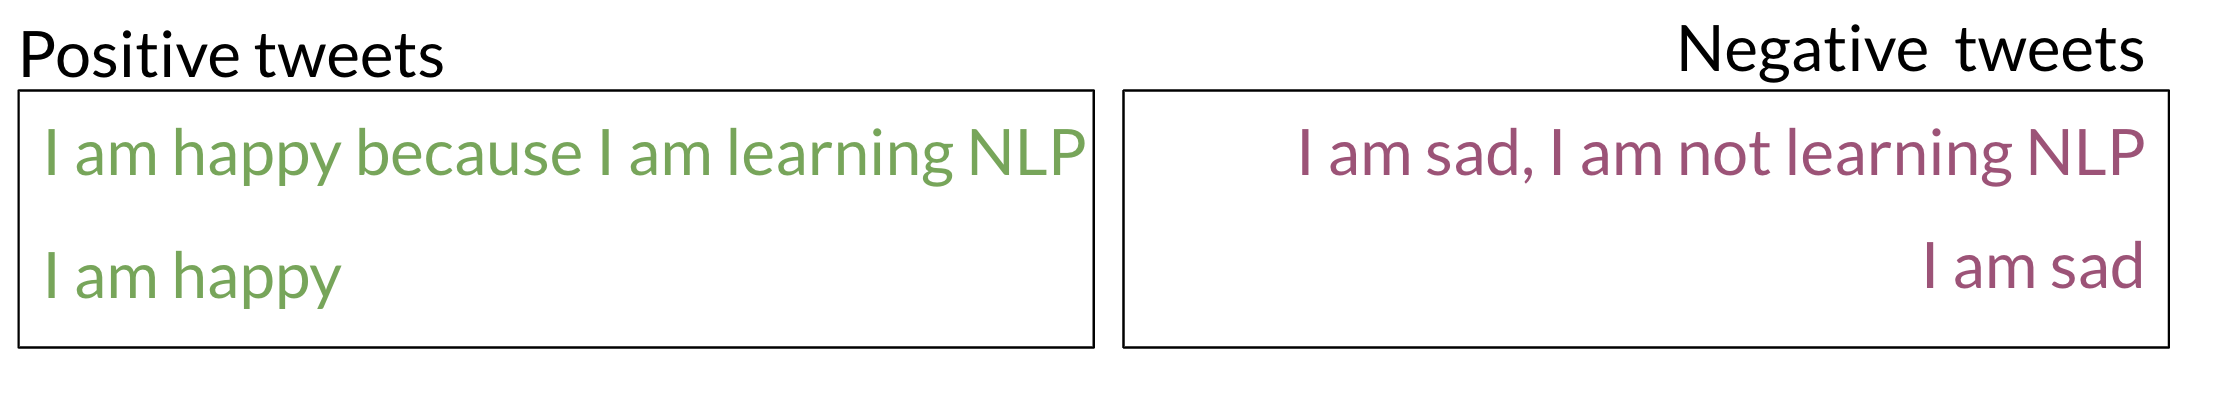
NOTA: O exemplo acima não é processado, por isso vamos processá-lo primeiro antes de passar para os passos seguintes.
Representação pobre
É uma abordagem ingênua para extrair características de um texto. De acordo com a representação esparsa, podemos criar uma série de características iterando por meio de dados completos, e para cada palavra, no exemplo de texto iremos atribuir 1 na posição dessa palavra na lista de vocabulário e para palavras que não ocorrem, nós ‘ Vou atribuir 0. Então, nossa matriz de características terá linhas = total de sentenças em nossos dados e colunas = total de palavras no vocabulário.

Desvantagens:
- Ótimo tempo de treinamento
- Ótimo tempo de previsão
Dicionário de freqüência
Um dicionário de frequência rastreia as frequências positivas e negativas de cada palavra em nossos dados.

Frequência positiva: a Número de vezes que uma palavra aparece em frases com sentimento positivo.
Frequência negativa: a Número de vezes que uma palavra aparece em frases com sentimento negativo.
Extração de recursos com dicionário de frequência:
Usando o Dicionário de Freqüência para Extração de Característica, podemos reduzir as dimensões de cada linha que representa cada frase de uma matriz de características (quer dizer, igual ao número de palavras no vocabulário em caso de sub-representação) em três dimensões.
As características dos dados de um texto são extraídas com o dicionário de características usando as seguintes fórmulas:

O processo quase parece:
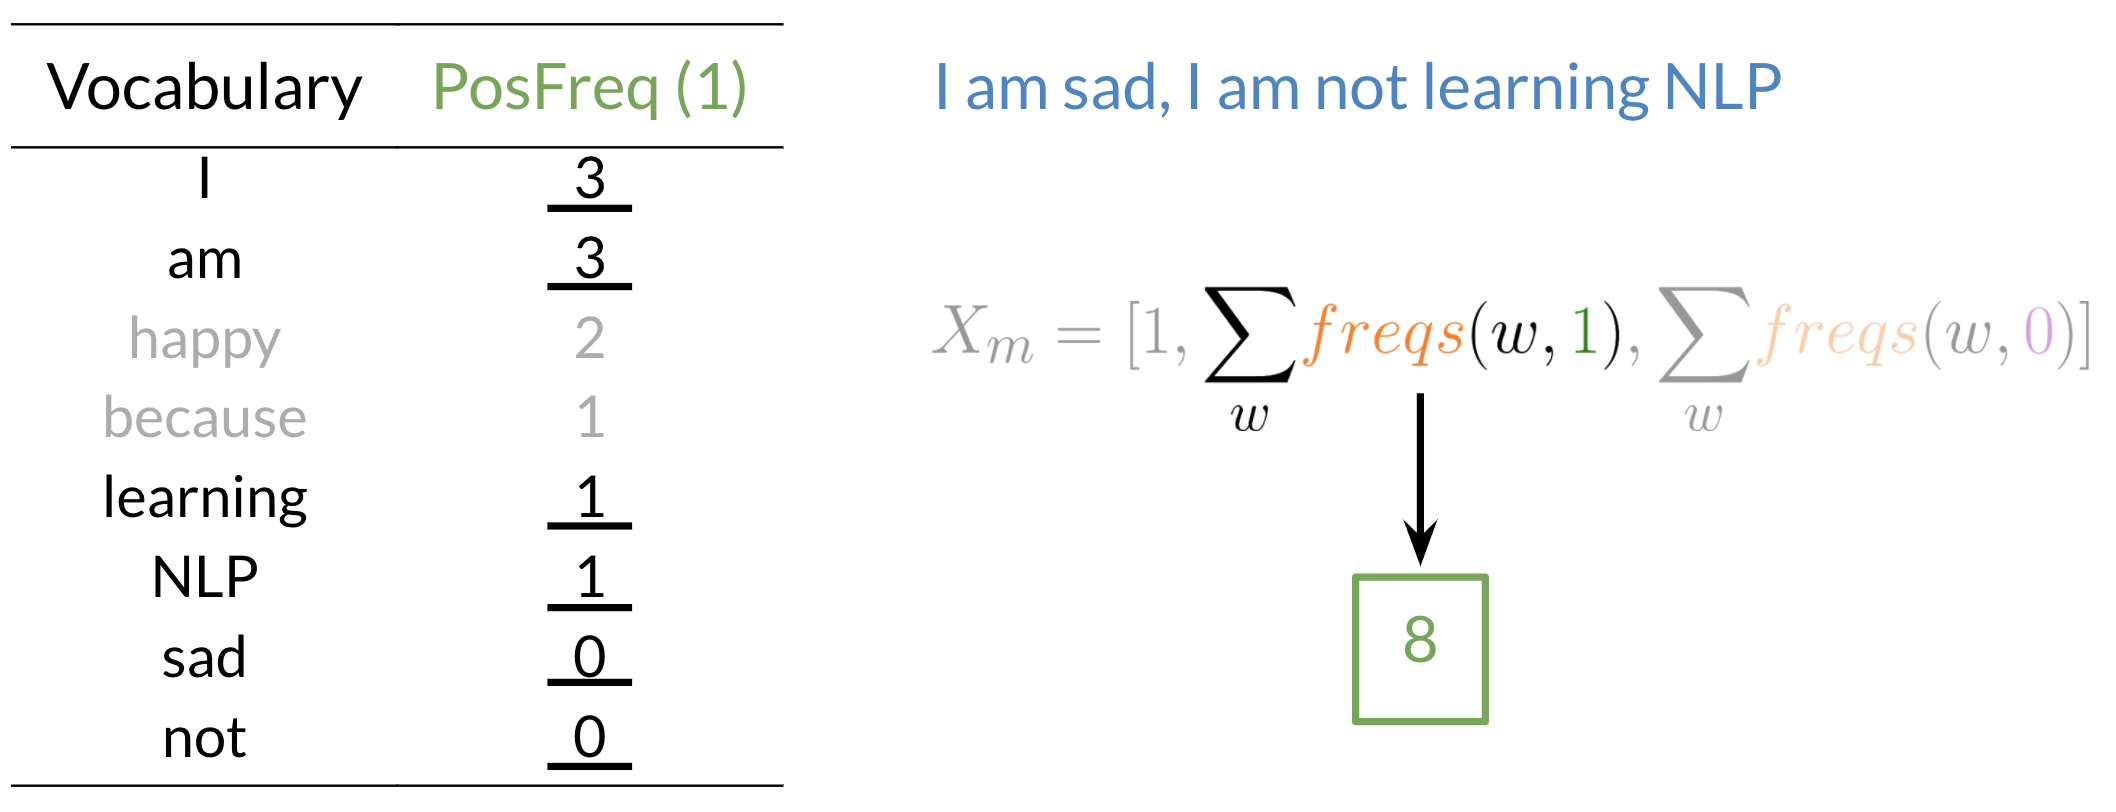
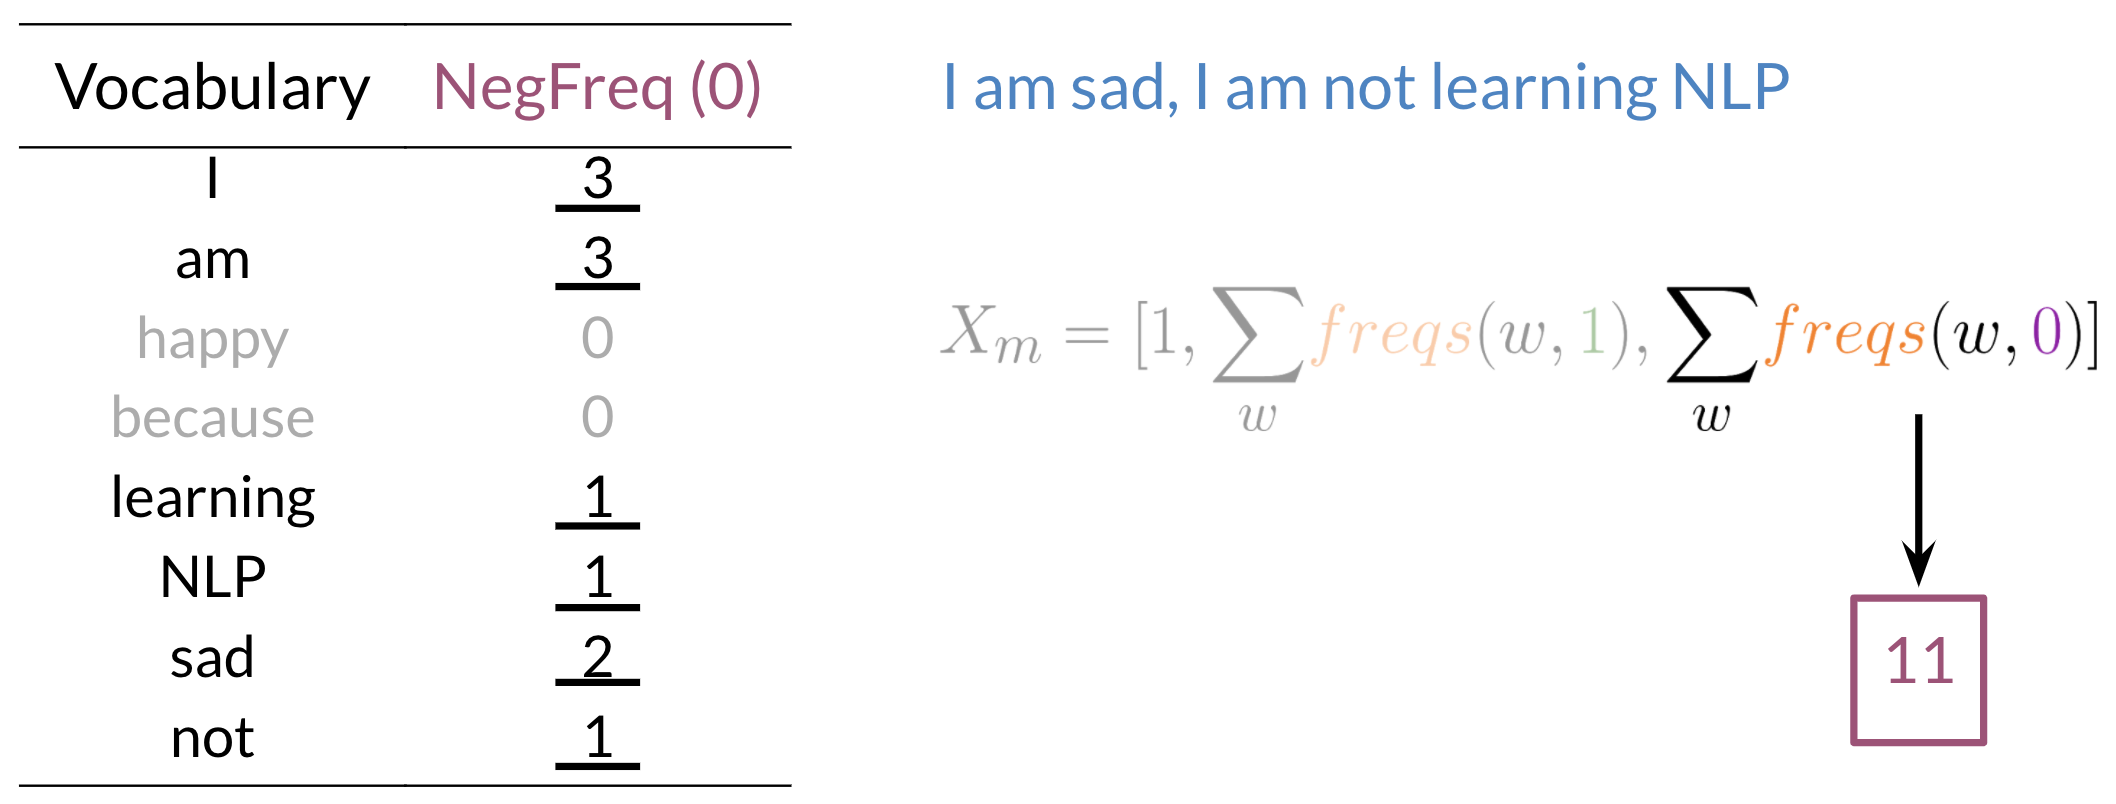
Agora temos um vetor de recursos tridimensional para nosso tweet que se parece com este:
Xm = [1,8,11]
Agora vamos iterar cada exemplo para extrair características de cada exemplo e, em seguida, usar essas características para criar a matriz de características que podemos usar para o treinamento.. Ao final, temos uma série de características como:

Regressão logística para análise de sentimento
A regressão logística modela as probabilidades de problemas de classificação com dois resultados possíveis. É uma extensão do modelo de regressão linear para problemas de classificação.
Usos de regressão logística uma função sigmóide para mapear a saída de nossa função linear (θTx) Entre 0 e 1 com algum limite (geralmente 0.5) para diferenciar entre duas classes, então se h> 0.5 é uma aula positiva, e se h <0.5 é uma classe negativa. (Explicar a regressão logística completa está além do escopo deste artigo.)

Modelo de análise de sentimento de treinamento
O treinamento do nosso modelo seguirá os seguintes passos:
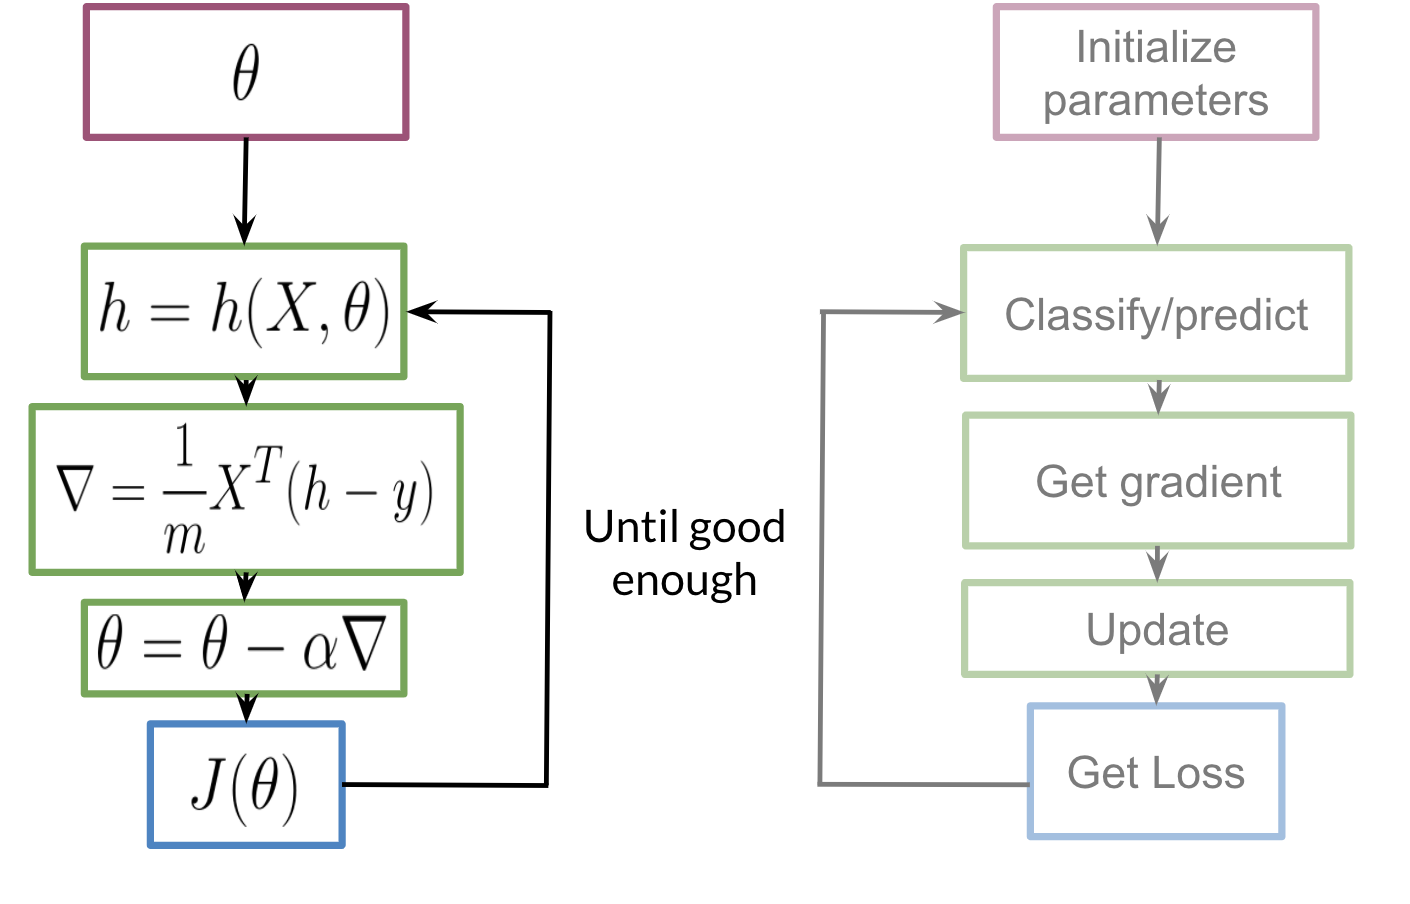
Inicializamos nosso parâmetro θ, que podemos usar em nosso sigmóide, depois calculamos o gradienteGradiente é um termo usado em vários campos, como matemática e ciência da computação, descrever uma variação contínua de valores. Na matemática, refere-se à taxa de variação de uma função, enquanto em design gráfico, Aplica-se à transição de cores. Esse conceito é essencial para entender fenômenos como otimização em algoritmos e representação visual de dados, permitindo uma melhor interpretação e análise em... que usaremos para atualizar θ e depois calculamos o custo. Continuaremos repetindo as etapas até que o custo seja minimizado / convergir.
Testando nosso modelo
Para testar nosso modelo, usaremos nosso conjunto de validação e seguiremos as seguintes etapas:
- Divida os dados em X_validation (texto) e Y_validation (sentindo-me).
- Use a extração de recursos para X_validation para transformar textos em recursos numéricos.
- Encontre o vetor h (= sigmóide (θTX)) para cada texto no conjunto de validação.
- Atribua alguma função para obter as classes reais ao comparar com um limite.
- Encontre a precisão de nossas previsões.

Resumo
Estou feliz que você tenha chegado tão longe! Se você é um iniciante no processamento de linguagem natural, Espero poder dar uma ideia de como as coisas funcionam nos bastidores e torná-lo capaz de cobrir tópicos mais complexos e avançados e, se você é um profissional, Espero ter podido revisar seus fundamentos.
O processamento de linguagem natural é um vasto domínio da inteligência artificial, seus aplicativos são usados em vários paradigmas, como chatbots, análise de sentimentos, tradução automática, auto correção, etc. Existem várias plataformas de e-learning e artigos, trabalho, etc. distribuição gratuita que pode ser útil para avançar ainda mais na jornada.
Referências: Especialização em Processamento de Linguagem Natural





