
Introdução
Todo entusiasta do aprendizado de máquina tem um sonho de construir / trabalhar em um projeto legal, não é assim? Mera compreensão da teoria não é suficiente, é necessário trabalhar em projetos, tente implementá-los e aprender com eles. O que mais, trabalhar em domínios específicos como PNL oferece amplas oportunidades e declarações de problemas para explorar. Através deste artigo, Eu quero apresentar a vocês um projeto incrível, o modelo de detecção de linguagem usando processamento de linguagem natural. Isso o levará por um exemplo do mundo real de ML (app para dizer). Então, não vamos esperar mais.
Sobre o conjunto de dados
Estamos usando o Conjunto de dados de detecção de idioma, contendo detalhes de texto para 17 idiomas diferentes.
As línguas são:
* inglês
* Português
* francês
* grego
* holandês
* Espanhol
* japonês
* russo
* dinamarquês
* Italiano
* turco
* sueco
* Arábica
* Malaiala
* hindi
* tâmil
* Telugu
Usando o texto, temos que criar um modelo que será capaz de prever o idioma dado. Esta é uma solução para muitas aplicações de inteligência artificial e linguistas computacionais.. Este tipo de sistema de previsão é amplamente utilizado em dispositivos eletrônicos, como celulares, laptops, etc. para tradução automática e também em robôs. Também ajuda a rastrear e identificar documentos multilíngues. O domínio da PNL continua sendo uma área ativa para pesquisadores.
Implementação
Importando bibliotecas e conjuntos de dados
Então vamos começar. Em primeiro lugar, importaremos todas as bibliotecas necessárias.
import pandas as pd
import numpy as np
import re
import seaborn as sns
import matplotlib.pyplot as plt
import warnings
warnings.simplefilter("ignorar")
Agora vamos importar o conjunto de dados de deteção de idioma
data = pd.read_csv("Language Detection.csv")
data.head(10)
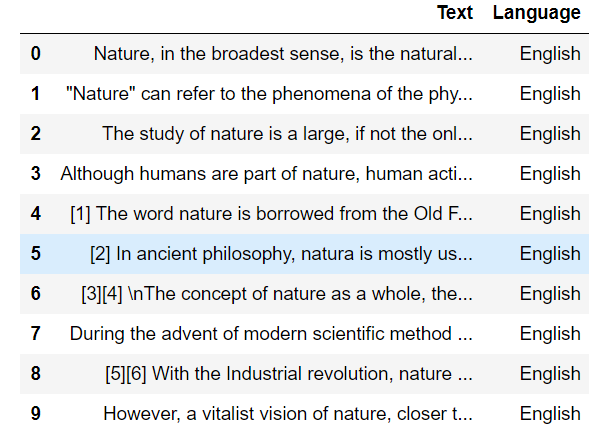
Como disse anteriormente, este conjunto de dados contém detalhes de texto para 17 idiomas diferentes. Então vamos contar o número de valores para cada idioma.
dados["Idioma"].valor_contas()
Produção :
Inglês       1385
Francês        1014
Espanhol        819
Português     739
Italiano        698
Russo        692
Sueco       676
Malaiala      594
Holandês          546
Árabe         536
Turco        474
alemão         470
tâmil          469
dinamarquês         428
Canarim        369
grego          365
hindi           63
Nome: Idioma, tipo d: int64
Separação de características independentes e dependentes
Agora podemos separar as variáveis dependentes e independentes, aqui os dados de texto são a variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos.... independente e o nome do idioma é a variável dependente.
X = dados["Texto"]
y = dados["Idioma"]
Codificação de rótulo
Nossa variável de saída, o nome das línguas, é uma variável categórica. Para treinar o modelo, deveríamos ter que convertê-lo para um formato de número, então estamos fazendo a codificação de rótulo nessa variável de saída. Para este processo, estamos a importar LabelEncoder do sklearn.
from sklearn.preprocessing import LabelEncoder
le = LabelEncoder()
y = le.fit_transform(e)
Pré-processamento de texto
Este é um conjunto de dados criado usando scraping da Wikipedia, porque contém muitos símbolos indesejados, números que irão afetar a qualidade do nosso modelo. Então deveríamos realizar técnicas de pré-processamento de texto.
# creating a list for appending the preprocessed text
data_list = []
# iterating through all the text
for text in X:
       # removing the symbols and numbers
        text = re.sub(r'[[e-mail protegido]#$(),n"%^*?:;~`0-9]', ' ', texto)
        text = re.sub(r'[[]]', ' ', texto)
        # converting the text to lower case
        text = text.lower()
        # appending to data_list
        data_list.append(texto)
Saco de palavras
Como todos sabemos, não apenas a função de saída, mas também a função de entrada devem ser de forma numérica. Então, estamos a converter texto em forma numérica criando um modelo de Bolsa de palavras usando CountVectorizer.
de sklearn.feature_extraction.text import CountVectorizer
cv = CountVectorizer()
X = cv.fit_transform(data_list).arranjar()
Forma X # (10337, 39419)
Divisão de treino e teste
Pré-processamos a nossa variável de entrada e saída. El siguiente paso es crear el conjunto de TreinamentoO treinamento é um processo sistemático projetado para melhorar as habilidades, Conhecimento ou habilidades físicas. É aplicado em várias áreas, como esporte, Educação e desenvolvimento profissional. Um programa de treinamento eficaz inclui planejamento de metas, prática regular e avaliação do progresso. A adaptação às necessidades individuais e a motivação são fatores-chave para alcançar resultados bem-sucedidos e sustentáveis em qualquer disciplina...., para entrenar el modelo y el conjunto de prueba, para avaliar el conjunto de prueba. Para este processo, estamos usando una división de prueba de tren.
de sklearn.model_selection import train_test_split
x_train, x_test, y_train, y_test = train_test_split(X, e, test_size = 0.20)
Entrenamiento y predicción de modelos
Y ya casi llegamos, la parte de creación del modelo. Estamos utilizando el algoritmo naive_bayes para a criação do nosso modelo. Posteriormente estamos a treinar o modelo usando o conjunto de treino.
from sklearn.naive_bayes import MultinomialNB
model = MultinomialNB()
model.fit(x_train, y_train)
Por isso, hemos entrenado nuestro modelo con el conjunto de entrenamento. Ahora vamos a predecir la salida del conjunto de prueba.
y_pred = model.predict(x_test)
Avaliação de modelo
Ahora podemos avaliar nuestro modelo
de sklearn.metrics import precision_score, confusão_matriz, classification_report
ac = accuracy_score(y_test, y_pred)
cm = confusion_matrix(y_test, y_pred)

imprimir("Accuracy is :",ac)
# Accuracy is : 0.9772727272727273
La precisión del modelo es 0,97, o que é muito bom e o nosso modelo está a funcionar bem. Agora vamos traçar a matriz de confusão usando o mapa de caloruma "mapa de calor" é uma representação gráfica que usa cores para mostrar a densidade de dados em uma área específica. Comumente usado em análise de dados, Estudos de marketing e comportamentais, Esse tipo de visualização permite identificar padrões e tendências rapidamente. Através de variações cromáticas, Os mapas de calor facilitam a interpretação de grandes volumes de informações, ajudando a tomar decisões informadas.... do seaborn.
plt.figure(figsize =(15,10))
sns.heatmap(cm, annot = True)
plt.show()
O gráfico ficará assim:
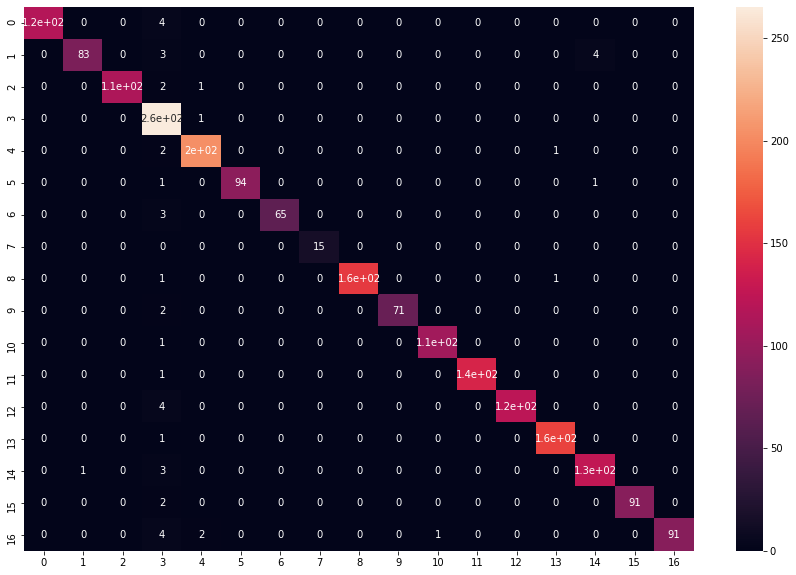
Ao analisar cada idioma, quase todas as previsões estão corretas. E se !! já quase chegaste !!
Prever com mais dados
Agora vamos testar a previsão do modelo usando texto em diferentes idiomas.
def prever(texto):
     x = cv.transform([texto]).arranjar() # convertendo texto para modelo de saco de palavras (Vetor)
     lang = model.predict(x) # predicting the language
     lang = le.inverse_transform(lang) # finding the language corresponding the the predicted value
     print("O idioma está em",lang[0]) # imprimindo o idioma
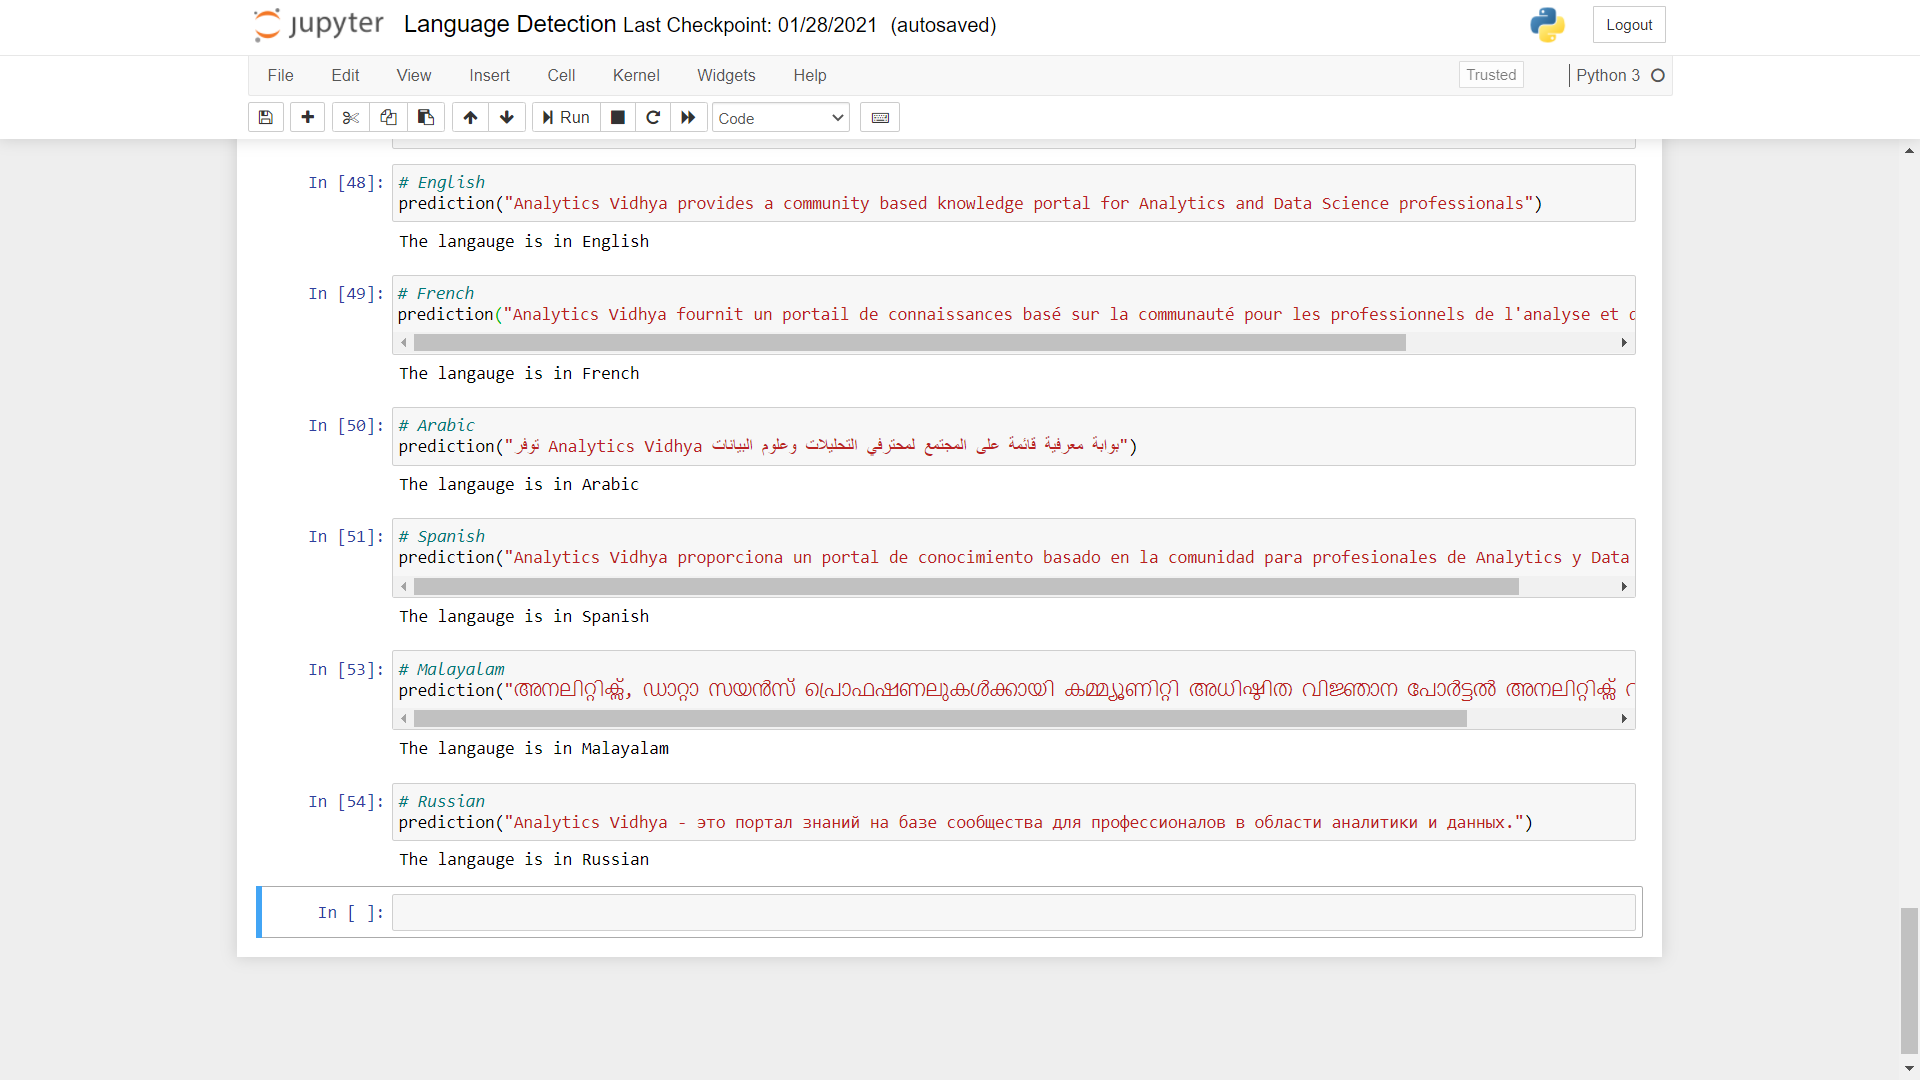
Como você pode ver, as previsões feitas pelo modelo são muito precisas. Podes realizar o teste usando outros idiomas diferentes.
Código completo
import pandas as pd
import numpy as np
import re
import seaborn as sns
import matplotlib.pyplot as plt
import warnings
warnings.simplefilter("ignorar")
# Loading the dataset
data = pd.read_csv("Language Detection.csv")
# value count for each language
data["Idioma"].valor_contas()
# separating the independent and dependant features
X = data["Texto"]
y = dados["Idioma"]
# converting categorical variables to numerical
from sklearn.preprocessing import LabelEncoder
le = LabelEncoder()
y = le.fit_transform(e)
# creating a list for appending the preprocessed text
data_list = []
# iterating through all the text
for text in X:
    # removing the symbols and numbers
    text = re.sub(r'[[e-mail protegido]#$(),n"%^*?:;~`0-9]', ' ', texto)
    text = re.sub(r'[[]]', ' ', texto)
    # converting the text to lower case
    text = text.lower()
    # appending to data_list
    data_list.append(texto)
# creating bag of words using countvectorizer
from sklearn.feature_extraction.text import CountVectorizer
cv = CountVectorizer()
X = cv.fit_transform(data_list).arranjar()
#train test splitting
from sklearn.model_selection import train_test_split
x_train, x_test, y_train, y_test = train_test_split(X, e, test_size = 0.20)
#model creation and prediction
from sklearn.naive_bayes import MultinomialNB
model = MultinomialNB()
model.fit(x_train, y_train)
# prediction
y_pred = model.predict(x_test)
# model evaluation
from sklearn.metrics import accuracy_score, confusion_matrix
ac = accuracy_score(y_test, y_pred)
cm = confusion_matrix(y_test, y_pred)
# visualising the confusion matrix
plt.figure(figsize =(15,10))
sns.heatmap(cm, annot = True)
plt.show()
# function for predicting language
def predict(texto):
    x = cv.transform([texto]).arranjar()
    lang = model.predict(x)
    lang = le.inverse_transform(lang)
    imprimir("O idioma está em",lang[0])
# English
prediction("DataPeaker fornece um portal de conhecimento comunitário para profissionais de Análise e Ciência de Dados")
# French
prediction("DataPeaker fornece um portail de conhecimentos baseado na comunidade para os profissionais de l'analyse et de la science des données")
# Arabic
prediction("توفر DataPeaker بوابة معرفية قائمة على المجتمع لمحترفي التحليلات] وعلوم البيانات")
# Spanish
prediction("DataPeaker proporciona un portal de conocimiento basado en la comunidad para profesionales de Analytics y Data Science.")
# Malayalam
prediction("അനലിറ്റിക്സ്, ഡാറ്റാ സയൻസ് പ്രൊഫഷണലുകൾക്കായി കമ്മ്യൂണിറ്റി അധിഷ്ഠിത വിജ്ഞാന പോർട്ടൽ അനലിറ്റിക്സ് വിദ്യ നൽകുന്നു")
# Russian
prediction("DataPeaker - este é um portal de conhecimento baseado na comunidade para profissionais na área de analytics e dados.")
conclusão
Esse foi um projeto interessante, verdade? Espero que tenha tido uma intuição sobre como se resolvem estes projetos. Isso definitivamente teria dado a você um diagrama de programas básicos de PNL. Você precisa analisar os dados e pré-processá-los de acordo. Um modelo de saco de palavras se torna uma forma de representar seus dados de texto. Extração de texto e vetorização são etapas importantes para fazer boas previsões em PNL. Naive Bayes sempre prova ser um modelo melhor em tais problemas de classificação de texto, para obtermos resultados mais precisos.
Você também pode encontrar o projeto completo do início ao fim para o modelo de detecção de idioma acima em meu Github
Obrigado por mostrar interesse no projeto., Espero que você continue com projetos mais incríveis e se familiarize com as declarações de problemas da vida real. Sinta-se à vontade para se conectar comigo no LinkedIn.
A mídia mostrada neste artigo não é propriedade da DataPeaker e é usada a critério do autor.





