
Introdução
Vamos resolver os ambientes do Cartpole, Lunar Lander e Pong da OpenAI com o algoritmo STRENGTH.
o Aprendizado por reforçoO aprendizado por reforço é uma técnica de inteligência artificial que permite que um agente aprenda a tomar decisões interagindo com um ambiente. Por meio de feedback na forma de recompensas ou punições, O agente otimiza seu comportamento para maximizar as recompensas acumuladas. Essa abordagem é usada em uma variedade de aplicações, De videogames a robótica e sistemas de recomendação, destacando-se por sua capacidade de aprender estratégias complexas.... es posiblemente la rama más genial de la inteligencia artificial. Já demonstrou suas proezas: surpreender o mundo, venceu os campeões mundiais em jogos de xadrez, Go e incluso DotA 2.
Neste artigo, Eu analisaria um algoritmo bastante rudimentar e mostraria como até mesmo ele pode atingir um nível de desempenho sobre-humano em certos jogos.
Aprendizagem por reforço oferece with projetando “Agentes” que interage com um “Meio Ambiente” e aprenda por si mesmo como “separar” o meio ambiente por tentativa e erro sistemáticos. Um ambiente pode ser um jogo como xadrez ou corrida, ou pode até ser uma tarefa como resolver um labirinto ou alcançar um objetivo. O agente é o bot que realiza a atividade.
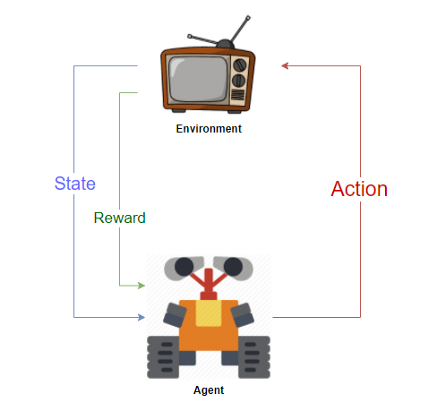
Um agente recebe “recompensas” ao interagir com o meio ambiente. O agente aprende a realizar o “Ações” necessário para maximizar a recompensa que você recebe do meio ambiente. Um ambiente é considerado resolvido se o agente acumular algum limite de recompensa predefinido. Essa conversa nerd é como ensinamos bots a jogar xadrez sobre-humano ou andróides bípedes a andar.
ALGORITMO FORTALECIDO
REINFORCE pertenece a una clase especial de algoritmos de aprendizaje por refuerzo llamados algoritmos de gradienteGradiente é um termo usado em vários campos, como matemática e ciência da computação, descrever uma variação contínua de valores. Na matemática, refere-se à taxa de variação de uma função, enquanto em design gráfico, Aplica-se à transição de cores. Esse conceito é essencial para entender fenômenos como otimização em algoritmos e representação visual de dados, permitindo uma melhor interpretação e análise em... de políticas. Uma implementação simples deste algoritmo envolveria a criação de um Política: um modelo que assume um estado como entrada e gera a probabilidade de realizar uma ação como saída. Uma política é essencialmente um guia ou folha de dicas para o agente que informa qual ação tomar em cada estado.. Mais tarde, a política é repetida e ligeiramente modificada em cada etapa até obtermos uma política que resolva o meio ambiente.
La política suele ser una neuronal vermelhoAs redes neurais são modelos computacionais inspirados no funcionamento do cérebro humano. Eles usam estruturas conhecidas como neurônios artificiais para processar e aprender com os dados. Essas redes são fundamentais no campo da inteligência artificial, permitindo avanços significativos em tarefas como reconhecimento de imagem, Processamento de linguagem natural e previsão de séries temporais, entre outros. Sua capacidade de aprender padrões complexos os torna ferramentas poderosas.. que toma el estado como entrada y genera una distribución de probabilidad en el espacio de acción como salida.
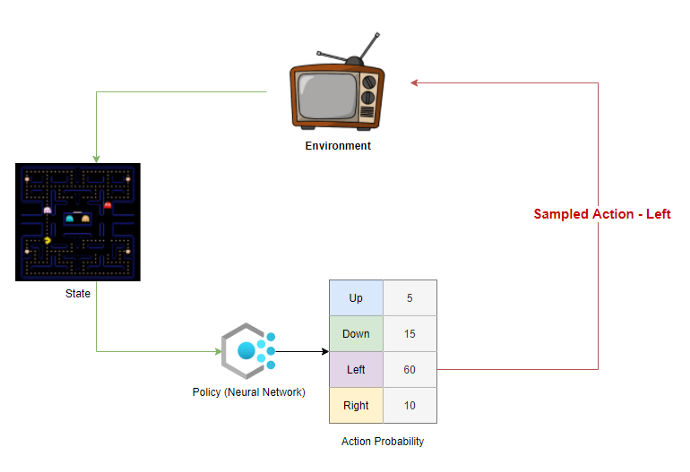
O objetivo da política é maximizar o "Recompensa esperada".
Cada política gera a probabilidade de realizar uma ação em cada estação do ambiente.
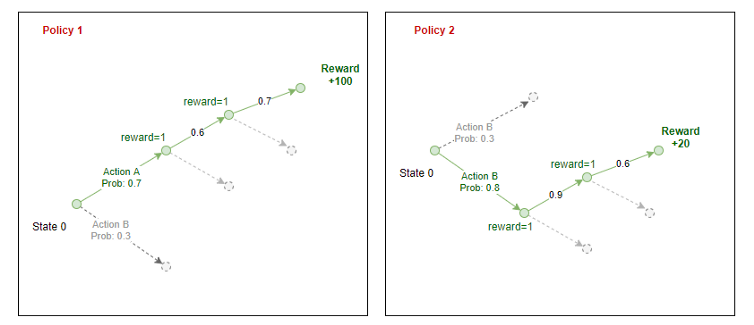
O agente obtém amostras dessas probabilidades e seleciona uma ação a ser executada no ambiente. No final de um episódio, sabemos as recompensas totais que o agente pode obter se seguir essa política. Repropagamos a recompensa por meio da rota que o agente seguiu para estimar o “recompensa esperada” em cada estado para uma determinada política.
Aqui, a recompensa com desconto é a soma de todas as recompensas que o agente recebe naquele futuro, descontadas por um fator Gama.
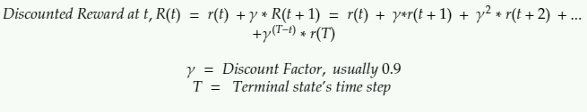
A recompensa com desconto em qualquer estágio é a recompensa que você receberá na próxima etapa + uma soma com desconto de todas as recompensas que o agente receberá no futuro.
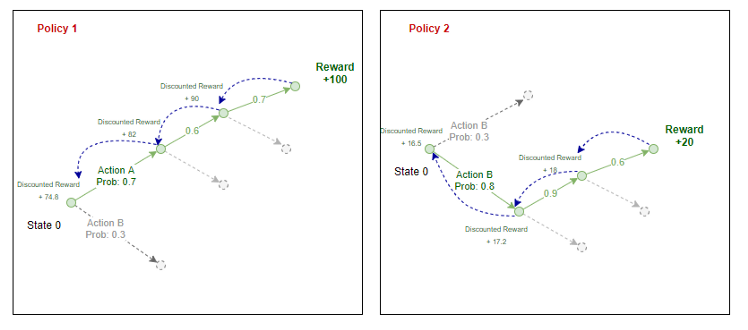
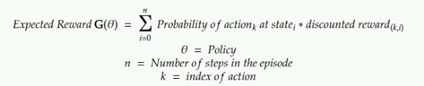
Para a equação acima, é assim que calculamos a recompensa esperada:
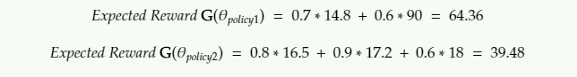
De acordo com a implementação original do algoritmo STRENGTH, a recompensa esperada é a soma dos produtos de um registro de probabilidades e recompensas descontadas.
Etapas do algoritmo
As etapas envolvidas na implementação do REINFORCE seriam as seguintes:
- Inicialize uma política aleatória (um NN que assume o estado como entrada e retorna a probabilidade de ações)
- Use a política para jogar as N etapas do jogo: registrar probabilidades de ação, da política, a recompensa do meio ambiente, a ação, amostrado pelo agente
- Calcule a recompensa com desconto para cada etapa por retropropagação
- Calcule a recompensa esperada G
- Ajuste os pesos da política (erro de propagação reversa em NN) para aumentar G
- Repita de 2
Veja a implementação usando Pytorch em meu Github.
População
Eu testei o algoritmo em Pong, CartPole e Lunar Lander. Leva uma eternidade para treinar em Pong e Lunar Lander: mais de 96 horas de TreinamentoO treinamento é um processo sistemático projetado para melhorar as habilidades, Conhecimento ou habilidades físicas. É aplicado em várias áreas, como esporte, Educação e desenvolvimento profissional. Um programa de treinamento eficaz inclui planejamento de metas, prática regular e avaliação do progresso. A adaptação às necessidades individuais e a motivação são fatores-chave para alcançar resultados bem-sucedidos e sustentáveis em qualquer disciplina.... cada uno en una GPU en la nube. Existem várias atualizações para este algoritmo que podem torná-lo convergir mais rápido, que não discuti ou implementei aqui. Confira os Modelos de Ator Crítico e a Otimização de Política Futura se você estiver interessado em saber mais.
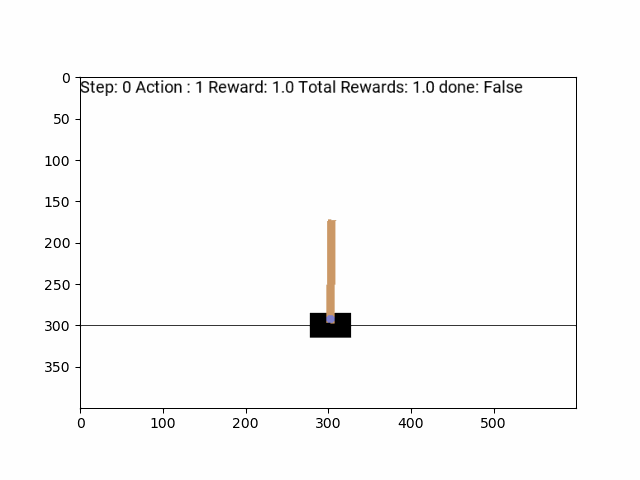
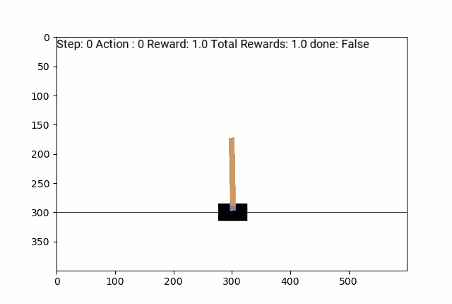
Carrinho
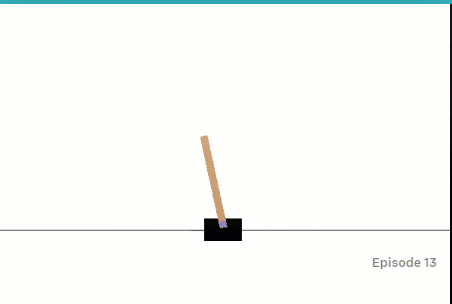
Estado:
Posição horizontal, velocidade horizontal, ângulo do pólo, velocidade angular
Comportamento:
Empurre o carro para a esquerda, Empurre o carro para a direita
Jogo aleatório de política:
Política de agentes treinados com REINFORCE:
Lander lunar
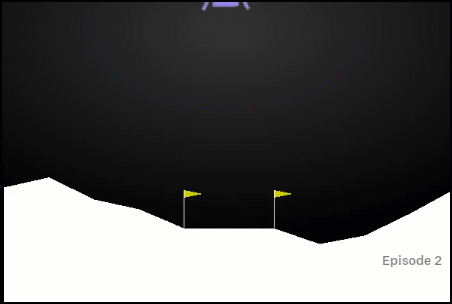
Agente de jogo aleatório
Estado:
O estado é uma matriz de 8 vetor. Não tenho certeza do que eles representam.
Comportamento:
0: não fazer nada
1: carro de bombeiros esquerdo
2: Viatura de bombeiros
3: viatura de bombeiros certa
Política de agentes treinados com REINFORCE:
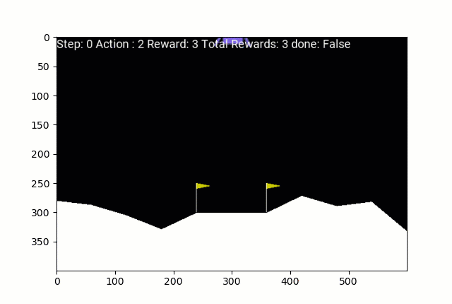
Lunar Lander treinado com REINFORCE
Fedor
Isso foi muito mais difícil de treinar. Treinado em um servidor de nuvem GPU por dias.
Estado: Imagem
Comportamento: Mover paleta para a esquerda, mover paleta para a direita
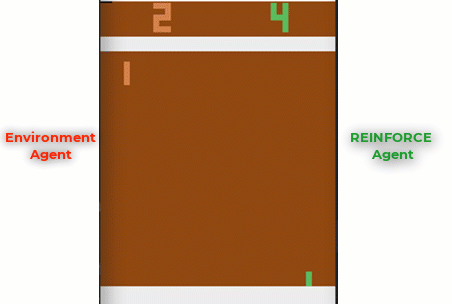
Agente treinado
A aprendizagem por reforço progrediu aos trancos e barrancos além do REFORÇO. Meu objetivo neste artigo era 1. aprender os fundamentos da aprendizagem por reforço e 2. mostram como esses métodos simples podem ser poderosos para resolver problemas complexos. Eu adoraria experimentá-los em alguns “jogos” para ganhar dinheiro como negociar ações … Acho que esse é o Santo Graal entre os cientistas de dados.
Repositório Github: https://github.com/kvsnoufal/reinforce
Ombros de gigantes:
- Algoritmos de gradiente de política (https://lilianweng.github.io/lil-log/2018/04/08/policy-gradient-algorithms.html)
- Derivando REINFORCE (https://medium.com/@thechrisyoon/deriving-policy-gradients-and-implementing-reinforce-f887949bd63)
- Curso de Aprendizagem por Reforço Udacity (https://github.com/udacity/deep-reinforcement-learning)
Sobre o autor
Noufal kvs
Trabalho na Dubai Holding, Emirados Árabes Unidos como cientista de dados. Você pode entrar em contato comigo em [e-mail protegido] o https://www.linkedin.com/in/kvsnoufal/





