
Introdução
Tabela de conteúdo
- Por que devemos usar a engenharia de funções em ciência de dados?
- Seleção de recursos
- Tratamento de valores ausentes
- Tratamento de dados desequilibrados
- Tratamento de outliers
- Binning
- Codificação
- Escala de função
1. Por que devemos usar a engenharia de funções em ciência de dados?
En Data Science, o desempenho do modelo depende do pré-processamento e manuseio de dados. Suponha que se construirmos um modelo sem manipulação de dados, obtemos uma precisão de cerca 70%. Aplicando a engenharia de funções no mesmo modelo, existe a possibilidade de aumentar o desempenho do 70% Para mais.
Simplesmente, ao usar a engenharia de funções, melhoramos o desempenho do modelo.
2. Seleção de recursos
A seleção de funções nada mais é do que uma seleção de funções independentes necessárias. Selecionar as características independentes importantes que estão mais relacionadas à característica dependente ajudará a construir um bom modelo.. Existem alguns métodos para selecionar funções:
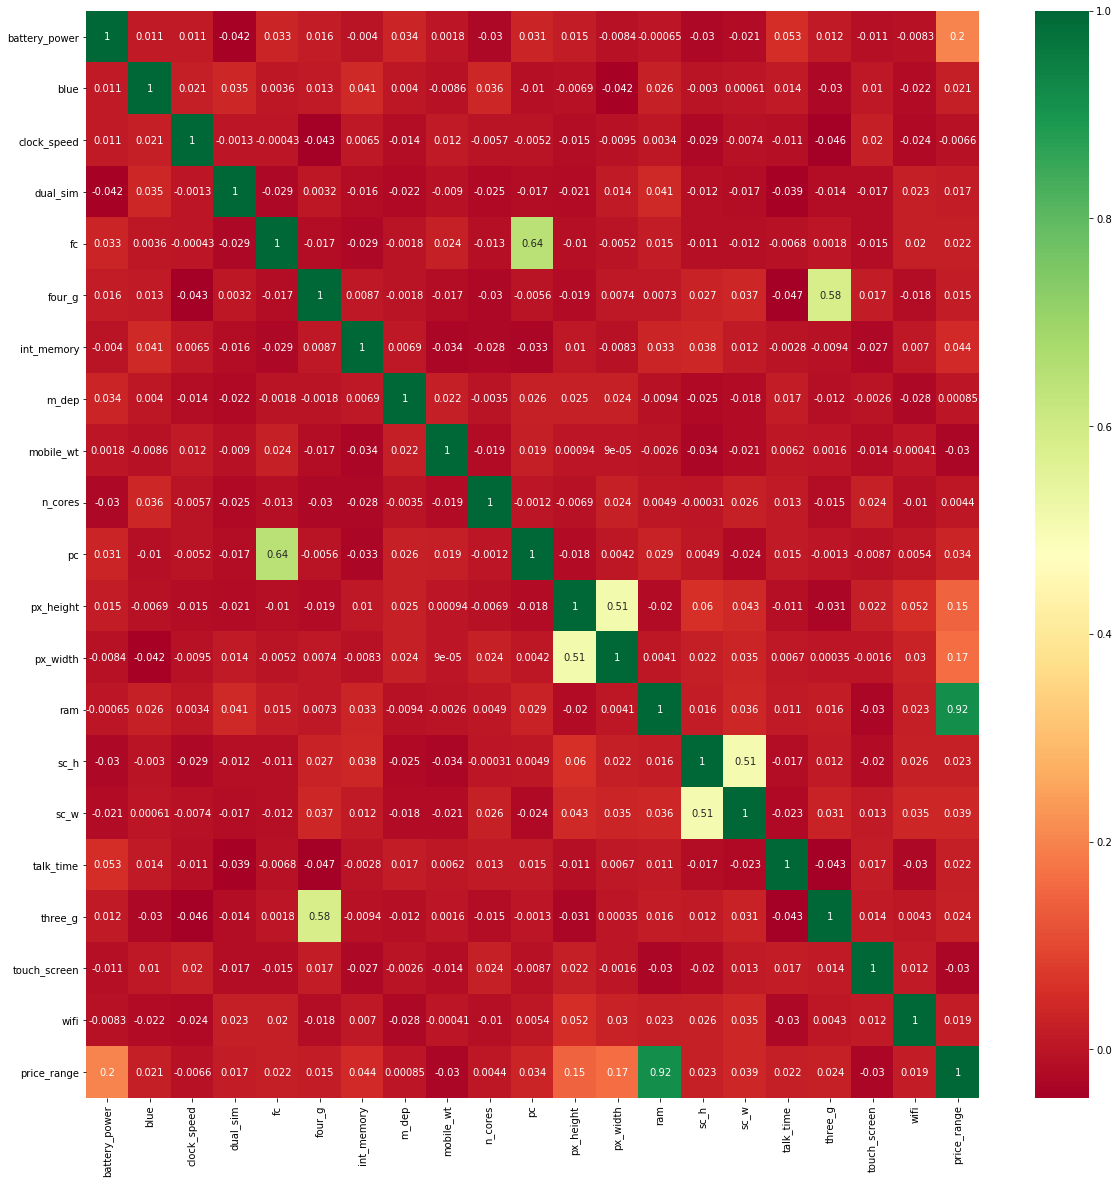
2.1 Matriz de correlação com mapa de calor
o mapa de caloruma "mapa de calor" é uma representação gráfica que usa cores para mostrar a densidade de dados em uma área específica. Comumente usado em análise de dados, Estudos de marketing e comportamentais, Esse tipo de visualização permite identificar padrões e tendências rapidamente. Através de variações cromáticas, Os mapas de calor facilitam a interpretação de grandes volumes de informações, ajudando a tomar decisões informadas.... é uma representação gráfica de dados 2D (bidimensional). Cada valor de dados é representado em uma matriz.
Em primeiro lugar, desenhe o gráfico de pares entre todas as características independentes e características dependentes. Irá dar a relação entre as características dependentes e independentes. A relação entre a característica independente e a característica dependente é menor que 0.2, em seguida, escolha esse recurso independente para construir um modelo.
2.2 Seleção univariada
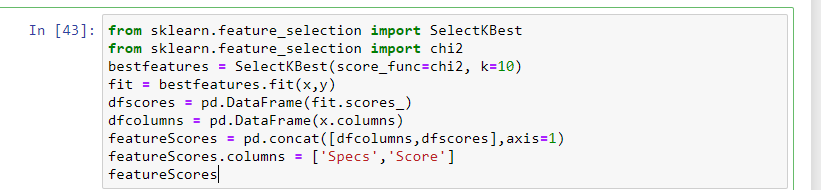
Nisto, testes estatísticos podem ser usados para selecionar as características independentes que têm a relação mais forte com a característica dependente. Selecione KBest O método pode ser usado com um conjunto de diferentes testes estatísticos para selecionar um número específico de características.
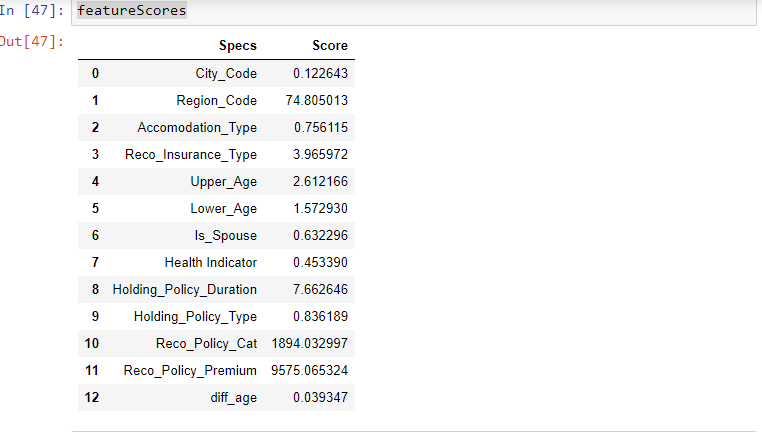
- A característica que tem a pontuação mais alta estará mais relacionada à característica dependente e escolherá essas características para o modelo.
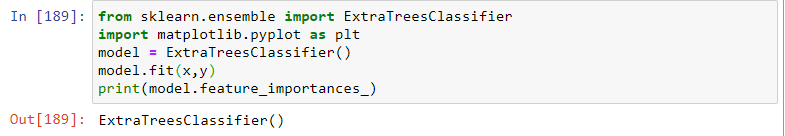
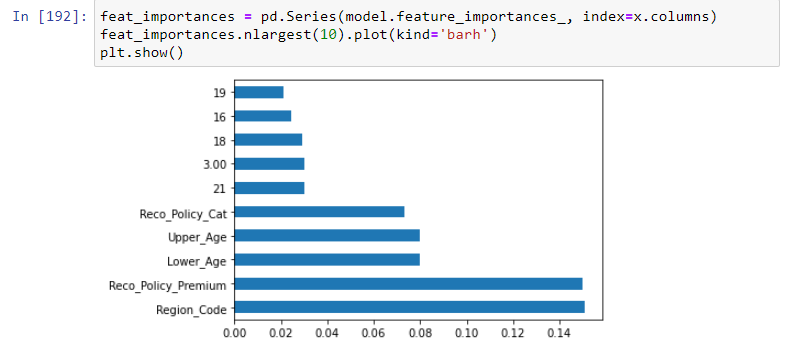
2.3 Método ExtraTreesClassifier
Neste método, o método ExtraTreesClassifier ajudará a dar a importância de cada característica independente com uma característica dependente. A importância da função lhe dará uma pontuação para cada função em seus dados, quanto maior a pontuação, mais importante ou relevante para a função com respeito a sua variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos.... Saída.
3. Tratamento de valores ausentes
Em alguns conjuntos de dados, obtivemos os valores NA nas características. Eles estão apenas faltando dados. Manipulando este tipo de dados, existem muitas maneiras:
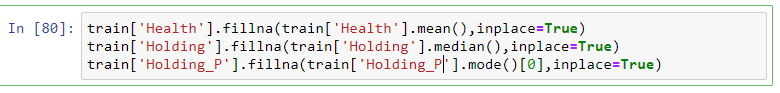
- Nos lugares de valores perdidos, para substituir os valores em falta pela média ou medianaA mediana é uma medida estatística que representa o valor central de um conjunto de dados ordenados. Para calculá-lo, Os dados são organizados do menor para o maior e o número no meio é identificado. Se houver um número par de observações, Os dois valores principais são calculados em média. Este indicador é especialmente útil em distribuições assimétricas, uma vez que não é afetado por valores extremos.... nos dados numéricos e para os dados categóricos pela moda.
- Elimine os valores NA em linhas inteiras.

- Elimine os valores de NA para recursos completos. (ajuda se os valores de NA forem mais do que 50% em uma função)

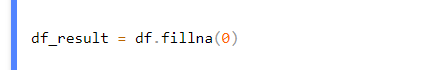
- Substitua os valores NA por 0.
Se você escolher descartar as opções, existe a possibilidade de perder informações importantes deles. Portanto, é melhor escolher substituir as opções.
4. Tratamento de dados desequilibrados
Por que é necessário lidar com dados desequilibrados? Devido a reduzir o problema de sobreajuste e desajuste.
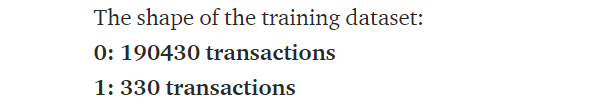
suponha uma característica tem um nível de fator 2 (0 e 1). consiste em 1 isto é 5% e 0 isto é 95%. São chamados de dados não balanceados.
Exemplo:-
Para evitar este problema, existem alguns métodos:
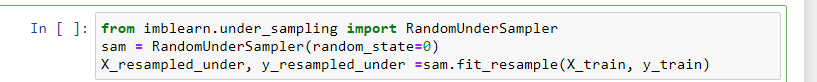
4.1 Classe de maioria com subamostragem
Uma subamostragem da classe majoritária irá reamostrar os pontos da classe majoritária nos dados para torná-los iguais à classe minoritária.
4.2 Duplicação de classes minoritárias de sobreamostragem
A amostragem excessiva da classe minoritária irá reamostrar os pontos da classe minoritária nos dados para torná-los iguais à classe majoritária.

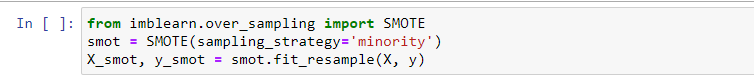
4.3 Superamostragem da classe da minoria usando a técnica de superamostragem sintética da minoria (SMOTE)
Neste método, amostras sintéticas são geradas para a classe minoritária e iguais à classe majoritária.
5. Tratamento de outliers
Em primeiro lugar, calcular a assimetria dos recursos e verificar se eles são tendenciosos positivamente, tendenciosa ou negativa. Outro método é plotar o gráfico de caixa nas características e verificar se algum valor está fora dos limites ou não.. se eles existem, são chamados de outliers.
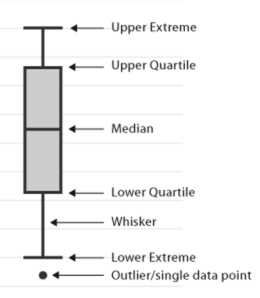
como lidar com esses outliers: –
Primeiro, calcular valores de quantis em 25% e 75%.
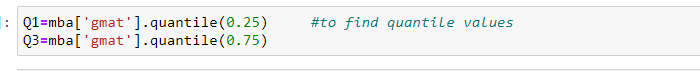
- a seguir, calcular o intervalo interquartil
IQR = Q3 – T1

- A seguir, calcular os valores dos extremos superior e inferior.
extremidade inferior = Q1 – 1,5 * IQR
extremidade superior = Q3– 1,5 * IQRe
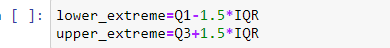
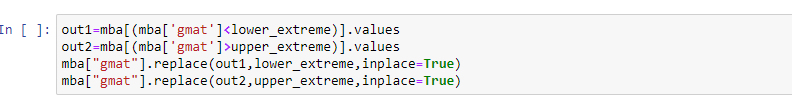
- por último, verifique se os valores estão acima do limite superior ou abaixo do limite inferior. se é apresentado, remova ou substitua-os pela meia, a mediana ou qualquer valor de quantil.
- Substitua outliers com média

- Substitua outliers por valores de quantil

6. Binning
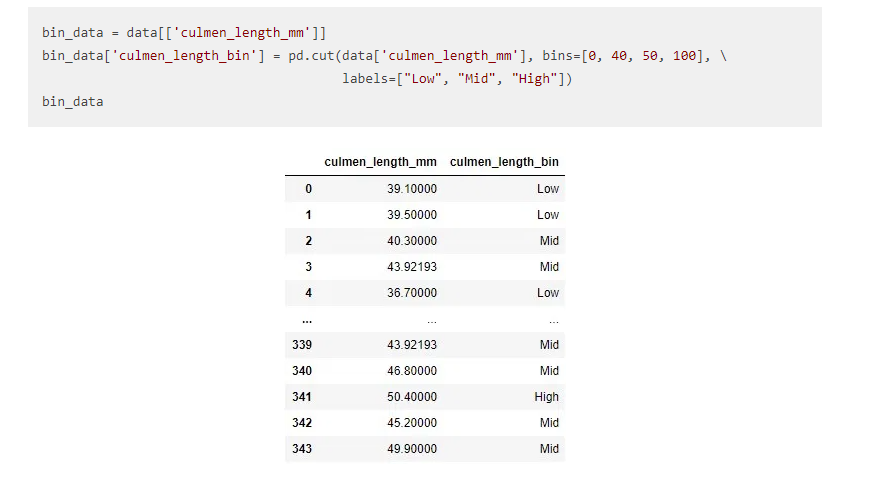
A categorização nada mais é do que qualquer valor de dados dentro do intervalo que se ajusta à categoria. É importante em sua atividade de exploração de dados. Normalmente o usamos para transformar variáveis contínuas em discretas..
Suponha que se temos a função AGE continuamente e precisamos dividir a idade em grupos como uma função, então será útil.
7. Codificação:
Por que isso se aplica? porque em conjuntos de dados podemos conter tipos de dados de objetos. construir um modelo, precisamos que todos os recursos sejam em tipos de dados inteiros. portanto, Label Encoder e OneHotEncoder são usados para converter o tipo de dados do objeto em um tipo de dados inteiro.
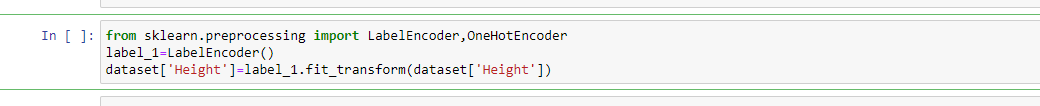
Antes de aplicar a codificação da tag
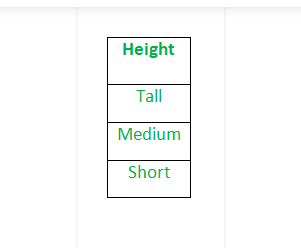
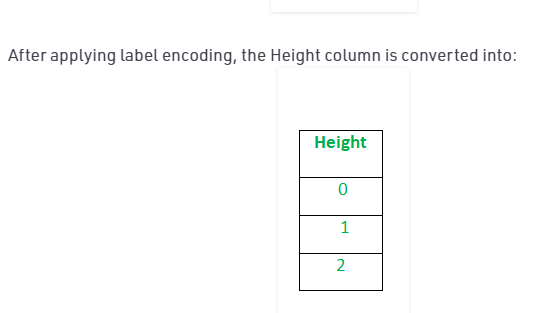
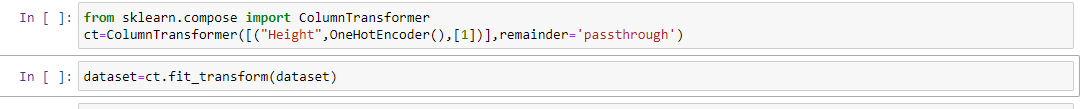
Depois de aplicar a codificação da tag, aplique o método de transformador de coluna para converter rótulos em 0 e 1
Al aplicar get_dummies, nós convertemos diretamente categórico em numérico

8. Escala de função
Por que essa escala é aplicada? porque para reduzir o efeito de variância e superar o problema de ajuste. existem dois tipos de métodos de escalonamento:
8.1 estandardização
Quando este método é usado ?. quando todas as características têm valores altos, não 0 e 1.
É uma técnica para padronizar as características independentes que ocorrem em um intervalo fixo para trazer todos os valores para as mesmas magnitudes..
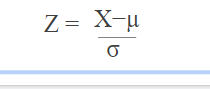
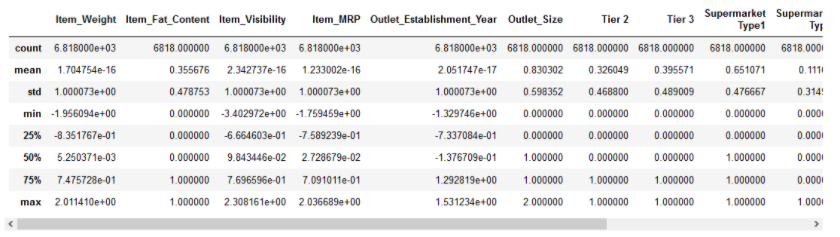
Em padronização, a média das características independentes é 0 e o desvio padrão é 1.
Método 1:

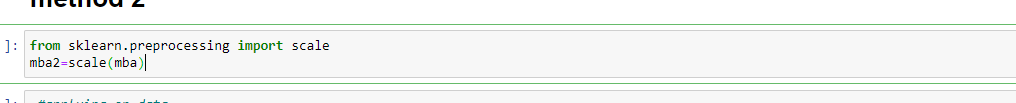
Método 2:
Após a codificação, rótulos de recursos estão ativados 0 e 1. Isso pode afetar a padronização. Para superar isso, nós usamos NormalizaçãoA padronização é um processo fundamental em várias disciplinas, que busca estabelecer padrões e critérios uniformes para melhorar a qualidade e a eficiência. Em contextos como engenharia, Educação e administração, A padronização facilita a comparação, Interoperabilidade e compreensão mútua. Ao implementar normas, a coesão é promovida e os recursos são otimizados, que contribui para o desenvolvimento sustentável e a melhoria contínua dos processos.....
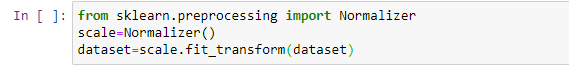
8.2 Normalização
A normalização também faz com que o processo de TreinamentoO treinamento é um processo sistemático projetado para melhorar as habilidades, Conhecimento ou habilidades físicas. É aplicado em várias áreas, como esporte, Educação e desenvolvimento profissional. Um programa de treinamento eficaz inclui planejamento de metas, prática regular e avaliação do progresso. A adaptação às necessidades individuais e a motivação são fatores-chave para alcançar resultados bem-sucedidos e sustentáveis em qualquer disciplina.... seja menos sensível à escala das características. Isso resulta na obtenção de melhores coeficientes após o treinamento..
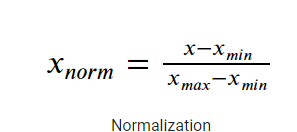
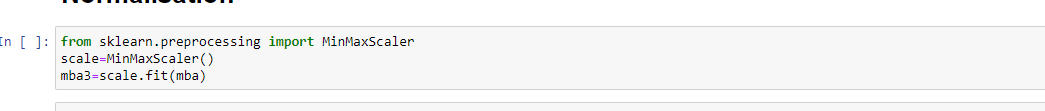
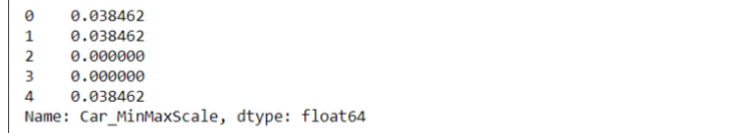
Método 1: -MinMaxScaler
É um método de redimensionar a característica para uma faixa rápida e estrita de [0,1] subtraindo o valor mínimo da característica e depois dividindo pelo intervalo.
Método 2: – Normalização média
É um método de redimensionar a característica para uma faixa rápida e estrita de [-1,1] com média = 0.
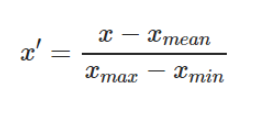
Notas finais: –
Neste artigo, Abordei o processo de engenharia de funções passo a passo. Isso é mais útil para aumentar a precisão da previsão..
Observe que não existem métodos específicos para aumentar a precisão de sua previsão. Tudo depende dos seus dados e aplica vários métodos.
Como próximo passo, Eu encorajo você a experimentar diferentes conjuntos de dados e analisá-los. E não se esqueça de compartilhar suas idéias na seção de comentários abaixo!!
Sobre o autor:
Soy Pavan Kumar Reddy Elluru. Concluí minha graduação na Faculdade de Engenharia G.Pullareddy no ano 2020. Eu sou um cientista de dados certificado no ano 2021 e eu sou apaixonado por aprendizagem automática e projetos de aprendizado profundoAqui está o caminho de aprendizado para dominar o aprendizado profundo em, Uma subdisciplina da inteligência artificial, depende de redes neurais artificiais para analisar e processar grandes volumes de dados. Essa técnica permite que as máquinas aprendam padrões e executem tarefas complexas, como reconhecimento de fala e visão computacional. Sua capacidade de melhorar continuamente à medida que mais dados são fornecidos a ele o torna uma ferramenta fundamental em vários setores, da saúde....
Por favor, escreva-me em caso de qualquer dúvida ou apenas para dizer olá.
Identificação de e-mail:- [e-mail protegido]
Identificação do Linkedin: – www.linkedin.com/in/elluru-pavan-kumar-reddy-a1b183197
ID de Github: – pawankumarreddy1999 (Pavan Kumar Reddy Elluru) (github.com)





