
Introdução
A estatística de pedidos é um conceito muito útil em ciência estatística. Eles têm uma ampla gama de aplicações, incluindo modelagem de leilão, apólices de seguros e corridas de automóveis, otimização dos processos de produção, estimación de parametroso "parametros" são variáveis ou critérios usados para definir, medir ou avaliar um fenômeno ou sistema. Em vários domínios, como a estatística, Ciência da Computação e Pesquisa Científica, Os parâmetros são essenciais para estabelecer normas e padrões que orientam a análise e interpretação dos dados. Sua seleção e manuseio adequados são cruciais para obter resultados precisos e relevantes em qualquer estudo ou projeto.... de distribuciones, et al. Através deste artigo, vamos entender a ideia de estatísticas de pedidos. Primeiro entenderemos seu significado e gradualmente procederemos à sua distribuição., eventualmente cobrindo conceitos mais avançados.
Suponha que temos um conjunto de variáveis aleatórias X1, X2, …, XNorte, que são independentes e distribuídos de forma idêntica (iid). Pela independência, queremos dizer que el valor tomado por una variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos.... aleatoria no está influenciado por los valores tomados por otras variables aleatórias. Por distribuição idêntica, queremos dizer que a função de densidade de probabilidade (PDF) (ou equivalente, a função de distribuição cumulativa, CDF) para variáveis aleatórias é o mesmo. O Kº A estatística de ordem para este conjunto de variáveis aleatórias é definida como kº menor valor de amostra.
Para entender melhor este conceito, tomaremos 5 variáveis aleatórias X1, X2, X3, X4, X5. Vamos observar uma realização / resultado aleatório da distribuição de cada uma dessas variáveis aleatórias. Suponha que obtivemos os seguintes valores:
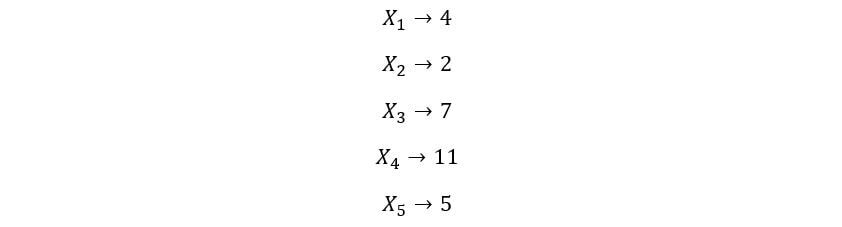
O Kº a estatística de pedido para este experimento é kº menor valor do conjunto {4, 2, 7, 11, 5}. Então, a 1S t a estatística do pedido é 2 (menor valor), a 2Dakota do Norte a estatística do pedido é 4 (o próximo menor), e assim por diante. o 5º a estatística do pedido é o quinto menor valor (o maior valor), o que é 11. Repetimos esse processo muitas vezes, quer dizer, extraímos amostras da distribuição de cada uma dessas variáveis aleatórias iid e encontramos o kº menor valor para cada conjunto de observações. A distribuição de probabilidade desses valores dá a distribuição de kº estatísticas de pedidos.
Em geral, se ordenarmos variáveis aleatórias X1, X2, …, XNorte em ordem ascendente, então o kº a estatística do pedido é exibida como:
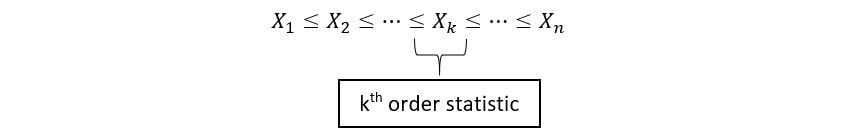
A notação geral do kº a estatística do pedido é X(k). Nota X(k) é diferente de Xk. Xk é o kº variável aleatória do nosso conjunto, enquanto X(k) é o kº ordem estatística do nosso conjunto. X(k) assume o valor de Xk sim xk é o kº Variável aleatória quando as realizações são classificadas em ordem crescente.
o 1S t Estatística de ordem X(1) é o conjunto de valores mínimos de realização do conjunto de 'n’ variáveis aleatórias. Mais tardeº Estatística de ordem X(Norte) é o conjunto de valores máximos (n-ésimo valores mínimos) da realização do conjunto de 'n’ variáveis aleatórias. Eles podem ser expressos como:
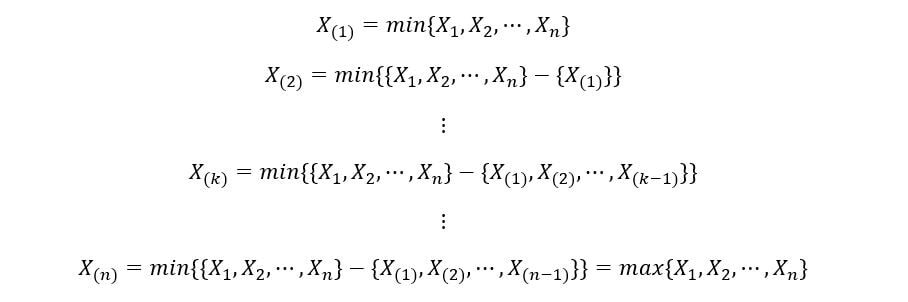
Distribuição de estatísticas de pedidos
Agora vamos tentar descobrir a distribuição das estatísticas de pedidos. Vamos primeiro descrever a distribuição de nº estatísticas de pedidos, depois ele 1S t ordem estatística e finalmente o kº estatísticas gerais de pedidos.
UMA) Distribuição de nº Estatísticas de pedidos:
Deixe a função de densidade de probabilidade (PDF) e a função de distribuição cumulativa (CDF) nossas variáveis aleatórias permitem fX(x) y FX(x) respectivamente. Por definição de CDF,
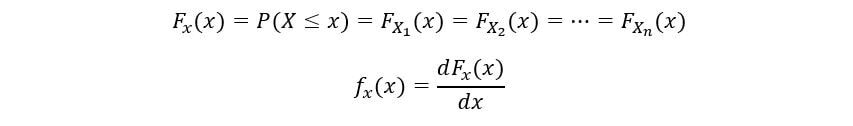
Uma vez que nossas variáveis aleatórias são distribuídas de forma idêntica, tem o mesmo PDF fX(x) y CDF FX(X). Agora vamos calcular o CDF de nº estatísticas de pedidos (FNorte(x)) Como segue:
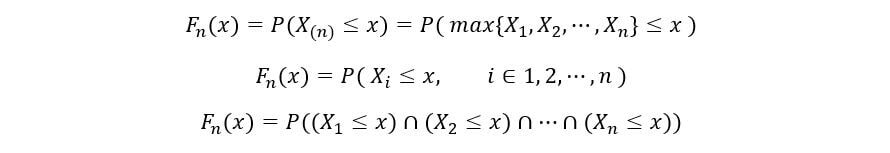
Variáveis aleatórias X1, X2, …, XNorte eles também são independentes. Por tanto, por propriedade de independência,
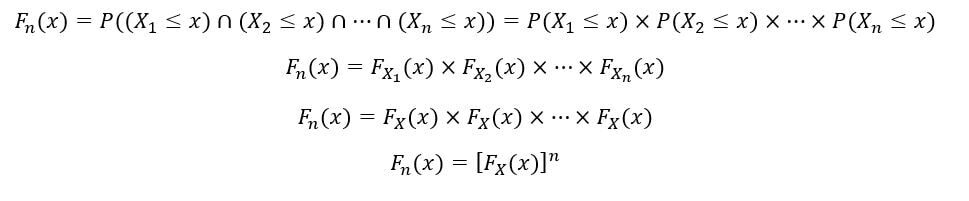
O PDF do nº ordem estatística (fNorte(x)) é calculado da seguinte forma:
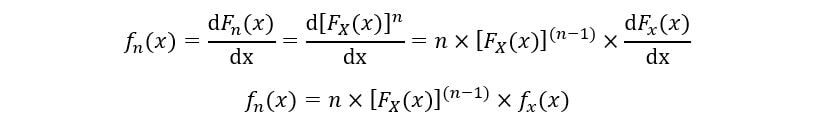
Portanto, a expressão para PDF e CDF de nº A estatística do pedido foi obtida.
B) Distribuição de 1S t Estatísticas de pedidos:
O CDF de uma variável aleatória também pode ser calculado como um menos a probabilidade de que a variável aleatória X tenha um valor maior ou igual a x. Matematicamente,
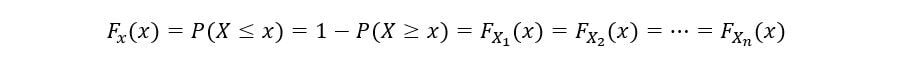
Vamos determinar o CDF de 1S t estatísticas de pedidos (F1(x)) Como segue:
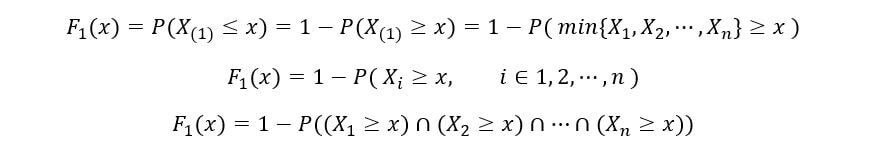
Mais uma vez, usando a propriedade de independência de variáveis aleatórias,
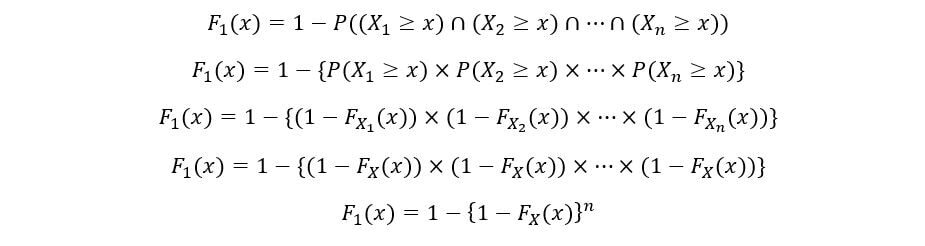
O PDF do 1S t ordem estatística (f1(x)) é calculado da seguinte forma:
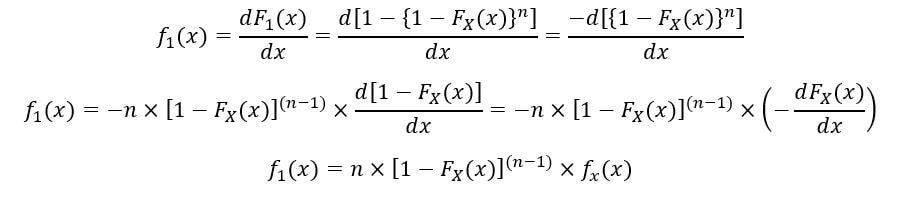
Portanto, a expressão para PDF e CDF de 1S t A estatística do pedido foi obtida.
C) Distribuição do kº Estatísticas de pedidos:
Garfoº estatísticas de pedidos, em geral, a seguinte equação descreve seu CDF (Fk(X)):
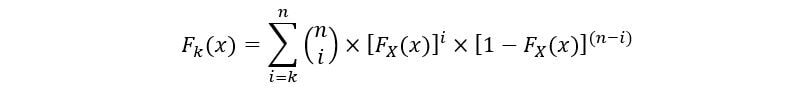
O PDF de kº ordem estatística (fk(x)) é expresso como:
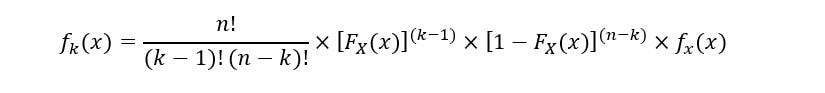
Para evitar confusões, vamos usar provas geométricas para entender a equação. Como discutido acima, o conjunto de variáveis aleatórias tem o mesmo PDF (fX(X)). O gráfico abaixo mostra um exemplo de PDF com kº Estatística de pedido obtida a partir de amostragem aleatória:
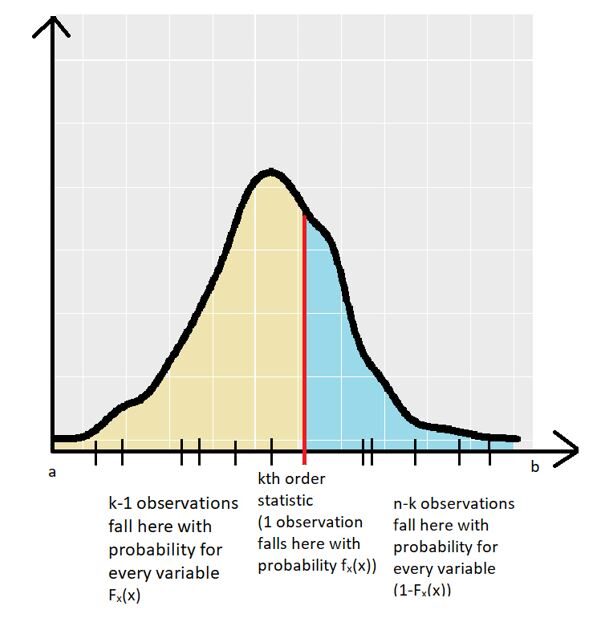
Então, o PDF das variáveis aleatórias fX(x) é definido entre o intervalo [uma,b]. A estatística de ordem k para uma amostra aleatória é mostrada com a linha vermelha. As outras realizações variáveis (para a amostra aleatória) mostrado pelas pequenas linhas pretas no eixo x.
Existem exatamente (k – 1) observações de variáveis aleatórias que caem na região amarela do gráfico (a região entre & kº estatísticas de pedidos). A probabilidade de que uma observação particular caia nesta região é dada pelo CDF das variáveis aleatórias (FX(X)). Mas estamos cientes de que (k – 1) observações caíram na região, o que nos dá o termo (pela independência) (FX(X))(k – 1).
Existem exatamente (n – k) observações de variáveis aleatórias que caem na região azul do gráfico (a região entre kº ordem estatística & b). A probabilidade de que uma determinada observação caia nesta região é dada pelo 1 – CDF das variáveis aleatórias (1- FX(X)). Mas estamos cientes de que (n – k) observações caíram na região, o que nos dá o termo (pela independência) (1-FX(X))(n – k).
Finalmente, exatamente 1 observação cai exatamente na estatística de ordem k com probabilidade fX(X). Portanto, o produto de 3 termos nos dá uma ideia do significado geométrico da equação para PDF da estatística de ordem k. Mas, De onde vem o termo fatorial? O cenário acima mostrou apenas um dos muitos pedidos. Pode haver muitas dessas combinações. O número total de tais combinações é mostrado abaixo:
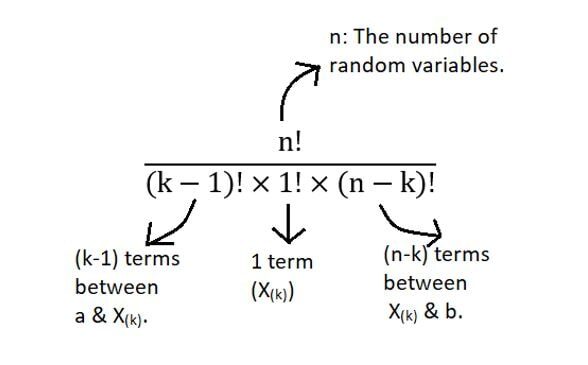
Por tanto, o produto de todos esses termos nos dá a distribuição geral de kº estatísticas de pedidos.
Funções úteis de estatísticas de pedidos
Estatísticas de pedidos levam a várias funções úteis. Entre eles, los notables incluyen el rango de la muestra y la medianaA mediana é uma medida estatística que representa o valor central de um conjunto de dados ordenados. Para calculá-lo, Os dados são organizados do menor para o maior e o número no meio é identificado. Se houver um número par de observações, Os dois valores principais são calculados em média. Este indicador é especialmente útil em distribuições assimétricas, uma vez que não é afetado por valores extremos.... de la muestra.
1) Gama de amostra: É definido como a diferença entre o maior e o menor valor. É expresso da seguinte forma:
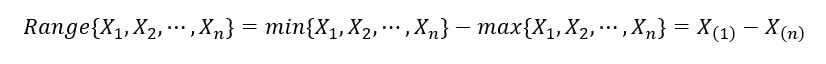
2) Mediana da amostra: A mediana da amostra divide a amostra aleatória (realizações do conjunto de variáveis aleatórias) em duas metades, um contendo as amostras de menor valor e o outro contendo as amostras de maior valor. É como a estatística de ordem média / central. É matematicamente definido como:
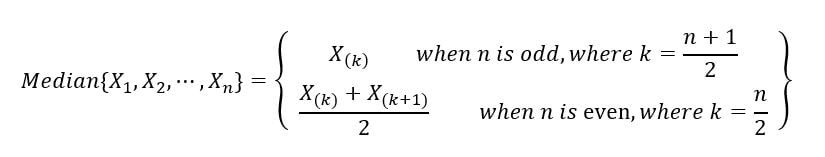
PDF do conjunto de estatísticas do pedido
Uma função de densidade de probabilidade conjunta pode nos ajudar a entender melhor a relação entre duas variáveis aleatórias (estatísticas de duas ordens
no nosso caso). O PDF conjunto para quaisquer estatísticas de 2 X pedidos(uma) & X(B), tal que 1 ≤ a ≤ b ≤ n é dado pela seguinte equação:
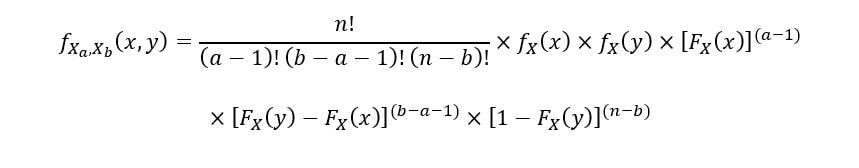
Exemplo
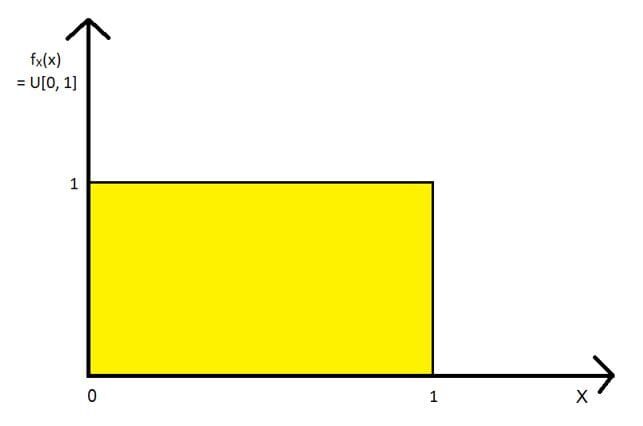
Usaremos um exemplo muito simples para ilustrar a distribuição das estatísticas do pedido: a distribuição uniforme padrão (você[0, 1] distribuição). Tomaremos 5 variáveis aleatórias X1, X2, X3, X4, X5, todo mundo tem o u[0, 1] distribuição. Para este conjunto de variáveis aleatórias, vamos calcular e traçar o 1S t, 3rd (a mediana da amostra) e 5º (Norteº) estatísticas de pedidos. O seguinte figura"Figura" é um termo usado em vários contextos, Da arte à anatomia. No campo artístico, refere-se à representação de formas humanas ou animais em esculturas e pinturas. Em anatomia, designa a forma e a estrutura do corpo. O que mais, em matemática, "figura" está relacionado a formas geométricas. Sua versatilidade o torna um conceito fundamental em várias disciplinas.... muestra la U[0, 1] distribuição:
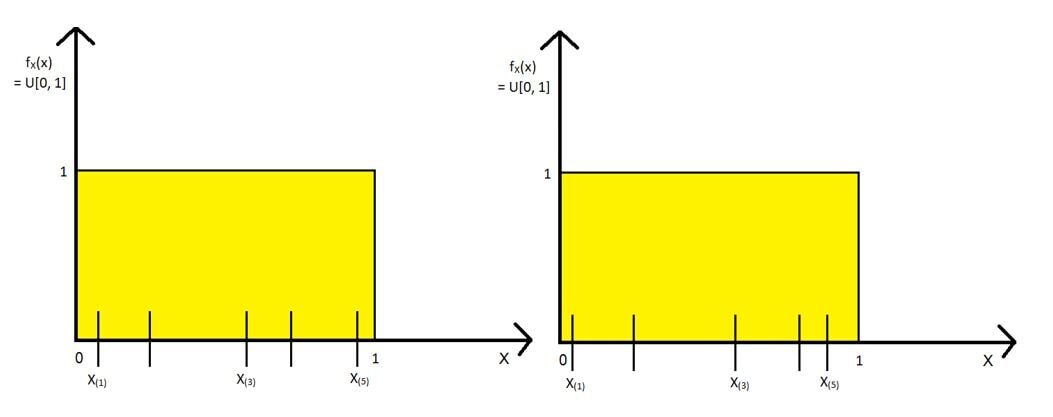
Vamos extrair amostras aleatórias da seguinte forma e encontrar o 1S t, 3rd & 5º estatística de pedido para cada amostra. Abaixo estão dois dos exemplos:
A distribuição uniforme padrão PDF e CDF são dados como:
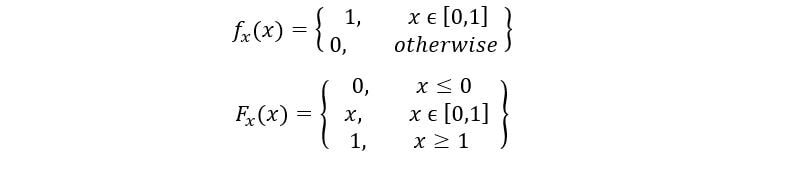
Usaremos essas informações e calcularemos X(1), X(3) & X(5) usando as fórmulas que derivamos. Tomaremos o caso apenas quando x estiver entre 0 e 1 (para outros casos, a estatística do pedido é zero, pois o PDF é zero).
UMA) Para 1S t estatísticas de pedidos:
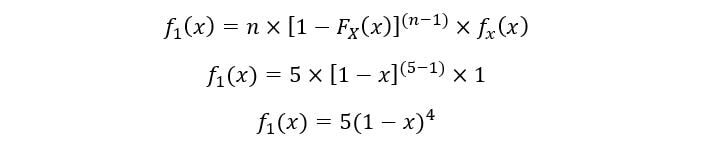
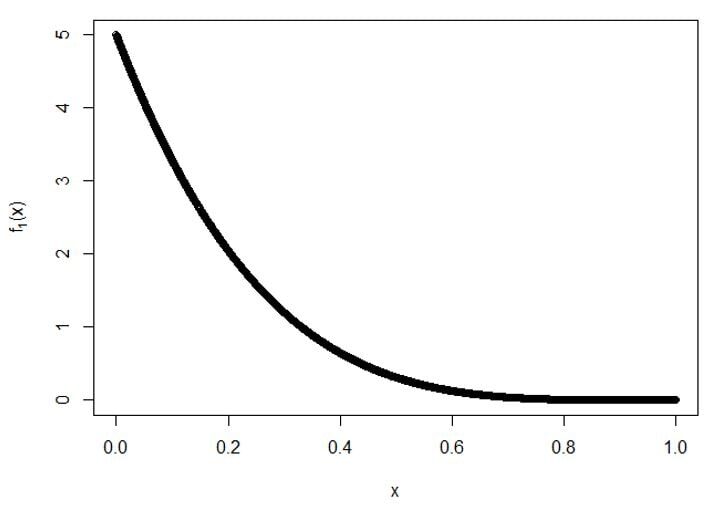
Traçar para f1(X):
B) Para 3rd estatísticas de pedidos:
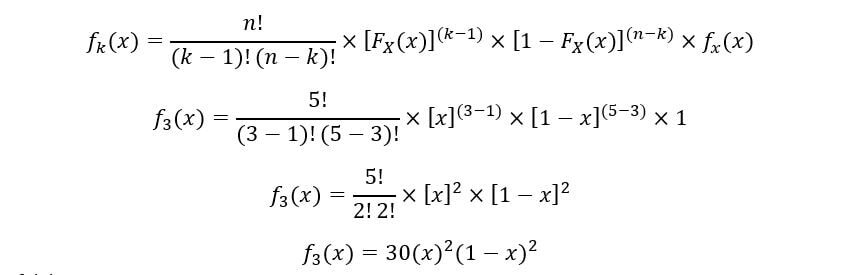
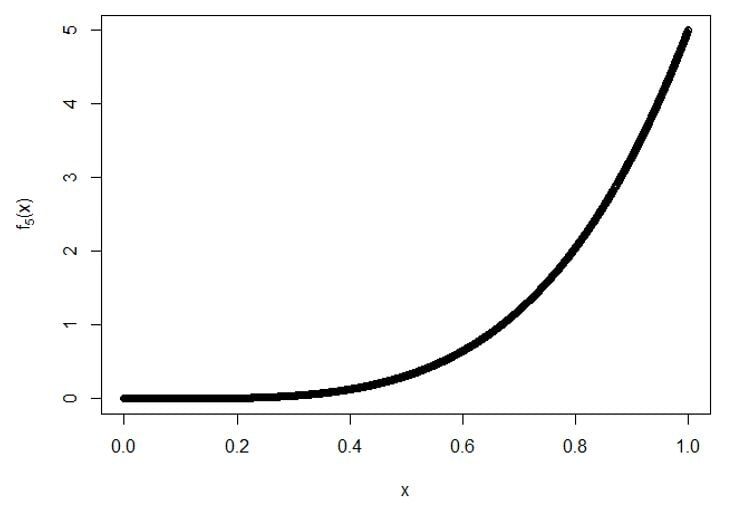
Traçar para f5(X):
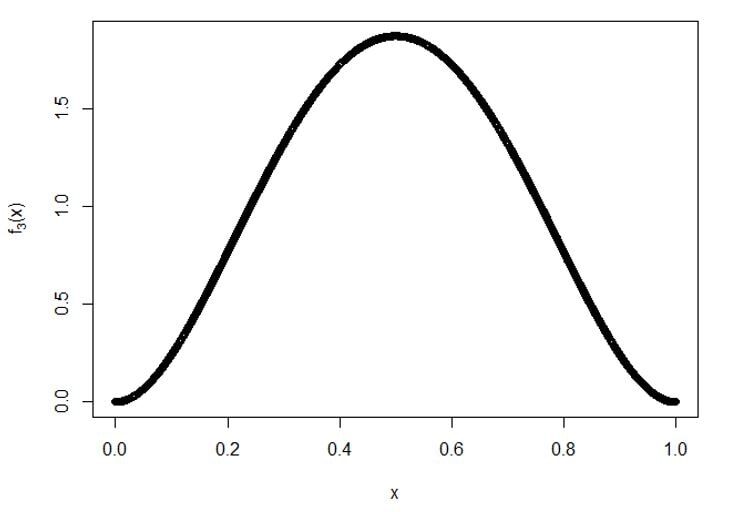
C) Para 5º estatísticas de pedidos:
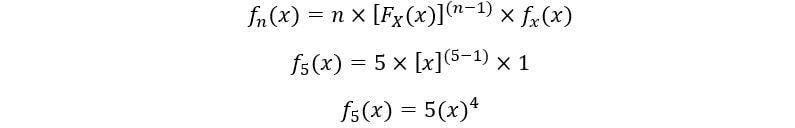
Traçar para f5(X):
conclusão
Portanto, exploramos os conceitos de estatística de pedidos em profundidade. Uma ampla gama de processos físicos pode ser modelada por meio de estatísticas de pedidos, explorando suas propriedades, particularmente suas distribuições.
A mídia mostrada neste artigo não é propriedade da DataPeaker e é usada a critério do autor.





