
Quando o dia estava chegando ao fim, Eu pensei em me encaixar em outra reunião. Dois analistas de minha equipe estavam trabalhando para criar um conjunto de dados para um dos modelos preditivos que queríamos construir.. Experiência de trabalho combinada (em modelos preditivos) entre analistas foi ~ 5 anos. Eu estava esperando passar pela reunião e sair para o dia.
Então, a reunião começou. Cinco minutos após a reunião e eu sabia que a reunião demoraria muito mais do que eu pensava inicialmente!!
O motivo? Vamos revisar a discussão como aconteceu:
Kunal: Quantas linhas você tem no conjunto de dados?
Analista 1: (Depois de revisar o conjunto de dados) X linhas
Kunal: Quantas linhas você está esperando?
Analista 1 e 2: Olhar vazio em seus rostos
Kunal: Quantos eventos / pontos de dados esperados no período / todo mês?
Analista 1 e 2: …. (Nenhum deles tinha a menor ideia)
O número de linhas no conjunto de dados parecia maior para mim. Os analistas claramente o negligenciaram, porque eles não compararam com as expectativas comerciais (ou eles não tinham isso em primeiro lugar). Ao aprofundar, descobrimos que alguns eventos tinham várias linhas nos conjuntos de dados e, por isso, um maior número de linhas.
Uma alta porcentagem de analistas teria passado por uma experiência semelhante em algum momento de sua carreira..
As vezes, seja devido a pressões da linha do tempo ou por algum outro motivo, esquecemos de fazer verificações básicas de sanidade no conjunto de dados em que estamos trabalhando. Apesar disto, ignorar a precisão dos dados nas fases iniciais do projeto pode ser muito caro e, por isso, em geral, é importante destacar ser paranóico em relação à precisão dos dados.
Em geral, Eu sigo uma estrutura simples para verificar a precisão dos pontos de dados. Neste post, Vou compartilhar o procedimento que costumo usar para verificar a integridade dos dados. O quadro vai de cima para baixo, o que se encaixa bem. Se você tiver erros óbvios em seus conjuntos de dados, será evidente no início do procedimento.
Observe que a postagem restante assume que você está trabalhando em um conjunto de dados estruturado. Para conjuntos de dados não estruturados, mesmo que os princípios ainda se apliquem, o procedimento mudaria.
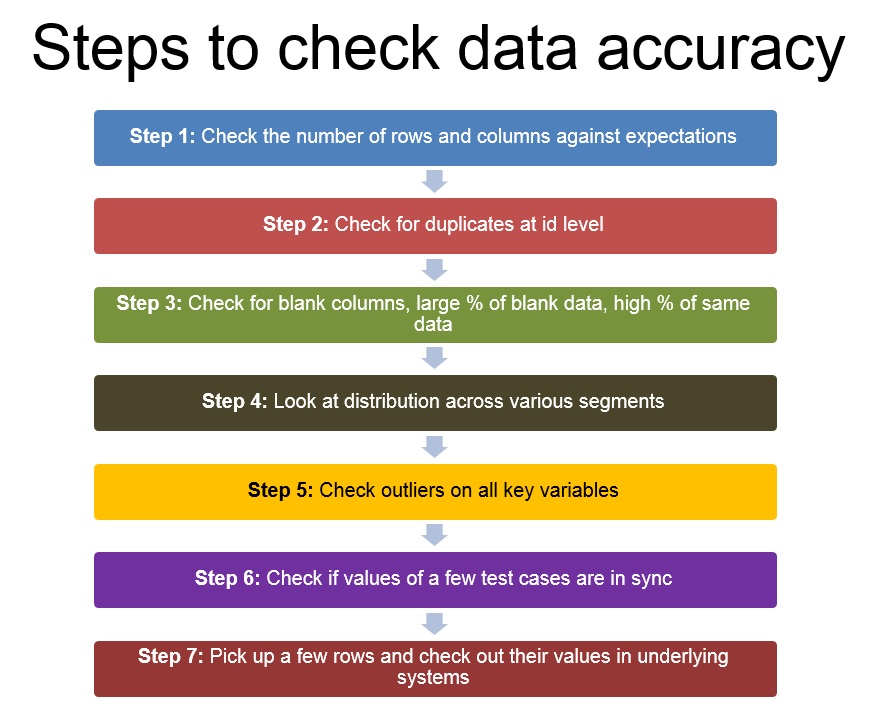
Paso 1: verifique o número de colunas e linhas com as expectativas
A primeira etapa assim que você obter qualquer conjunto de dados seria verificar se você tem todas as linhas e colunas necessárias. O número de colunas seria ditado pelo número de hipóteses que você tem e pelas variáveis que você precisaria testar / refutar essas hipóteses.
Por outro lado, o número de linhas seria ditado pelo número de eventos esperados no período selecionado. O benchmark mais simples seria baseado em seu entendimento de negócios.
Paso 2: Verifique se há duplicatas no nível de identificação (e não para toda a linha)
Depois de ter certeza de que todas as colunas estão presentes e o número de linhas parece dentro do intervalo esperado, verifique rapidamente se há duplicatas em seu nível de ID (ou o nível em que as linhas devem ser exclusivas; pode ser uma combinação de variáveis)
Paso 3: verifique se há colunas em branco, grande porcentagem de dados em branco, alta% dos mesmos dados
Agora que você sabe que todas as colunas estão lá e que não há duplicatas, procure colunas que estão completamente em branco. Isso pode acontecer no caso de falha de alguma junção ou no caso de haver algum erro na extração de dados. Se nenhuma das colunas estiver em branco, observe a% de casos em branco para cada coluna e as distribuições de frequência para descobrir se os mesmos dados se repetem em mais casos do que o esperado.
Paso 4: observar a distribuição em vários segmentos; verifique a compreensão do negócio e use tabelas dinâmicas
Esta etapa continua onde termina 3. Em vez de olhar para as frequências dos pontos de dados individualmente, olhe para suas distribuições. Você espera uma distribuição normal, bipolar o uniforme? O layout se parece com o que você esperava?
Paso 5. Verifique se há outliers em todas as variáveis-chave, especialmente aqueles calculados
Assim que as distribuições parecerem boas, procure por outliers. Especialmente nos casos em que você calculou colunas. Os valores do Extreme estão próximos do que você deseja?? Certifique-se de que não há divisões por zero, você limitou os valores que gostaria.
Paso 6: verifique se os valores de alguns casos de teste estão sincronizados
Depois de verificar todas as colunas individualmente, verifique se eles estão sincronizados um com o outro. Verifique se as diferentes datas dos casos estão em ordem cronológica (p. Não., Faça o equilíbrio, gastos e limite de crédito estão em sincronia entre si para seus clientes de cartão de crédito?
Paso 7: escolha algumas linhas e verifique seus valores nos sistemas subjacentes
Assim que todas as etapas acima forem realizadas, é hora de verificar alguns exemplos, consultando os sistemas ou bancos de dados subjacentes. Se houve algum erro nos dados, idealmente, eu já deveria tê-lo identificado. Esta etapa apenas garante que os dados estejam como estavam nos sistemas subjacentes.
Observe que alguns desses erros podem ser detectados por meio do uso de registros fornecidos por sua ferramenta. Analisar os registros de uma maneira geral fornece muitas informações sobre erros e avisos.
Estas foram as etapas que usei para verificar a precisão dos dados e, em geral, me ajude a detectar erros óbvios nos dados. Aparentemente, eles não são a solução para todos os erros possíveis, mas eles devem lhe dar um bom ponto de partida e uma boa direção. O que você acha deste quadro? Existem outras estruturas / métodos que você usa para verificar a precisão dos dados? Se então, adicione-os nos comentários abaixo.





