
Visão geral
- Familiarize-se com o Sistema de arquivos distribuídoUm sistema de arquivos distribuído (DFS) Permite armazenamento e acesso a dados em vários servidores, facilitando o gerenciamento de grandes volumes de informações. Esse tipo de sistema melhora a disponibilidade e a redundância, à medida que os arquivos são replicados para locais diferentes, Reduzindo o risco de perda de dados. O que mais, Permite que os usuários acessem arquivos de diferentes plataformas e dispositivos, promovendo colaboração e... o Hadoop (HDFSHDFS, o Sistema de Arquivos Distribuído Hadoop, É uma infraestrutura essencial para armazenar grandes volumes de dados. Projetado para ser executado em hardware comum, O HDFS permite a distribuição de dados em vários nós, garantindo alta disponibilidade e tolerância a falhas. Sua arquitetura é baseada em um modelo mestre-escravo, onde um nó mestre gerencia o sistema e os nós escravos armazenam os dados, facilitando o processamento eficiente de informações..)
- Compreender os componentes do HDFS
Introdução
Na atualidade, é comum lidar com quantidades massivas de dados. Desde a sua próxima mensagem de WhatsApp até ao seu próximo Tweet, está a criar dados a cada passo ao interagir com a tecnologia. Agora multiplique isso por 4.5 mil milhões de pessoas na Internet: a matemática é simplesmente alucinante!
Mas, alguma vez se perguntou como gerir esses dados? Está armazenado numa única máquina? E se a máquina avariar? Perderá os seus adoráveis tweets de 3 SOU * tos *?
A resposta é Não. Estou bastante certo de que já está a pensar no Hadoop. O Hadoop é um framework incrível. Com o Hadoop ao seu lado, pode aproveitar os poderes incríveis do Sistema de Ficheiros Distribuído do Hadoop (HDFS), o componente de armazenamento do Hadoop. Provavelmente é o componente mais importante do Hadoop e exige uma explicação detalhada.
Então, neste artigo, iremos aprender o que realmente é o Sistema de Ficheiros Distribuído do Hadoop (HDFS) e os seus diversos componentes. O que mais, veremos o que faz o HDFS funcionar, isso é o que o torna tão especial. Vamos descobrir!
Tabela de conteúdo
- O que é o sistema de ficheiros distribuído do Hadoop (HDFS)?
- Quais são os componentes do HDFS?
- Blocos no HDFS?
- NamenodeEl NameNode es un componente fundamental del sistema de archivos distribuido Hadoop (HDFS). Su función principal es gestionar y almacenar la metadata de los archivos, como su ubicación en el clúster y el tamaño. O que mais, coordina el acceso a los datos y asegura la integridad del sistema. Sin el NameNode, el funcionamiento de HDFS se vería gravemente afetado, uma vez que atua como o mestre na arquitetura de armazenamento distribuído.... no HDFS
- Nós de dados no HDFS
- NodoO Nodo é uma plataforma digital que facilita a conexão entre profissionais e empresas em busca de talentos. Através de um sistema intuitivo, permite que os usuários criem perfis, Compartilhar experiências e acessar oportunidades de trabalho. Seu foco em colaboração e networking torna o Nodo uma ferramenta valiosa para quem deseja expandir sua rede profissional e encontrar projetos que se alinhem com suas habilidades e objetivos.... Secundário no HDFS
- Gestão da replicação
- ReplicaçãoA replicação é um processo fundamental na biologia e na ciência, que se refere à duplicação de moléculas, células ou informações genéticas. No contexto do DNA, A replicação garante que cada célula-filha receba uma cópia completa do material genético durante a divisão celular. Esse mecanismo é crucial para o crescimento, Desenvolvimento e manutenção dos organismos, bem como para a transmissão de características hereditárias nas gerações futuras.... de blocos
- O que é um rack no Hadoop?
- Consciência de rack
O que é o sistema de ficheiros distribuído do Hadoop (HDFS)?
É difícil manter grandes volumes de dados numa única máquina. Portanto, é necessário dividir os dados em fragmentos menores e armazená-los em várias máquinas.
Os sistemas de ficheiros que gerem o armazenamento numa rede de máquinas são chamados sistemas de ficheiros distribuídos.
O sistema de ficheiros distribuído do Hadoop (HDFS) é o componente de armazenamento do Hadoop. Todos os dados armazenados no Hadoop são armazenados de forma distribuída num conjunto de máquinas. Mas tem algumas propriedades que definem a sua existência.
- Volumes enormes – Por ser um sistema de ficheiros distribuído, é altamente capaz de armazenar petabytes de dados sem qualquer problema técnico.
- Acesso aos dados – Baseia-se na filosofia de que 'o padrão de processamento de dados mais eficaz é escrever uma vez e ler muitas vezes'.
- Económico – O HDFS funciona num conjunto de hardware básico. Estas são máquinas económicas que se podem adquirir a qualquer fornecedor.
Quais são os componentes do sistema de ficheiros distribuído do Hadoop (HDFS)?
O HDFS tem dois componentes principais, em termos gerais: blocos de dados e nós que armazenam esses blocos de dados. Mas há mais do que parece. Então, vamos ver isso um por um para compreender melhor.
Blocos HDFS
O HDFS divide um ficheiro em unidades mais pequenas. Cada uma destas unidades é armazenada em diferentes máquinas do cachoUm cluster é um conjunto de empresas e organizações interconectadas que operam no mesmo setor ou área geográfica, e que colaboram para melhorar sua competitividade. Esses agrupamentos permitem o compartilhamento de recursos, Conhecimentos e tecnologias, Promover a inovação e o crescimento económico. Os clusters podem abranger uma variedade de setores, Da tecnologia à agricultura, e são fundamentais para o desenvolvimento regional e a criação de empregos..... Porém, isto é transparente para o utilizador que trabalha com o HDFS. Para eles, parece armazenar todos os dados numa única máquina.
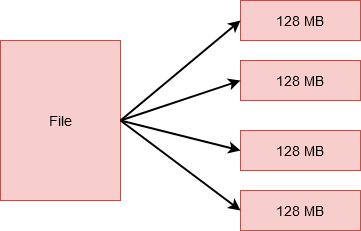
Estas unidades mais pequenas são as bloques no HDFS. O tamanho de cada um destes blocos é de 128 MB por padrão, pode alterá-lo facilmente conforme os requisitos. Portanto, se eu tivesse um ficheiro de 512 MB, seria dividido em 4 blocos que armazenam 128 MB cada um.
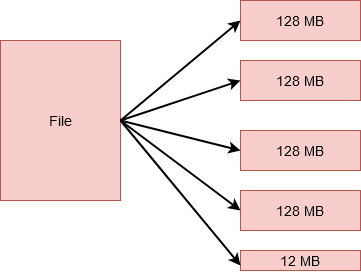
Porém, se eu tivesse um ficheiro de 524 MB de tamanho, seria dividido em 5 bloques. 4 destes armazenariam 128 MB cada um, o que equivale a 512 MB. E o quinto armazenaria os 12 MB restantes. Está certo! Este último bloco não ocupará os 128 MB completos do disco.
Mas, você deve se perguntar, por que uma quantidade tão grande num só bloco? Por que não vários blocos de 10 KB cada um? Nós vamos, a quantidade de dados com que geralmente lidamos no Hadoop costuma ser da ordem de petabytes ou mais.
Por tanto, se criássemos blocos de tamanho pequeno, acabávamos com uma quantidade colossal de blocos. Isto significaria que teríamos de lidar com metadados igualmente grandes em relação à localização dos blocos, o que geraria muita sobrecarga. E realmente não queremos isso!
Existem várias vantagens em armazenar dados em blocos em vez de guardar o ficheiro completo.
- O ficheiro em si seria demasiado grande para ser armazenado num único disco. Portanto, É sensato distribuí-lo por diferentes máquinas do cluster.
- Também permitiria uma distribuição adequada da carga de trabalho e evitaria o estrangulamento de uma única máquina ao aproveitar o paralelismo.
Agora, você deve se perguntar, O que acontece com as máquinas no cluster? Como armazenam os blocos e onde os metadados são armazenados? Vamos descobrir.
Namenode no HDFS
O HDFS opera numa arquitetura mestre-trabalhador, isto significa que há um nó mestreo "nó mestre" é um componente chave em redes de computadores e sistemas distribuídos. É responsável por gerir e coordenar as operações de outros nós, assegurando uma comunicação eficiente e o fluxo de dados. A sua função principal inclui a tomada de decisões, a atribuição de recursos e a supervisão do desempenho do sistema. A correta implementação de um nó mestre é fundamental para otimizar o funcionamento geral da rede.... e vários nós trabalhadores no cluster. O nó mestre é o Namenode.
Namenode es el nodo principal que se ejecuta en un nodo independiente del clúster.
- Administra el espacio de nombres del sistema de archivos, que es el árbol del sistema de archivos o la jerarquía de los archivos y directorios.
- Almacena información como propietarios de archivos, permisos de archivos, etc. para todos los archivos.
- También conoce la ubicación de todos los bloques de un archivo y su tamaño.
Toda esta información se mantiene de forma persistente en el disco local en forma de dos archivos: Fsimage e Editar registro.
- Fsimage almacena la información sobre los archivos y directorios en el sistema de archivos. Para los archivos, almacena el nivel de replicación, los tiempos de modificación y acceso, los permisos de acceso, los bloques que componen el archivo y sus tamaños. Para os diretórios, armazena a hora e as permissões de modificação.
- Editar registro por outro lado, realiza o acompanhamento de todas as operações de escrita realizadas pelo cliente. Isto é atualizado periodicamente nos metadados em memória para atender aos pedidos de leitura.
Sempre que um cliente desejar escrever informação no HDFS ou ler informação do HDFS, conecta-se com o Namenode. O Namenode devolve a localização dos blocos ao cliente e a operação é realizada.
sim, é certo, O Namenode não armazena os blocos. Para isso, Temos nós separados.
Nós de dados no HDFS
Nós de dados são os nós de trabalho. São hardware básico de baixo custo que pode ser facilmente adicionado ao cluster.
Nós de dados são responsáveis por armazenar, recuperar, replicar, retirar, etc. os blocos quando solicitado pelo Namenode.
Periodicamente enviam batimentos ao Namenode para que ele esteja ciente da sua saúde. Com isso, uma Nó de dadosDataNode é um componente chave em arquiteturas de big data, utilizado para armazenar e gerir grandes volumes de informação. A sua função principal é facilitar o acesso e a manipulação de dados distribuídos em clusters. Através do seu design escalável, DataNode permite às organizações otimizar o desempenho, melhorar a eficiência no processamento de dados e garantir a disponibilidade da informação em tempo real.... também envia uma lista de blocos que estão armazenados nele para que o Namenode possa manter a atribuição de blocos aos Datanodes na sua memória.
Mas além destes dois tipos de nós no cluster, também existe outro nó chamado nó de nome secundário. Vamos ver o que é isso.
Nó de nome secundário no HDFS
Suponha que precisamos reiniciar o Namenode, o que pode acontecer em caso de falha. Isto significaria que teríamos que copiar a Fsimage do disco para a memória. O que mais, também teríamos que copiar a última cópia do Edit Log na Fsimage para acompanhar todas as transações. Mas se reiniciarmos o nó após muito tempo, então o registo de edição poderia ter aumentado de tamanho. Isto significaria que levaria muito tempo aplicar as transações do registo de edição. E durante esse tempo, o sistema de ficheiros estaria offline. Portanto, para resolver este problema, trazemos o nó de nome secundário.
nó de nome secundário é outro nó presente no cluster cuja função principal é fundir regularmente o registo de edição com a Fsimage e produzir pontos de verificação dos metadados do sistema de ficheiros na memória do primário. Isto também é conhecido como Checkpointing.
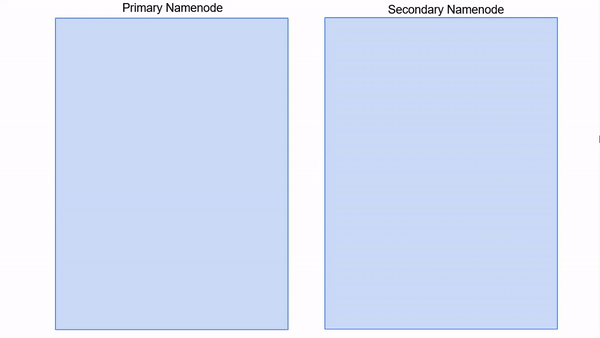
Mas o procedimento de pontos de verificação é computacionalmente muito custoso e requer muita memória, razão pela qual o nó de nome secundário é executado num nó separado do cluster.
Porém, apesar do seu nome, el Namenode secundario no actúa como un Namenode. Simplemente está ahí para hacer Checkpointing y mantener una copia de la última Fsimage.
Gestión de la replicación en HDFS
Agora, una de las mejores características de HDFS es la replicación de bloques, lo que lo hace muy confiable. Mas, ¿cómo replica los bloques y dónde los almacena? Respondamos esas preguntas ahora.
Replicación de bloques
HDFS es un componente de almacenamiento confiable de Hadoop. Esto se debe a que cada bloque almacenado en el sistema de archivos se replica en diferentes nodos de datos del clúster. Esto hace que HDFS sea tolerante a errores.
El fator de replicación predeterminado en HDFS es 3. Esto significa que cada bloque tendrá dos copias más, cada uma armazenada em DataNodes separados no cluster. Porém, este número é configurável.
Mas deve estar a perguntar-se, não significa isso que estamos a utilizar demasiado espaço de armazenamento? Por exemplo, sim, temos 5 blocos de 128 MB cada um, isso equivale a 5 * 128 * 3 = 1920 MB. Verdade. Mas estes nós são hardware básico. Podemos escalar facilmente o cluster para adicionar mais destas máquinas. O custo de comprar máquinas é muito menor do que o custo de perder dados!
Agora, você deve se perguntar, como é que o Namenode decide em qual Datanode armazenar as réplicas? Nós vamos, antes de responder a essa pergunta, devemos dar uma olhada no que é um Rack no Hadoop.
O que é um rack no Hadoop?
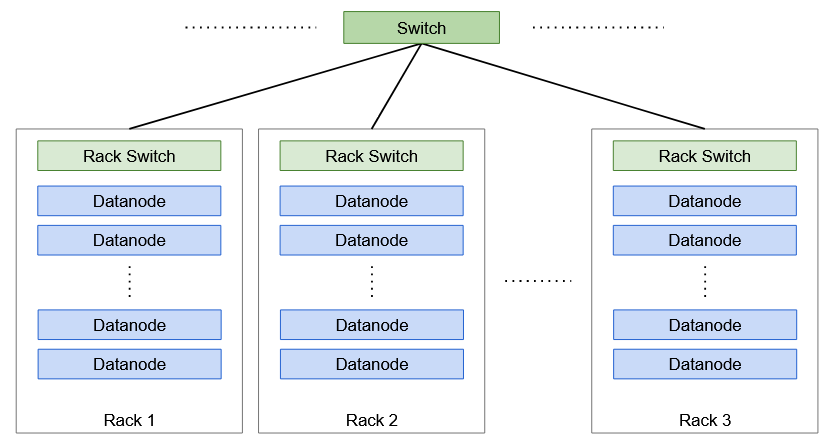
UMA Prateleira é uma coleção de máquinas (30-40 no Hadoop) que são armazenadas na mesma localização física. Há vários racks em um cluster de Hadoop, todos conectados através de comutadores.
Consciência de rack
O armazenamento de réplica é um compromisso entre fiabilidade e largura de banda de leitura / escrita. Para aumentar a fiabilidade, precisamos armazenar réplicas de blocos em diferentes racks e Datanodes para aumentar a tolerância a falhas. Enquanto a largura de banda de escrita é menor quando as réplicas são armazenadas no mesmo nodo. Portanto, O Hadoop tem uma estratégia predefinida para lidar com este dilema, também conhecido como Consciência de rack algoritmo.
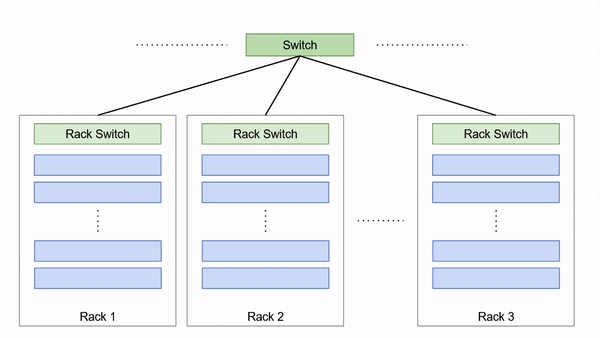
Por exemplo, se o fator de replicação de um bloco for 3, a primeira réplica é armazenada no mesmo Datanode onde o cliente escreve. A segunda réplica é armazenada num Datanode diferente mas num rack diferente, escolhido aleatoriamente. Enquanto a terceira réplica é armazenada no mesmo rack que a segunda, mas num Datanode diferente, novamente escolhido aleatoriamente. Porém, se o fator de replicação fosse maior, as réplicas seguintes seriam armazenadas em nodos de dados aleatórios no cluster.
Notas finais
Espero que já tenha um conhecimento sólido sobre o que é o sistema de ficheiros distribuído do Hadoop (HDFS), quais são os seus componentes importantes e como os dados são armazenados. Porém, ainda há alguns conceitos que precisamos cobrir em relação ao Sistema de Ficheiros Distribuído do Hadoop (HDFS), mas essa é uma história para outro artigo.
Por agora, recomendo que leia os seguintes artigos para compreender melhor o Hadoop e este mundo de Big Data.
Por último, mas não menos importante, recomendo a leitura Hadoop: o guia definitivo de Tom White. Este artigo foi muito inspirado por ele.





