
Este artigo foi publicado como parte do Data Science Blogathon
Introdução
Se você está lendo este artigo, Acho que você já está no mundo da ciência de dados e tem uma ideia sobre aprendizado de máquina. Sim, não é assim, não há problema. Vou começar com as terminologias básicas que você precisa saber antes de entender o principal tópico de discussão, quer dizer, regressão linear.
Este artigo cobrirá tudo que você precisa saber sobre regressão linear., o primeiro algoritmo de aprendizado de máquina de ciência de dados.
Tabela de conteúdos
- Breve introdução ao aprendizado de máquina e seus tipos
- Compreendendo a regressão linear
- Suposições de regressão linear.
- Como lidar com a violação das premissas
- Métricas de avaliação para problemas de regressão
Introdução ao aprendizado de máquina
O aprendizado de máquina é um ramo da inteligência artificial (ELE) focado na construção de aplicativos que aprendem com os dados e melhoram a precisão ao longo do tempo, sem serem programados para isso.
Tipos de aprendizado de máquina:
Aprendizado de máquina supervisionado: É uma técnica de ML em que os modelos são treinados com dados rotulados, quer dizer, Um variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos.... de saída neste tipo de problema. Aqui, modelos encontram função de mapeamento para mapear variáveis de entrada para variáveis de saída ou rótulos.
Regressão e classificação Os problemas fazem parte do aprendizado de máquina supervisionado.
Aprendizado de máquina não supervisionado: É a técnica em que os modelos não recebem os dados rotulados e têm que encontrar os padrões e a estrutura dos dados para conhecer os dados.
Agrupamento e associação Algoritmos fazem parte do ML não supervisionado.
Compreendendo a regressão linear
Nas palavras mais simples Regressão linear é o modelo de aprendizado de máquina supervisionado em que o modelo encontra a linha linear de melhor ajuste entre a variável independente e dependente quer dizer, encontre a relação linear entre as variáveis dependentes e independentes.
A regressão linear é de dois tipos: Simples e múltiplo. Regressão linear simples é onde apenas uma variável independente está presente e o modelo tem que encontrar sua relação linear com a variável dependente
Enquanto em Regressão linear múltipla há mais de uma variável independente para o modelo encontrar a relação.
Equação de regressão linear simples, onde bo é o cruzamento, b1 é coeficiente ou inclinação, x é a variável independente ey é a variável dependente.
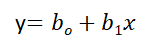

Equação de regressão linear múltipla, onde bo é o cruzamento, b1,B2,B3,B4…,BNorte são coeficientes ou inclinações das variáveis independentes x1,X2,X3,X4…,XNorte e y é a variável dependente.
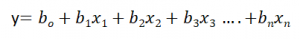

O objetivo principal de um modelo de regressão linear é encontrar a linha linear que melhor se ajusta e os valores ótimos de interseção e coeficientes de uma forma que minimize o erro.
O erro é a diferença entre o valor real e o valor previsto e o objetivo é reduzir essa diferença.
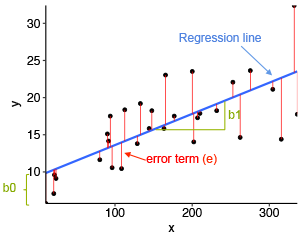
Vamos entender isso com a ajuda de um diagrama.
Fonte da imagem: ferramentas estatísticas para análise de dados de alto desempenho
No diagrama acima,
- x é a nossa variável dependente que é plotada no eixo x ey é a variável dependente que é plotada no eixo y.
- Os pontos pretos são os pontos de dados, quer dizer, os valores reais.
- Bo é a interseção que é 10 e B1 é a inclinação da variável x.
- A linha azul é a linha de melhor ajuste prevista pelo modelo, quer dizer, os valores previstos estão na linha azul.
A distância vertical entre o ponto de dados e a linha de regressão é conhecida como o erro ou residual. Cada ponto de dados tem um resto e a soma de todas as diferenças é conhecida como a soma dos residuais / erros.
Abordagem matemática:
Residual / Erro = valores reais – Valores preditos
Soma dos residuais / erros = soma (valores reais esperados)
Quadrado da soma dos resíduos / erros = (Soma (valores reais esperados))2
quer dizer
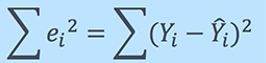
Para uma compreensão profunda da matemática por trás da regressão linear, ver anexo explicação de vídeo.
Suposições de regressão linear
Os pressupostos básicos da regressão linear são os seguintes:
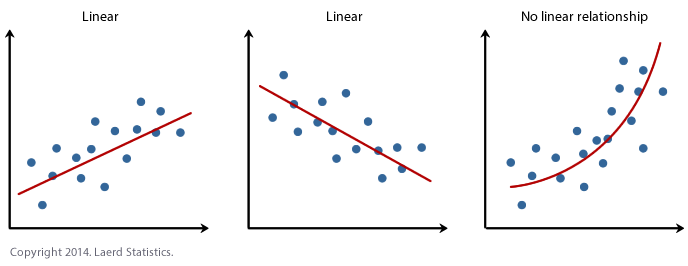
1. Linearidade: Estabelece que a variável dependente Y deve estar linearmente relacionada às variáveis independentes. Esta suposição pode ser verificada desenhando um diagrama de dispersão entre ambas as variáveis.
2. Normal: As variáveis X e Y devem ter uma distribuição normal. Histogramas podem ser usados, Gráficos KDE e gráficos QQ para verificar a suposição de normalidade.
Veja meu blog em anexo para uma explicação detalhada sobre como verificar a normalidade e transformar variáveis que violam a suposição.
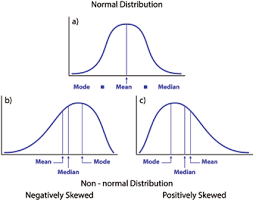
Fonte: https://heljves.com/gallery/vol_1_issue_1_2019_8.pdf
3. Homocedasticidade: A variação dos termos de erro deve ser constante, quer dizer, a dispersão dos resíduos deve ser constante para todos os valores de X. Esta suposição pode ser verificada desenhando um gráfico residual. Se a suposição for violada, os pontos formarão um funil, caso contrário, eles serão constantes.
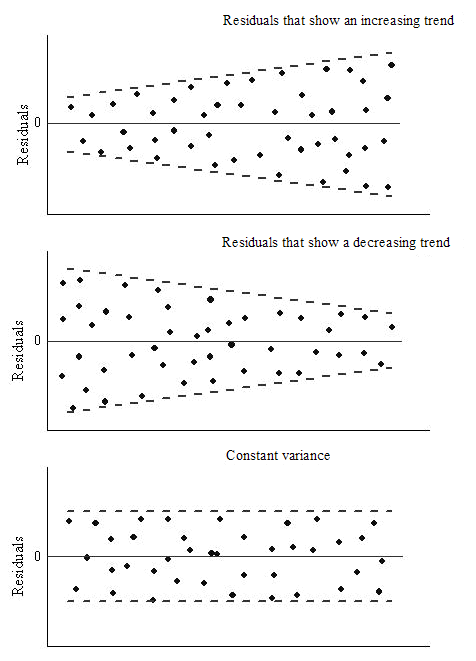
Fonte: OriginLab
4. Independência / Sem multicolinearidade: As variáveis devem ser independentes umas das outras, quer dizer, não deve haver correlação entre as variáveis independentes. Para verificar a suposição, podemos usar uma matriz de correlação ou uma pontuação VIF. Se a pontuação VIF for maior que 5, as variáveis são altamente correlacionadas.
Na imagem abaixo, existe uma alta correlação entre as variáveis x5 e x6.
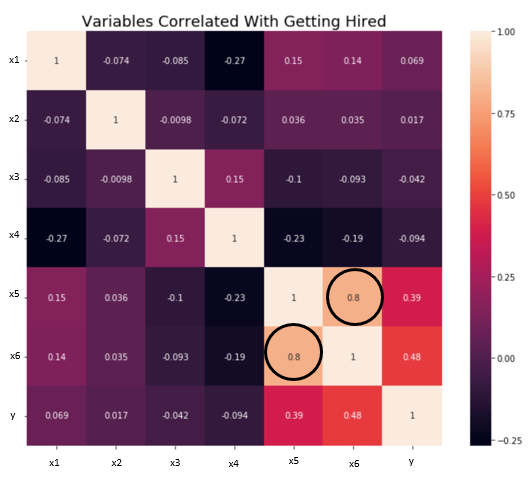
Fonte: em direção à ciência de dados
5. a os termos de erro devem ser distribuídos normalmente. Gráficos QQ e histogramas podem ser usados para verificar a distribuição de termos de erro.
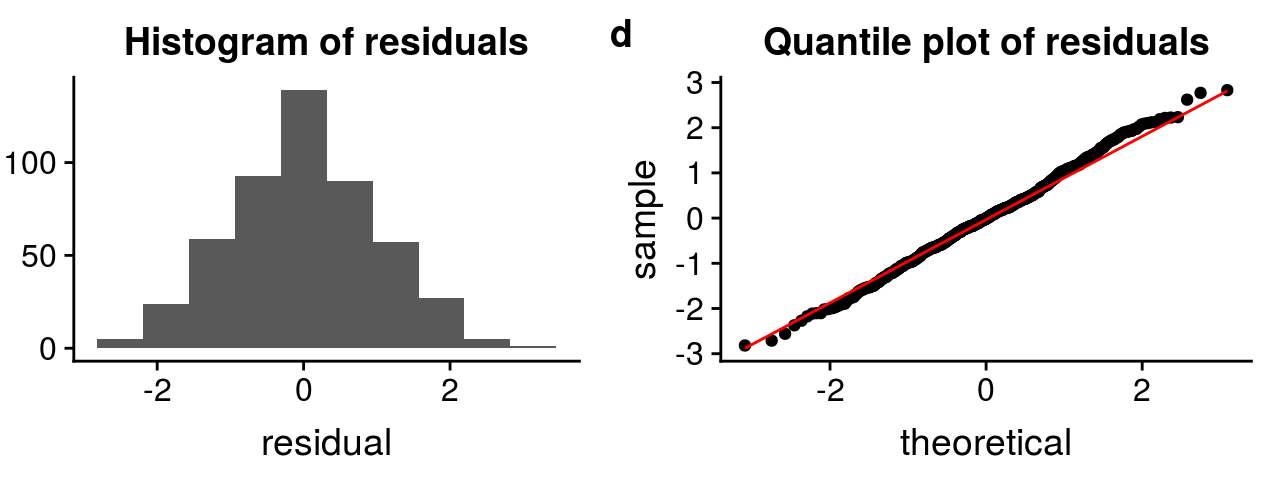
Fonte: http://rstudio-pubs-static.s3.amazonaws.com
6. Sem autocorrelação: Os termos de erro devem ser independentes uns dos outros. A autocorrelação pode ser testada usando o teste Durbin Watson. A hipótese nula assume que não há autocorrelação. O valor do teste está entre 0 e 4. Se o valor do teste for 2, sem autocorrelação.
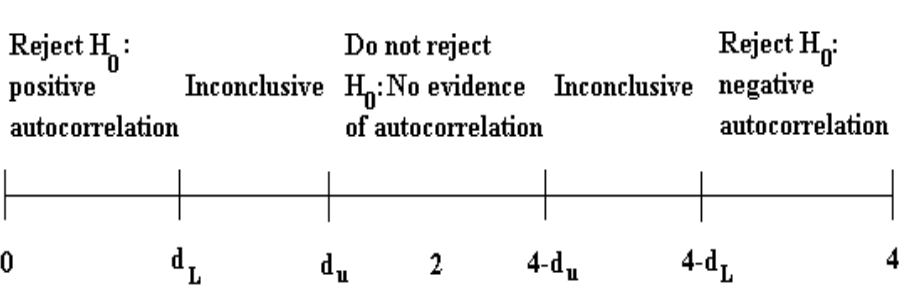
Fonte: itfeature.com
Como lidar com a violação de qualquer uma das premissas
A violação das premissas leva a uma diminuição na precisão do modelo, então as previsões não são precisas e o erro também é alto.
Por exemplo, se o pressuposto de independência for violado, a relação entre a variável independente e dependente não pode ser determinada com precisão.
Existem vários métodos e técnicas disponíveis para lidar com a violação das premissas. Vamos analisar alguns deles abaixo.
Violação da suposição de normalidade das variáveis ou termos de erro
Para tratar este problema, podemos transformar as variáveis para a distribuição normal usando várias funções de transformação como transformação logarítmica, Transformação Recíproca Box-Cox.
Todas as funções são discutidas neste meu artigo: Como transformar para distribuição normal
Violação do pressuposto de multicolinearidade
Pode ser tratado por:
- Não fazer nada (se não houver grande diferença na precisão)
- Eliminando algumas das variáveis independentes altamente correlacionadas.
- Derive uma nova característica combinando linearmente as variáveis independentes, como adicioná-los ou realizar alguma operação matemática.
- Realizando uma análise projetada para variáveis altamente correlacionadas, como a análise de componentes principais.
Métricas de avaliação para análise de regressão
Para entender o desempenho do modelo de regressão, uma avaliação do modelo é necessária. Algumas das métricas de avaliação usadas para análise de regressão são:
1. R ao quadrado ou coeficiente de determinação: A métrica mais usada para avaliação de modelo em análise de regressão é R ao quadrado. Pode ser definido como uma razão de variação para variação total. O valor de R ao quadrado está entre 0 e 1, quanto mais perto de 1, melhor o modelo.
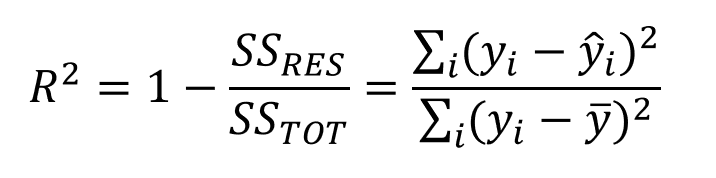
Fonte: medium.datadriveninvestor.com
onde SSRES é a soma residual dos quadrados e SSTOT é a soma total dos quadrados
2. R quadrado ajustado: É a melhoria de R ao quadrado. O problema / desvantagem do R2 é que conforme os recursos aumentam, o valor de R2 também aumenta, o que dá a ilusão de um bom modelo. Então, R2 ajustado resolve o problema de R2. Ele considera apenas os recursos que são importantes para o modelo e mostra a melhoria real do modelo.
R2 ajustado é sempre menor que R2.
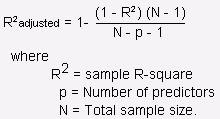
Fonte: stats.stackexchange.com
3. Raiz do erro quadrático médio (MSE): Outra métrica comum para avaliação é a raiz do erro quadrático médio., que é a média da diferença quadrática dos valores reais versus os previstos.
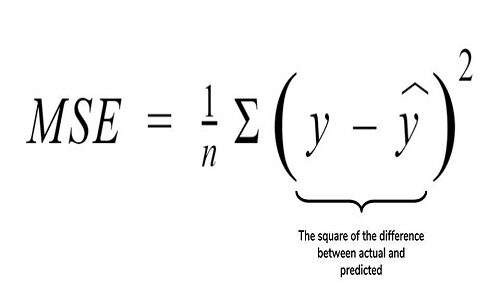
Fonte: cppsecrets.com
4. Raiz do erro quadrático médio (RMSE): É a raiz do MSE, quer dizer, a raiz da diferença média dos valores reais e previstos. RMSE penaliza grandes erros, enquanto MSE não.
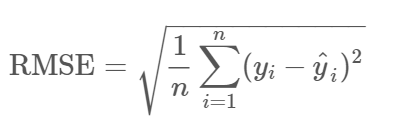
Fonte: community.qlik.com
Notas finais
Cobrimos a maioria dos conceitos de modelo de regressão neste blog. Se você quiser explorar mais sobre a matemática por trás do modelo, veja os links anexados ao blog.
Por favor, sinta-se à vontade para se conectar comigo no LinkedIn e compartilhe sua valiosa contribuição. Por favor, verifique meus outros artigos aqui.
Sobre o autor :
Soy Deepanshi Dhingra, Atualmente trabalho como pesquisador de ciência de dados e tenho formação em análise, Análise exploratória de dados, aprendizado de máquina e aprendizado profundoAqui está o caminho de aprendizado para dominar o aprendizado profundo em, Uma subdisciplina da inteligência artificial, depende de redes neurais artificiais para analisar e processar grandes volumes de dados. Essa técnica permite que as máquinas aprendam padrões e executem tarefas complexas, como reconhecimento de fala e visão computacional. Sua capacidade de melhorar continuamente à medida que mais dados são fornecidos a ele o torna uma ferramenta fundamental em vários setores, da saúde....
Este artigo foi publicado como parte do Data Science Blogathon





