
Este artigo foi publicado como parte do Data Science Blogathon.
Introdução
como reabilitar pessoas por meio do uso de dados e informações relevantes.
Neste projeto, vamos prever os sentimentos dos tweets do COVID-19. Os dados coletados do Tweeter e vou usar o ambiente Python para implementar este projeto.
Exposição do problema
O desafio apresentado é construir um modelo de classificação para prever o sentimento dos tweets da Covid-19.. Os tweets foram extraídos do Twitter e a marcação manual foi realizada. Recebemos informações como Localização, Tuitear en, Tuíte original e sentimento.
Abordagem para analisar vários sentimentos
Antes de continuar, é útil saber o que se entende por análise de sentimento. A análise de sentimento é o processo de identificar e categorizar computacionalmente as opiniões expressas em um texto, especialmente para determinar se a atitude do escritor em relação a um determinado tópico é positiva, Negativa o Neutral. (dicionário de Oxford)
Abaixo está o procedimento operacional padrão para abordar o tipo de projeto de análise de sentimento. Vamos passar por este procedimento para prever o que devemos prever!!
-
Análise exploratória de dados.
-
Pré-processamento de dados.
-
Vetorização.
-
Modelos de classificação.
-
Avaliação.
-
conclusão.
Vamos adivinhar alguns tweets
Vou ler o tweet e você pode me dizer qual é o sentimento desse tweet se for positivo, negativo o neutral? Então, o primeiro tweet é “Ainda me surpreende quantos funcionários do supermercado #Toronto trabalham sem algum tipo de máscara. Todos nós sabemos agora que os funcionários podem ser assintomáticos enquanto transmitem #coronavírus ”. Qual é o seu palpite? sim, tem razão. Este é um tweet negativo porque contém palavras negativas como “Surpreso”.
Se você não consegue adivinhar o tweet acima, não se preocupe, Eu tenho outro tweet para você. Vamos adivinhar este tweet-"Devido à situação da Covid-19, aumentamos a demanda por todos os produtos alimentícios. O tempo de processamento pode ser maior para todos os pedidos online, especialmente os pacotes de freezer e compartilhamento de carne bovina. Agradecemos sua paciência durante esse tempo. ". Desta vez, você está absolutamente correto em prever este tweet como “Positivo”. Palavras como “Obrigado”, “Maior demanda” são otimistas por natureza, então essas palavras categorizaram o tweet como positivo.
Resumo de dados
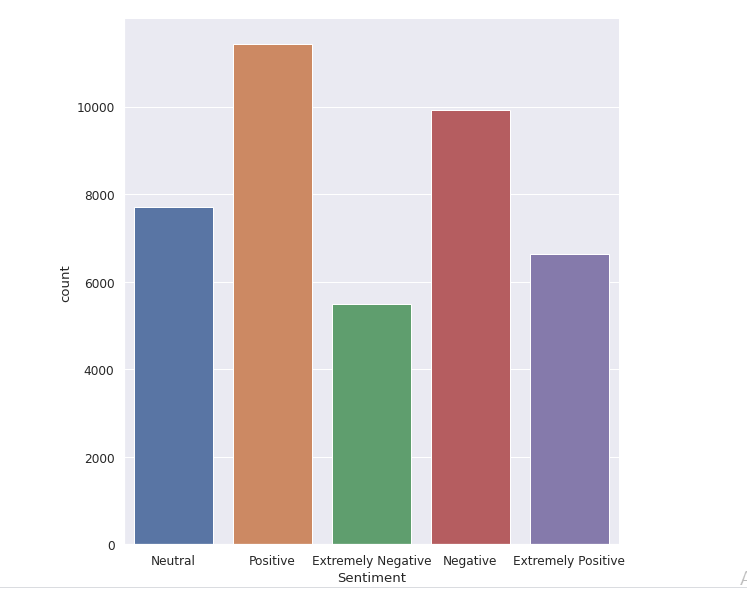
O conjunto de dados original tem 6 colunas e 41157 filas. Para analisar vários sentimentos, precisamos apenas de duas colunas chamadas Original Tweet e Sentiment. Existem cinco tipos de sentimentos: Extremamente negativo, negativo, neutro, positivo e extremamente positivo como você pode ver na imagem a seguir.
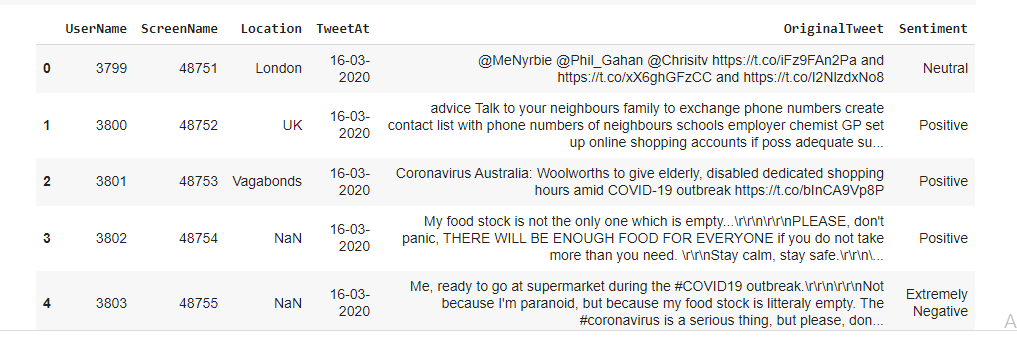
Resumo do conjunto de dados
Análise exploratória básica de dados
Colunas como “Nome de usuário” e “Nome do ecrã“Eles não fornecem informações significativas para nossa análise. Portanto, não usamos essas funções para construção de modelo. Todos os dados de tweet coletados para os meses de março e abril 2020. O gráfico de barras a seguir nos mostra o número de valores únicos em cada coluna.
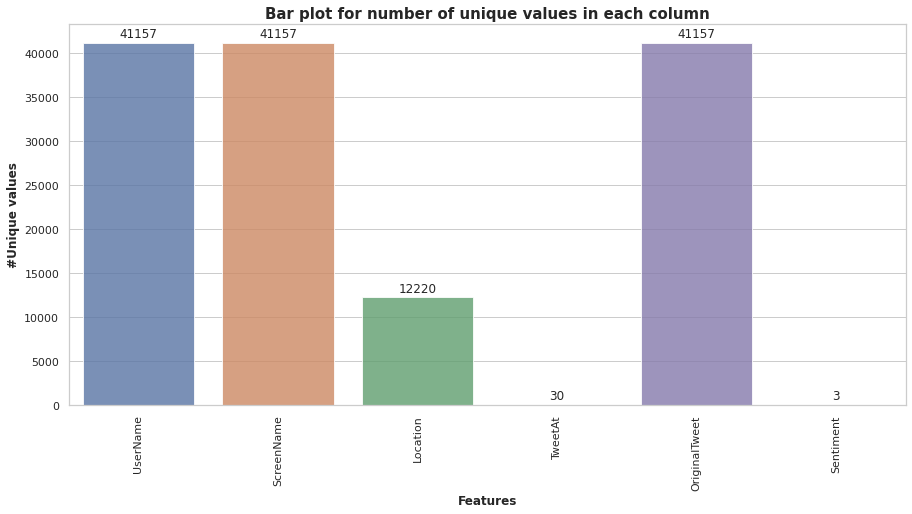
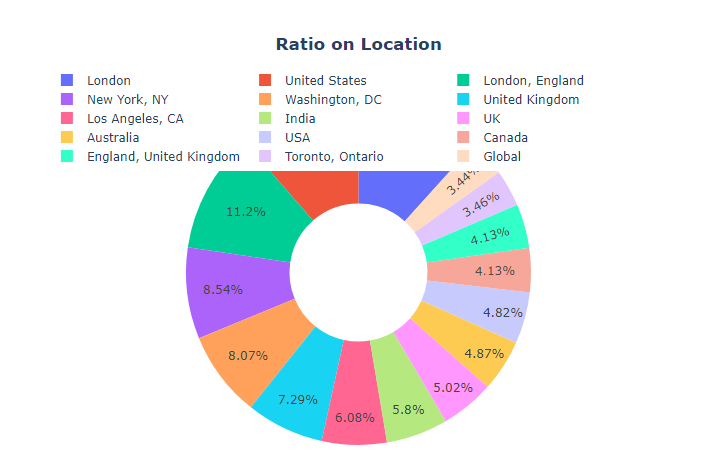
Existem alguns valores nulos na coluna de localização, mas não precisamos cuidar deles, uma vez que usaremos apenas duas colunas, quer dizer, “Sentindo-me” e “Tweet original”. A maioria dos tweets veio de Londres (11,7%), como se desprende de la siguiente figura"Figura" é um termo usado em vários contextos, Da arte à anatomia. No campo artístico, refere-se à representação de formas humanas ou animais em esculturas e pinturas. Em anatomia, designa a forma e a estrutura do corpo. O que mais, em matemática, "figura" está relacionado a formas geométricas. Sua versatilidade o torna um conceito fundamental em várias disciplinas.....
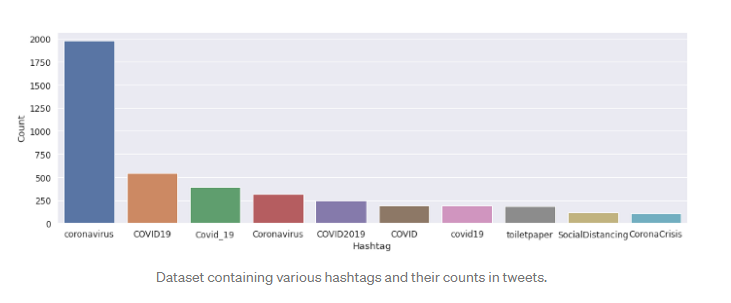
Existem algumas palavras como 'coronavírus', 'bomboneria', que têm a frequência máxima em nosso conjunto de dados. Podemos ver isso na seguinte nuvem de palavras. Existem várias #hashtags na coluna do tweet. Mas eles são quase os mesmos em todos os sentimentos, então eles não nos fornecem informações completas e significativas.
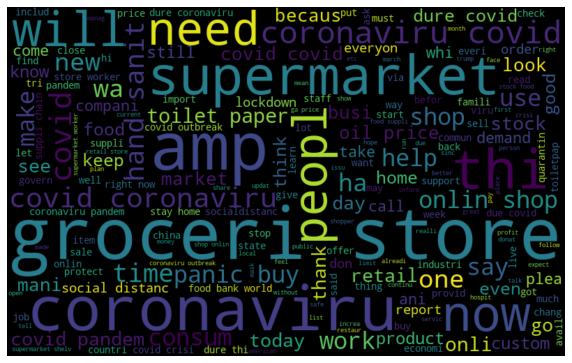
World Cloud mostrando as palavras com frequência máxima em nossa coluna Tweet
Quando tentamos explorar a coluna 'Sentimento', descobrimos que a maioria das pessoas tem sentimentos positivos sobre vários tópicos, o que nos mostra seu otimismo em tempos de pandemia. Muito poucas pessoas têm pensamentos extremamente negativos sobre a Covid-19.
Pré-processamento de dados
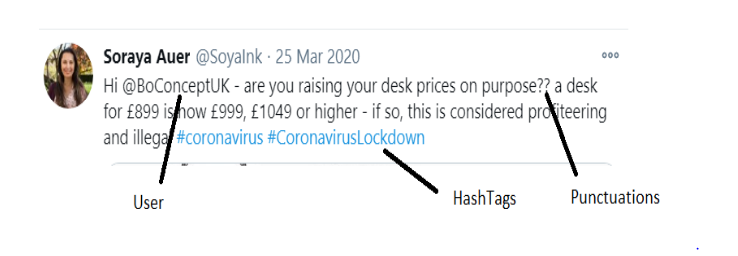
O pré-processamento de dados de texto é uma etapa essencial, pois torna o texto simples pronto para mineração. O objetivo desta etapa é limpar os ruídos menos relevantes para encontrar o sentimento de tweets como pontuação(.,?, ”Etc.), caracteres especiais(@,%, &, $, etc.), números(1,2,3, etc.), manga o tweeter, links(HTTPS: / HTTP:) e termos que não têm muito peso no contexto do texto.
O que mais, devemos remover palavras vazias dos tweets. Palavras irrelevantes são aquelas palavras de linguagem natural que têm muito pouco significado., O que “isto é”, “uma”, “a”, etc. Para remover palavras irrelevantes de uma frase, você pode quebrar o texto em palavras e, em seguida, excluir a palavra se ela existir na lista de palavras irrelevantes fornecida por NLTK.
Mais tarde, precisamos normalizar os tweets usando Stemming ou Lemmatization. “Stemming ”é um processo baseado em regras para remover sufixos (“Ing”,“Sim”," isto é ",“Ed”,“S”, etc.) de uma palavra. Por exemplo, “Toque”, “jogador”, “reproduziu”, “Toque” e “Toque” são as diferentes variações da palavra – “Toque”.
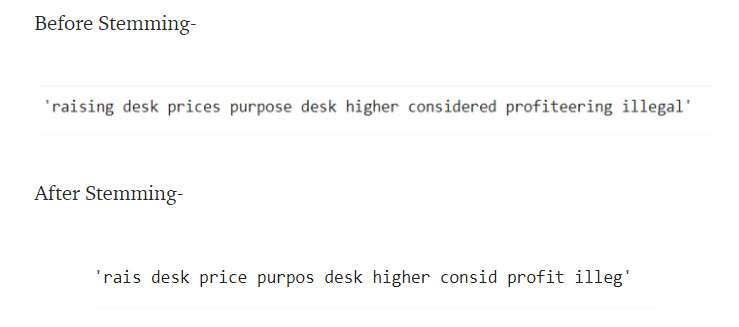
A derivação não converterá as palavras originais em palavras significativas. Como você pode ver, “considerado” é derivado em “condicional”, que não tem significado e também é um erro ortográfico. A melhor maneira é usar lematização em vez do processo de derivação.
O stemming é uma operação mais poderosa e leva em consideração a análise morfológica das palavras. Devolve o lema, que é a forma básica de todas as suas formas flexionais.
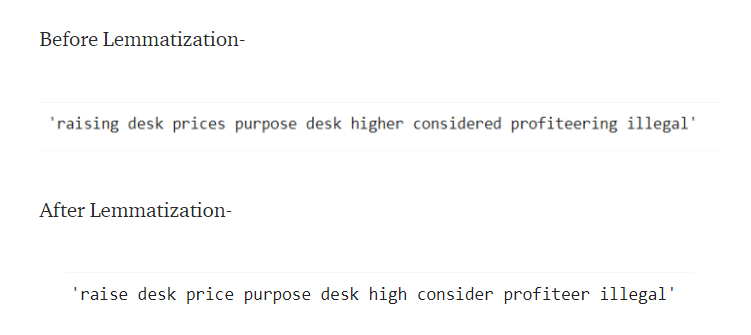
Aqui, no processo de lematização, estamos transformando a palavra “erguer” à sua forma básica “erguer”. También necesitamos convertir todos los tweets a minúsculas antes de realizar el proceso de padronizaçãoA padronização é um processo fundamental em várias disciplinas, que busca estabelecer padrões e critérios uniformes para melhorar a qualidade e a eficiência. Em contextos como engenharia, Educação e administração, A padronização facilita a comparação, Interoperabilidade e compreensão mútua. Ao implementar normas, a coesão é promovida e os recursos são otimizados, que contribui para o desenvolvimento sustentável e a melhoria contínua dos processos.....
Podemos incluir o processo de tokenização. Em tokenização, nós convertemos um grupo de frases em tokens. También se denomina O desempenho é exibido como gráficos de dispersão e caixaA segmentação é uma técnica de marketing chave que envolve a divisão de um mercado amplo em grupos menores e mais homogêneos. Essa prática permite que as empresas adaptem suas estratégias e mensagens às características específicas de cada segmento, melhorando assim a eficácia de suas campanhas. A segmentação pode ser baseada em critérios demográficos, psicográfico, geográfico ou comportamental, facilitando uma comunicação mais relevante e personalizada com o público-alvo.... de texto o análise léxico. Basicamente, trata-se de dividir os dados em um pequeno número de palavras. A tokenização em Python pode ser feita por Python NLTK função word_tokenize () da Biblioteca.
Vetorização
Podemos usar um vetorizador de contagem ou um vetorizador TF-IDF. O Count Vectorizer irácriar um array esparso de todas as palavras e o número de vezes que elas estão presentes em um documento.
TFIDF, abreviatura de termo frequência-frequência inversa do documento, é uma estatística numérica que tenta refletir a importância de uma palavra para um documento em uma coleção ou corpus. O valor TF - IDF aumenta proporcionalmente ao número de vezes que uma palavra aparece no documento e é compensado pelo número de documentos no corpus que contêm a palavra, o que ajuda a ajustar o fato de que algumas palavras aparecem com mais frequência em geral. (wiki)
Modelos de classificação de edifícios
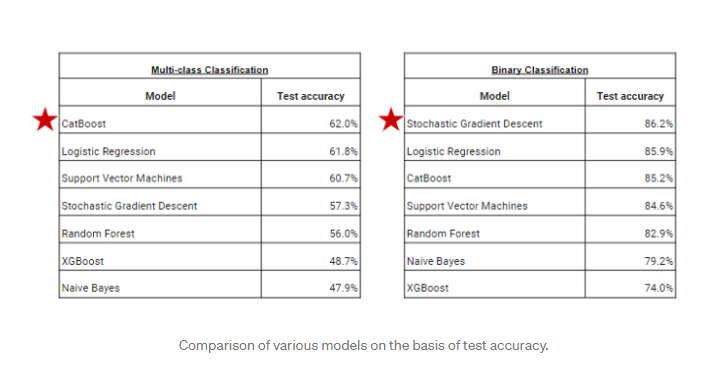
O problema dado é a classificação ordinal multiclasse. Existem cinco tipos de sentimentos, então temos que treinar nossos modelos para que eles possam nos dar o rótulo correto para o conjunto de dados de teste. Vou construir modelos diferentes como Bayes ingenuo, Regressão logística, floresta aleatória, XGBoost, apoiar máquinas de vetor, CatBoost y descenso de gradienteGradiente é um termo usado em vários campos, como matemática e ciência da computação, descrever uma variação contínua de valores. Na matemática, refere-se à taxa de variação de uma função, enquanto em design gráfico, Aplica-se à transição de cores. Esse conceito é essencial para entender fenômenos como otimização em algoritmos e representação visual de dados, permitindo uma melhor interpretação e análise em... estocástico.
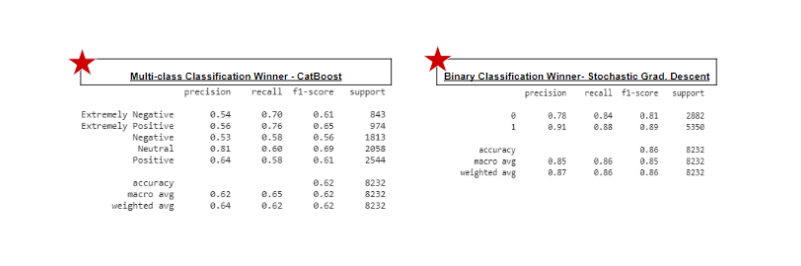
He usado el problema dado de Clasificación multiclase que es una variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos.... dependiente que tiene los valores -Positivo, Extremamente positivo, Neutro, Negativo, Extremamente negativo. Eu também converto este problema para uma classificação binária, quer dizer, Classifiquei todos os tweets em apenas dois tipos positivo e negativo. Você também pode optar pela classificação de três classes, quer dizer, Positivo, Negativo e neutro para maior precisão. Na fase de avaliação, vamos comparar os resultados desses algoritmos.
Importância do recurso
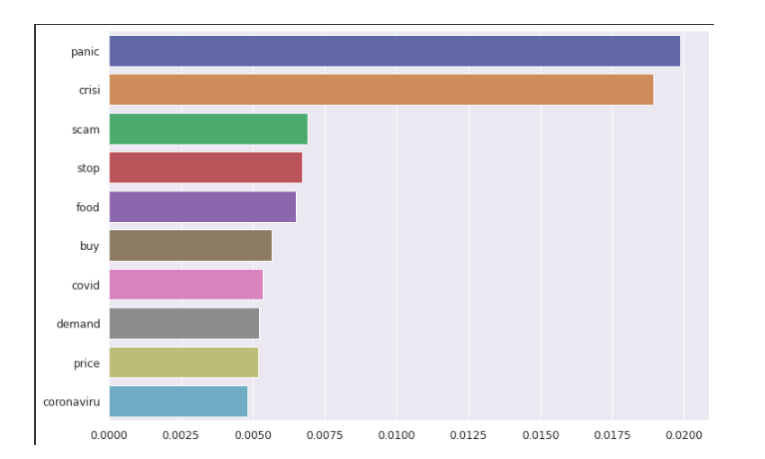
a importância do recurso (importância variável) descreva qual caracteristicas é relevante. Pode ajudar a entender melhor o problema resolvido e, as vezes, levar a melhorias de modelo, empregando característica seleção. As três palavras mais destacadas são pânico, crise e fraude, como podemos ver no gráfico a seguir.
conclusão
Desta maneira, podemos explorar mais a partir de vários tweets e dados textuais. Nossos modelos tentarão prever corretamente os diferentes sentimentos. Usei vários modelos para treinar nosso conjunto de dados, mas alguns modelos mostram maior precisão, enquanto outros não. Para classificação multiclasse, o melhor modelo para este conjunto de dados seria CatBoost. Para classificação binária, o melhor modelo para este conjunto de dados seria Stochastic Gradient Descent.
(Você pode acessar o código Python deste projeto neste link-https://github.com/rajeshmore1/Capstone-Project-2 )
A mídia mostrada neste artigo não é propriedade da DataPeaker e é usada a critério do autor.





