
Spark é um mecanismo de análise de dados usado principalmente para uma grande quantidade de processamento de dados. Ele nos permite espalhar dados e operações computacionais em vários clusters para entender um aumento significativo de desempenho.
Hoje em dia, O Spark é o preferido pelos cientistas de dados devido aos seus vários benefícios sobre outras ferramentas de processamento de dados. Al usar Spark, o custo da coleta, diminuição do armazenamento e transferência de dados. Quando trabalhamos em um problema da vida real, é provável que tenhamos grandes quantidades de dados para processar. Portanto, os vários mecanismos distribuídos como Hadoop, Fagulha, etc. estão se tornando as principais ferramentas do ecossistema da ciência de dados.
PySpark
PySpark é uma ferramenta de análise de dados criada por Apache SparkO Apache Spark é um mecanismo de processamento de dados de código aberto que permite a análise de grandes volumes de informações de forma rápida e eficiente. Seu design é baseado na memória, que otimiza o desempenho em comparação com outras ferramentas de processamento em lote. O Spark é amplamente utilizado em aplicativos de big data, Aprendizado de máquina e análise em tempo real, graças à sua facilidade de uso e... Comunidade para usar Python em conjunto com o Spark. Isso nos permite trabalhar com RDD (Conjunto de dados distribuído resiliente)RDD (Conjunto de dados distribuído resiliente) é uma abstração fundamental no Apache Spark que permite o processamento eficiente de grandes volumes de dados. É caracterizada por sua capacidade de ser tolerante a falhas, Habilitando a recuperação de dados perdidos reconstruindo partições. RDDs são imutáveis, Facilitando a paralelização de operações e melhorando o desempenho na computação distribuída. Seu uso é essencial para a análise dos dados.. e DataFrames em Python. O PySpark tem vários recursos que o tornam uma estrutura incrível e quando se trata de lidar com grandes quantidades de dados, O PySpark oferece processamento rápido e em tempo real, flexibilidade, computação in-memory e vários outros recursos. É uma biblioteca Python para usar o Spark que combina a simplicidade da linguagem Python com a eficiência do Spark.
Quadro de dados Pyspark
Um DataFrame é uma coleção distribuída de dados em linhas sob colunas nomeadas. Em termos simples, podemos dizer que é o mesmo que uma tabela em um base de dadosUm banco de dados é um conjunto organizado de informações que permite armazenar, Gerencie e recupere dados com eficiência. Usado em várias aplicações, De sistemas corporativos a plataformas online, Os bancos de dados podem ser relacionais ou não relacionais. O design adequado é fundamental para otimizar o desempenho e garantir a integridade das informações, facilitando assim a tomada de decisão informada em diferentes contextos.... ou uma planilha do Excel com cabeçalhos de coluna. DataFrames são projetados principalmente para processar uma coleção em grande escala de dados estruturados ou semiestruturados.
Neste artigo, vamos discutir o 10 Funções do PySpark que são mais úteis e essenciais para realizar análises de dados eficientes de dados estruturados.
Estamos usando o Google Colab como IDE para esta análise de dados.
Primeiro, precisamos instalar o PySpark no Google Colab. Depois disso, vamos importar o módulo pyspark.sql e criar uma SparkSession que será um ponto de entrada da API Spark SQL.
#instalando pyspark
!pip install pyspark
#importando pyspark
importar pyspark

#importing sparksessio
from pyspark.sql import SparkSession

#creating um objeto sparksession e fornecendo appName
spark = SparkSession.builder.appName("pysparkdf").getOrCreate()
Este objeto SparkSession irá interagir com funções e métodos Spark SQL. Agora, vamos criar um Spark DataFrame lendo um arquivo CSV. Usaremos um conjunto de dados simples, quer dizer Fatos nutricionais de 80 produtos de cereal disponível em Kaggle.
#criar um dataframe usando o objeto spark lendo o arquivo csv
df = spark.read.option("cabeçalho", "verdade").csv("/content / cereal.csv")
#mostrar df criado top 10 filas
df.show(10)
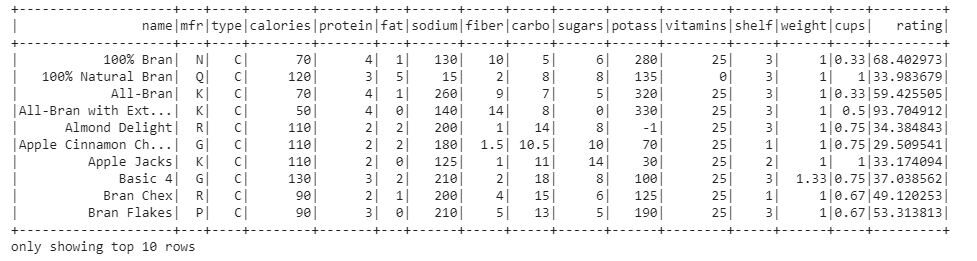
Este é o quadro de dados que estamos usando para análise de dados. Agora, vamos imprimir o esquema do DataFrame para saber mais sobre o conjunto de dados.
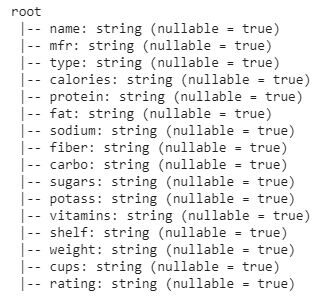
O DataFrame consiste em 16 funções ou colunas. Cada coluna contém valores do tipo string.
Vamos começar com as funções:
- Por favor selecione(): A função de seleção nos ajuda a exibir um subconjunto de colunas selecionadas de todo o quadro de dados, só precisamos passar os nomes das colunas desejadas. Vamos imprimir quaisquer três colunas do quadro de dados usando selecionarO comando "SELECIONE" é fundamental em SQL, usado para consultar e recuperar dados de um banco de dados. Permite especificar colunas e tabelas, filtrando resultados usando cláusulas como "ONDE" e ordenar com "ORDENAR POR". Sua versatilidade o torna uma ferramenta essencial para manipulação e análise de dados, facilitando a obtenção de informações específicas de forma eficiente.... ().
df.select('name', 'mfr', 'rating').exposição(10)
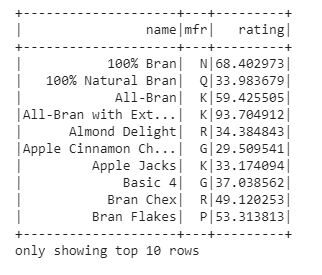
Na saída, temos o subconjunto do quadro de dados com três colunas de nome, mfr, Avaliação.
- withColumn (): A função withColumn é usada para manipular uma coluna ou para criar uma nova coluna com a coluna existente. É uma função de transformação, também podemos alterar o tipo de dados de qualquer coluna existente.
No esquema DataFrame, vimos que todas as colunas são do tipo string. Vamos mudar o tipo de dados da coluna de calorias para um número inteiro.
df.withColumn("Calorias",df['calorias'].elenco("Inteiro")).printSchema()
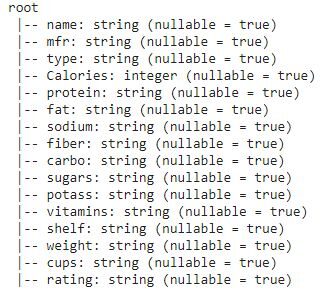
No esquema, podemos ver que a coluna Calorie Data Type foi alterada para o tipo inteiro.
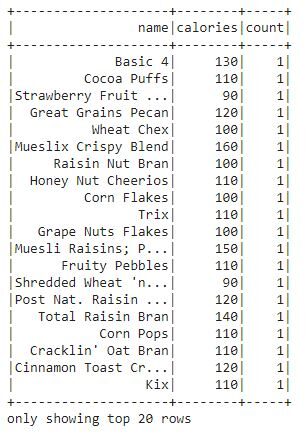
- agrupar por(): A função groupBy é usada para coletar os dados em grupos no DataFrame e nos permite realizar funções de agregação nos dados agrupados. Esta é uma operação de análise de dados muito comum, semelhante à cláusula groupBy em SQL.
Vamos descobrir a contagem de cada cereal presente no conjunto de dados.
df.groupBy("nome", "calorias").contar().exposição()
- ordenar por (): A função orderBy é usada para classificar todo o quadro de dados com base na coluna particular no quadro de dados. Classifique as linhas no quadro de dados com base nos valores da coluna. Por padrão, é classificado em ordem crescente.
Vamos analisar o quadro de dados com base na coluna de proteína do conjunto de dados.
df.orderBy("proteína").exposição()
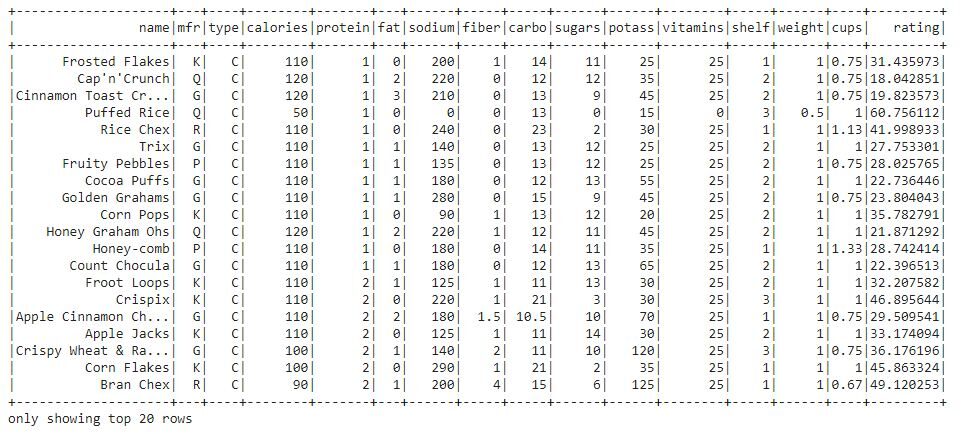
Podemos ver que todo o quadro de dados é ordenado com base na coluna de proteína.
- separar(): A divisão () usado para dividir uma coluna de string de quadro de dados em várias colunas. Esta função é aplicada ao quadro de dados com a ajuda de withColumn () e selecione ().
A coluna do nome do quadro de dados contém valores em duas palavras de string. Vamos dividir a coluna de nome em duas colunas a partir do espaço entre duas strings.
fropm pyspark.sql.functions import split
df1 = df.withColumn('Nome1', dividir(df['name'], " ").getItem(0))
        .withColumn('Nome2', dividir(df['name'], " ").getItem(1))
df1.select("nome", "Name1", "Name2").exposição()
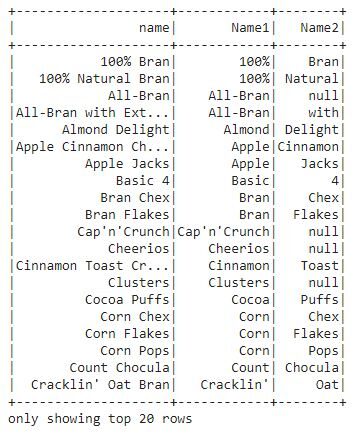
Nesta saída, podemos ver que a coluna do nome é dividida em colunas.
- iluminado(): A função litéusada para adicionar uma nova coluna ao quadro de dados que contém literais ou algum valor constante.
Vamos adicionar uma coluna “quantidade de ingestão” que contém um valor constante para cada um dos cereais junto com o nome do respectivo cereal.
from pyspark.sql.functions import lit
df2 = df.select(col("nome"),aceso("75 gm").apelido("quantidade de ingestão"))
df2.show()
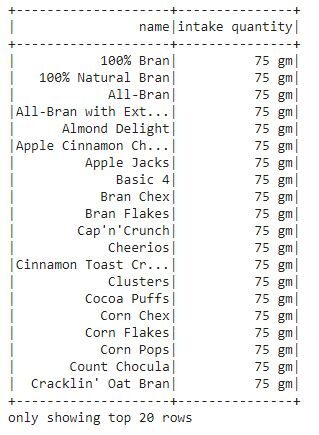
Na saída, Podemos ver que uma nova coluna "quantidade ingerida" é criada contendo a quantidade ingerida de cada cereal.
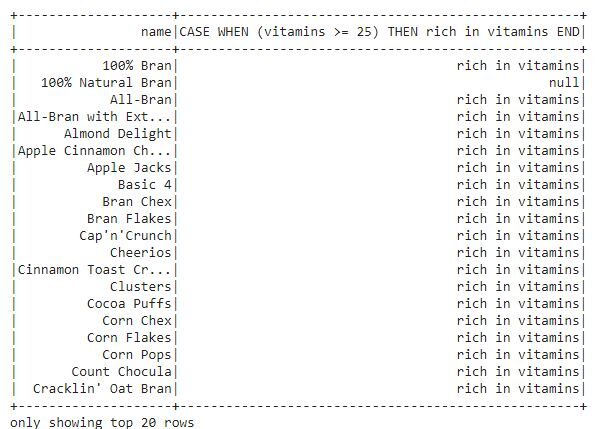
- quando(): Quando a função é usada para exibir a saída com base na condição particular. Avalie a condição fornecida e, em seguida, retorne os valores de acordo. É uma função SQL que o PySpark suporta para verificar várias condições em uma sequência e retornar o valor. Esta função funciona de forma semelhante às instruções if-then-else e switch.
Vejamos os cereais ricos em vitaminas.
de pyspark.sql.functions importar quando
df.select("nome", quando(df.vitaminas >= "25", "rico em vitaminas")).exposição()
- filtro(): A função de filtro é usada para filtrar dados em linhas com base em valores de coluna específicos. Por exemplo, podemos filtrar cereais que têm calorias iguais a 100.
do filtro de importação pyspark.sql.functions
df.filter(df.calories == "100").exposição()
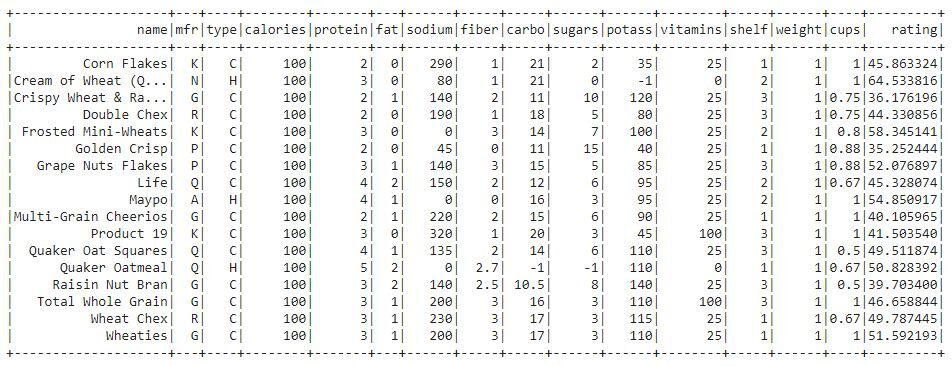
Nesta saída, podemos ver que os dados são filtrados de acordo com os cereais que têm 100 calorias.
- é nulo () / não é nulo (): Essas duas funções são usadas para descobrir se há algum valor nulo presente no DataFrame. É a função mais essencial para processamento de dados. É a principal ferramenta usada para limpeza de dados.
Vamos descobrir se há algum valor nulo presente no conjunto de dados.
#não é nulo()
de importação de pyspark.sql.functions *
#filtrar dados por valores nulos
df.filter(df.name.isNotNull()).exposição()
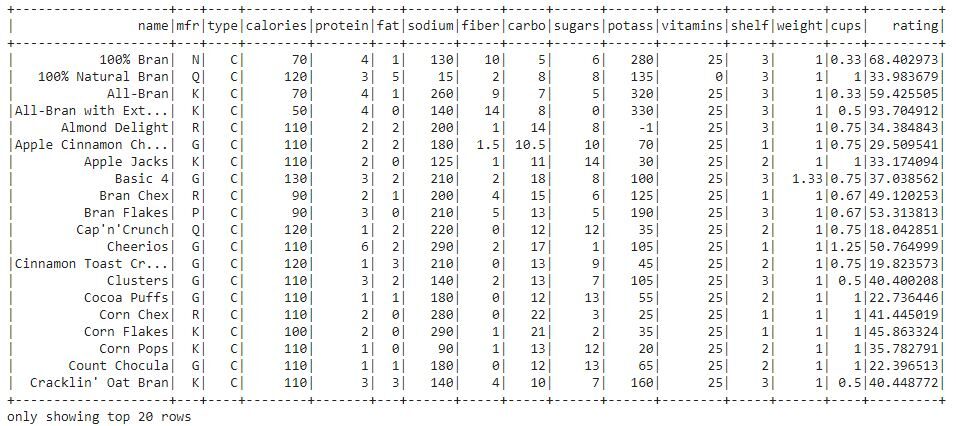
Não há valores nulos presentes neste conjunto de dados. Portanto, todo o quadro de dados é exibido.
É nulo():
df.filter(df.name.isNull()).exposição()
Novamente, sem valores nulos. Portanto, um quadro de dados vazio é exibido.
Neste blog, nós discutimos o 9 funções mais úteis para processamento de dados eficiente. Essas funções do PySpark são a combinação das linguagens Python e SQL.
Obrigado pela leitura. Por favor, deixe-me saber se houver algum comentário ou feedback.
A mídia mostrada neste artigo não é propriedade da DataPeaker e é usada a critério do autor.





