
Este artigo foi publicado como parte do Data Science Blogathon.
Introdução
Interessado em análise preditiva? Mais tarde, pesquisar inteligência artificial, aprendizado de máquina e aprendizado profundoAqui está o caminho de aprendizado para dominar o aprendizado profundo em, Uma subdisciplina da inteligência artificial, depende de redes neurais artificiais para analisar e processar grandes volumes de dados. Essa técnica permite que as máquinas aprendam padrões e executem tarefas complexas, como reconhecimento de fala e visão computacional. Sua capacidade de melhorar continuamente à medida que mais dados são fornecidos a ele o torna uma ferramenta fundamental em vários setores, da saúde.... .
Se você está no caminho de aprender ciência de dados, definitivamente entendo o que é aprendizado de máquina. No mundo digital de hoje, todo mundo sabe o que é aprendizado de máquina porque era uma tecnologia digital da moda em todo o mundo.
Cada passo em direção à adaptação ao mundo futuro é liderado por esta tecnologia atual, e esta tecnologia atual é liderada por cientistas de dados como você e eu😌.
Aqui, falamos apenas sobre aprendizado de máquina, se você não sabe o que é, nós damos a você uma breve introdução:
Aprendizado de máquina é o estudo de algoritmos de computador, que melhoram automaticamente por meio da experiência e do uso de dados. seu algoritmo constrói um modelo com base nos dados que fornecemos durante a construção do modelo. Esta é a definição simples de aprendizado de máquina, e quando vamos fundo, descobrimos que há muitos algoritmos usados na construção de modelos. Geralmente, os algoritmos de aprendizado de máquina mais usados são baseados no tipo de problema, os caras são basicamente regressão, classificação, etc ... Mas aqui vamos falar apenas sobre algoritmos de regressão.
Vamos fazer uma breve introdução sobre o que é regressão. Regressão é o método estatístico em investimentos, finanças e outras disciplinas que tentam determinar a força e a relação entre as variáveis independentes e dependentes. Geralmente, as variáveis independentes são aquelas em que seus valores são usados para obter o output e as variáveis dependentes são aquelas cujo valor depende de valores independentes. Ao falar sobre algoritmos de regressão, alguns algoritmos de regressão comumente usados são usados para treinar o modelo de aprendizado de máquina, como regressão linear simples, fita, crista, etc.
Portanto, Vamos falar sobre regressão linear múltipla e entender em detalhes como o linear simples difere da regressão linear múltipla.
- Regressão linear simples vs regressão linear múltipla
- Conjunto de dados
- Leia o conjunto de dados
- Variáveis independentes e dependentes
- Gestão de variáveis categóricas
- Divisão de dados
- Aplicando modelo
Regressão linear simples versus regressão linear múltipla
Agora, antes de seguir em frente, vamos analisar a interação por trás da regressão linear simples, em seguida, tentamos comparar a regressão linear simples e múltipla com base na intuição que estamos realmente fazendo com nosso problema de aprendizado de máquina.
Regressão linear simples
Consideramos uma regressão linear simples em qualquer algoritmo de aprendizado de máquina usando o exemplo,
Agora, Suponha que se tomarmos um cenário de preço de casa onde nosso eixo x é o tamanho da casa e o eixo y é basicamente o preço da casa. Nisto basicamente, nós temos duas características, o primeiro é f1 e o segundo é f2, Onde,
f1 refere-se ao tamanho da casa e,
f2 refere-se ao preço da casa
Assim, se f1 torna-se o recurso autônomo e f2 torna-se a característica dependente, geralmente sabemos que sempre que o tamanho da casa aumenta, o preço também aumenta, suponha que desenhemos pontos de dispersão aleatoriamente, através deste ponto de dispersão basicamente tentamos encontrar a linha de melhor ajuste e esta linha de melhor ajuste é dada pela equação :
equação: y = A + Bx
Suponha, e seja o preço da casa e X seja o tamanho da casa, então esta equação se parece com isto:
equação: preço = A + B (Tamanho)
Onde,
A é uma interceptação e B é uma inclinação nessa interceptação
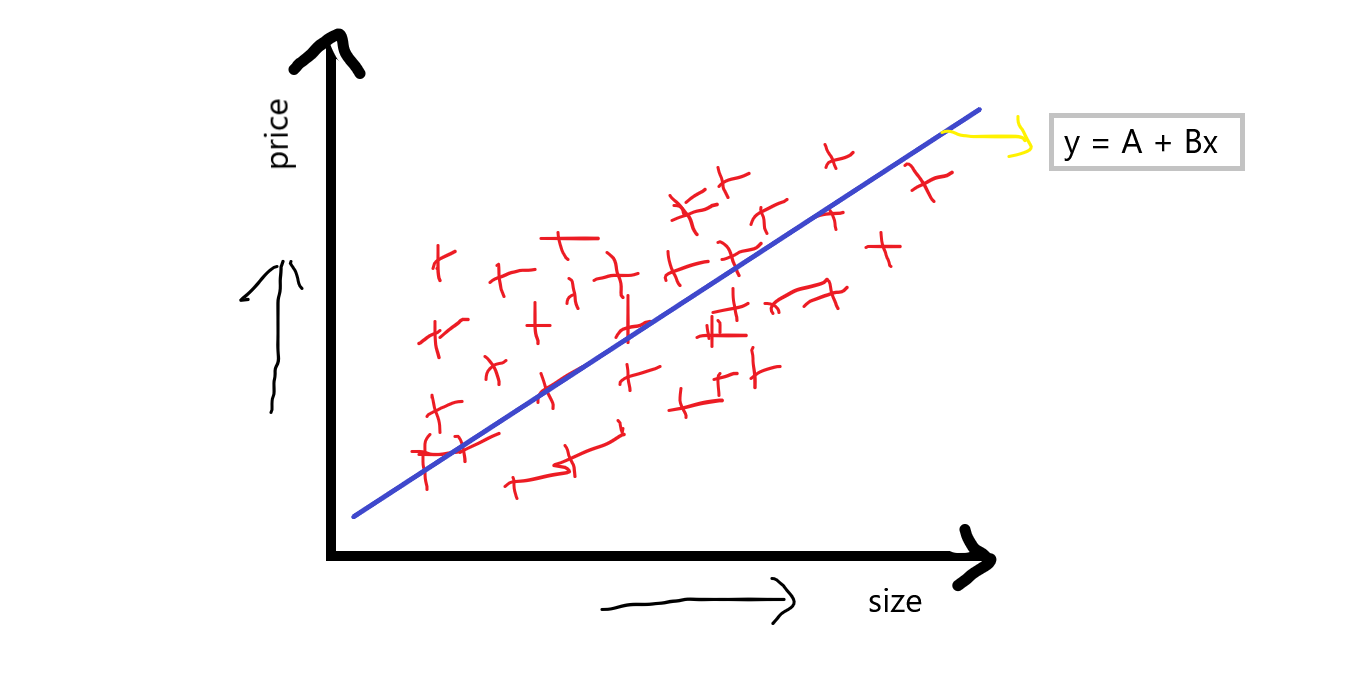
Quando discutimos esta equação, em que o cruzamento indica basicamente quando o preço da casa é 0 então qual será o preço base da casa, e a inclinação ou coeficiente indica que com a unidade aumenta de tamanho, então qual será a unidade aumenta na inclinação.
Contudo, Qual é a diferença em comparação com a regressão linear múltipla?
Regressão linear múltipla
A regressão linear múltipla basicamente indica que teremos muitas características, como f1, f2, f3, f4, e nossa função de saída f5. Se tomarmos o mesmo exemplo que discutimos anteriormente, suponha:
f1 é o tamanho da casa.
f2 Eles são quartos ruins na casa.
f3 é a cidade da casa.
f4 é o estado da casa e,
f5 é a nossa característica de saída que é o preço da casa.
Agora, você pode ver que vários recursos independentes têm um grande impacto no preço da casa também, o preço pode variar de recurso para recurso. Quando falamos sobre regressão linear múltipla, então a equação de regressão linear simples y = A + Bx se transforma em algo como:
equação: y = A + B1X1+ B2X2+ B3X3+ B4X4
“Se tivermos uma função dependente e várias funções independentes, nós basicamente chamamos isso Regressão linear múltipla. “
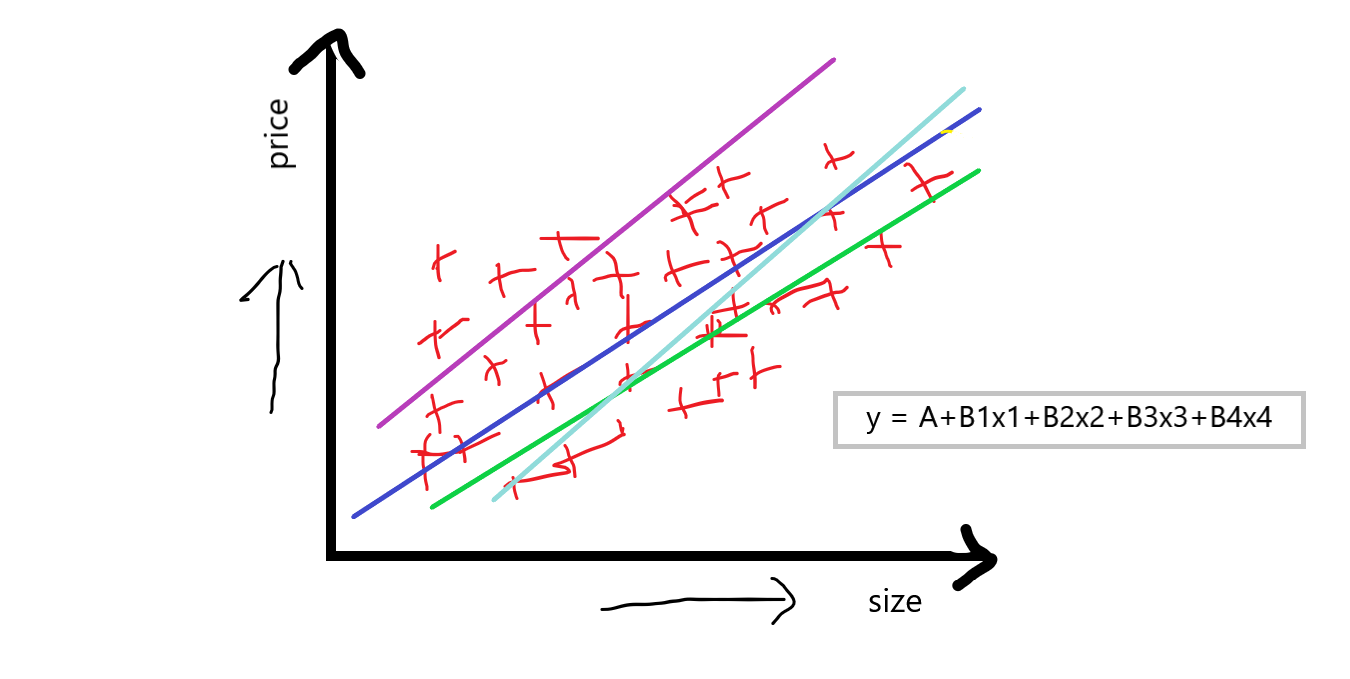
Agora, nosso objetivo ao usar regressão linear múltipla é que temos que calcular UMA o que é um cruzamento, e B1 B2 B3 B4 quais são as inclinações ou coeficientes que se referem a esta característica independente, o que basicamente indica que, se aumentarmos o valor de X1 por 1 dirigir então B1 diz quanto valor afetará o preço da casa, e isso era semelhante em relação a outros B2 B3 B4
Então, esta é uma breve descrição teórica de regressão linear múltipla. Agora vamos usar a biblioteca de regressão linear scikit learn para resolver o problema de regressão linear múltipla.
Conjunto de dados
Agora, aplicamos regressão linear múltipla no 50_iniciantes conjunto de dados, você pode clicar aqui para baixar o conjunto de dados.
Leia o conjunto de dados
A maior parte do conjunto de dados está em um arquivo CSV, para ler este arquivo usamos a biblioteca pandas:
df = pd.read_csv('50_Startups.csv')
df
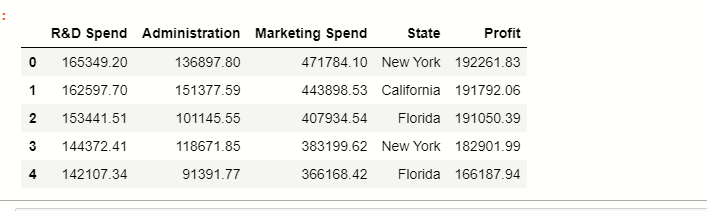
Aqui você pode ver o que há 5 colunas no conjunto de dados onde o Estado armazena pontos de dados categóricos e o resto são características numéricas.
Agora, temos que classificar as características independentes e dependentes:
Variáveis independentes e dependentes
Há um total de 5 características no conjunto de dados, em que basicamente os lucros são nossa característica dependente, e o resto deles são nossos recursos independentes:
#separar os outros atributos do atributo de previsão
x = df.drop('Lucro',eixo = 1)
#separte the predicting attribute into Y for model training
y = ['profit']
Gestão de variáveis categóricas
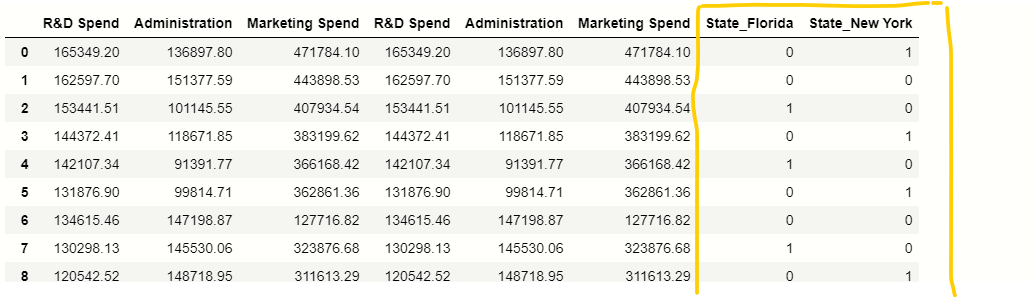
Em nosso conjunto de dados, existe uma coluna categórica Estado, temos que lidar com esses valores categóricos presentes nesta coluna para que usaremos pandas get_dummies () Função:
# lidar variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos.... Categórico
estados = pd.get_dummies (x, drop_first = True)
# removendo coluna extra
x = x.drop ('Estado', eixo = 1)
# concatenação de variáveis independentes e nova variável cateórica.
x = pd.concat ([x,estados], eixo = 1)
X
Divisão de dados
Agora, temos que dividir os dados em partes de TreinamentoO treinamento é um processo sistemático projetado para melhorar as habilidades, Conhecimento ou habilidades físicas. É aplicado em várias áreas, como esporte, Educação e desenvolvimento profissional. Um programa de treinamento eficaz inclui planejamento de metas, prática regular e avaliação do progresso. A adaptação às necessidades individuais e a motivação são fatores-chave para alcançar resultados bem-sucedidos e sustentáveis em qualquer disciplina.... e teste para o qual usamos o scikit-learn train_test_split () Função.
# importando train_test_split do sklearn
de sklearn.model_selection import train_test_split
# dividindo os dados
x_train, x_test, y_train, y_test = train_test_split(x, e, test_size = 0.2, random_state = 42)
Aplicando modelo
Agora, aplicamos o modelo de regressão linear aos nossos dados de treinamento, em primeiro lugar, temos que importar a regressão linear da biblioteca scikit-learn, não há outra biblioteca para implementar regressão linear múltipla, nós fazemos isso apenas com regressão linear.
# importando módulo
de sklearn.linear_model import LinearRegression
# criando um objeto da classe LinearRegression
LR = LinearRegression()
# ajustando os dados de treinamento
LR.fit(x_train,y_train)
Finalmente, se nós rodarmos isso, então nosso modelo estará pronto, agora temos dados de x_test, Usamos esses dados para a previsão de lucro.
y_prediction = LR.predict(x_test)
y_prediction
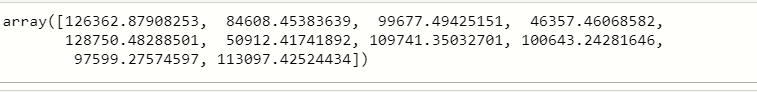
Agora, temos que comparar os valores de predição y com os valores originais porque temos que calcular a precisão do nosso modelo, que foi implementado por um conceito chamado r2_score. vamos discutir brevemente sobre r2_score:
r2_score: –
É uma função dentro do sklearn. módulo de métricas, onde o valor de r2_score varia entre 0 e 100 por cento, podemos dizer que está intimamente relacionado ao MSE.
r2 é basicamente calculado pela fórmula dada abaixo:
Fórmula: r2 = 1 – (WLres / WLsignificar )
agora, quando eu digo WLres quer dizer, é a soma dos resíduos e WLsignificar refere-se à soma das médias.
Onde,
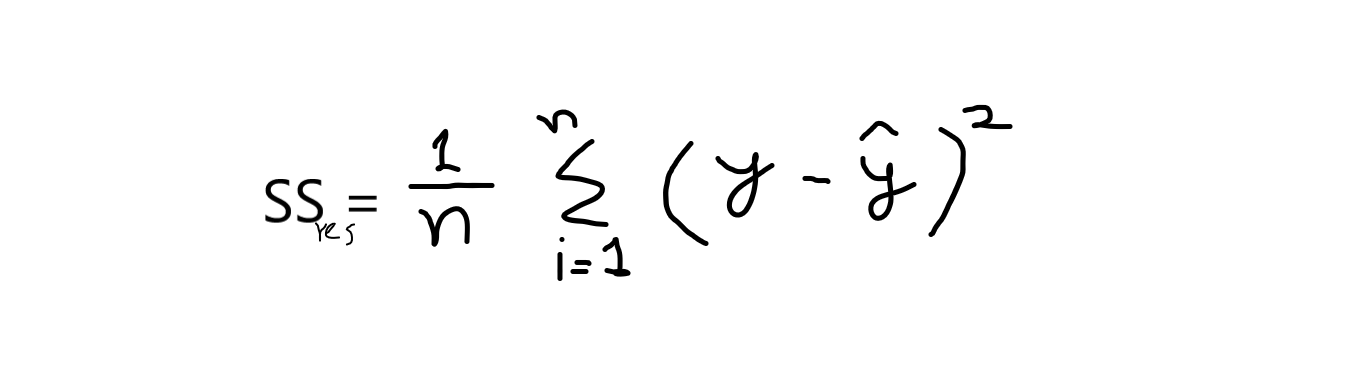
e = valores originais
e ^ = valores preditos. e,
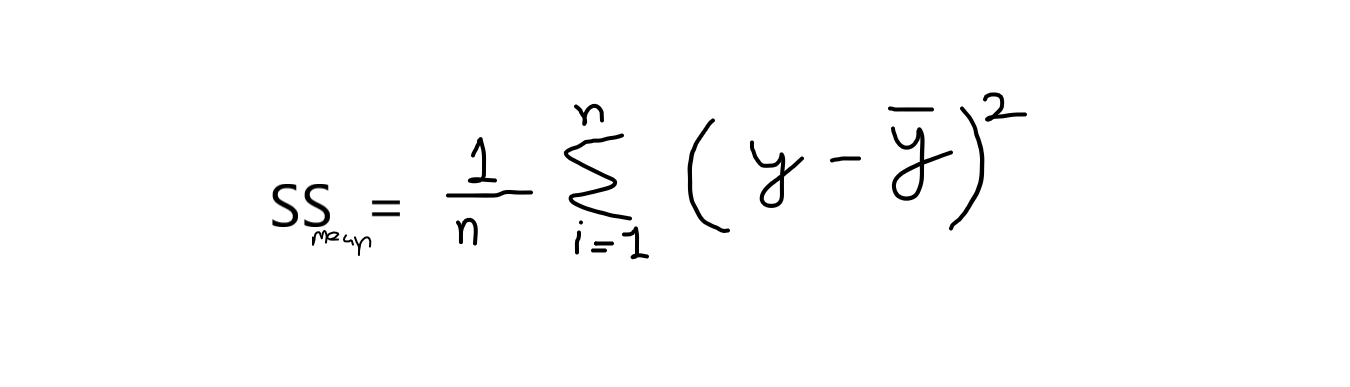
Se tomarmos o cálculo desta equação, então temos que saber que o valor da soma das médias é sempre maior que a soma dos resíduos. Se esta condição for atendida, então nosso modelo é bom para previsões. Seus valores variam de 0,0 e 1.
“A proporção da variação na variável dependente que é previsível a partir do (s) variável (s) Independente”.
A melhor pontuação possível é 1.0 e pode ser negativo porque o modelo pode ser arbitrariamente pior. Um modelo constante que sempre prevê o valor esperado de y, independentemente das características de entrada, obteria uma pontuação de R2 de 0.0.
# importando módulo r2_score
de sklearn.metrics importar r2_score
de sklearn.metrics importar mean_squared_error
# prever pontuação de precisão
score = r2_score (y_test, y_prediction)
imprimir (‘R2 socre é’, pontuação)
imprimir (‘Mean_sqrd_error is ==’, mean_squared_error (y_test, y_prediction))
imprimir (‘Root_mean_squared error of is ==’, np.sqrt (mean_squared_error (y_test, y_prediction)))
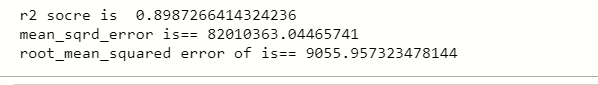
Você pode ver que a pontuação de precisão é maior do que 0,8, o que significa que podemos usar este modelo para resolver múltiplas regressões lineares, e também a taxa de erro quadrático médio também é baixa.
Notas finais
Olá, cientistas de dados 😎 acima, discutimos detalhadamente sobre regressão linear múltipla, e o exemplo que usamos é o exemplo de regressão linear múltipla perfeita. Espero que agora você entenda melhor a regressão linear múltipla.
Espero que você tenha gostado disso!
Você pode me conectar no LinkedIn: www.linkedin.com/in/mayur-badole-189221199
O que mais, leia meus outros artigos: https://www.analyticsvidhya.com/blog/author/mayurbadole2407/
Obrigado.





