
Este artigo foi publicado como parte do Data Science Blogathon
Introdução
Fast.ai utiliza métodos y enfoques avanzados en el aprendizado profundoAqui está o caminho de aprendizado para dominar o aprendizado profundo em, Uma subdisciplina da inteligência artificial, depende de redes neurais artificiais para analisar e processar grandes volumes de dados. Essa técnica permite que as máquinas aprendam padrões e executem tarefas complexas, como reconhecimento de fala e visão computacional. Sua capacidade de melhorar continuamente à medida que mais dados são fornecidos a ele o torna uma ferramenta fundamental em vários setores, da saúde... para generar resultados de vanguardia. Essa abordagem que discutiremos nos permite treinar modelos mais precisos, mais rápido, com menos dados e em menos tempo e dinheiro.
Fast.ai foi fundada por Jeremy Howard e Raquel Thomas para proporcionar a los profesionales del aprendizaje profundo una manera rápida y fácil de lograr resultados de vanguardia en los dominios de aprendizagem supervisionadaO aprendizado supervisionado é uma abordagem de aprendizado de máquina em que um modelo é treinado usando um conjunto de dados rotulados. Cada entrada no conjunto de dados está associada a uma saída conhecida, permitindo que o modelo aprenda a prever resultados para novas entradas. Este método é amplamente utilizado em aplicações como classificação de imagens, Reconhecimento de fala e previsão de tendências, destacando sua importância em... estándar del aprendizaje profundo, quer dizer, Filtro de visão, texto, tabular e colaborativo.
Agora vamos começar com Fast.ai.
Este tutorial pressupõe um conhecimento básico de python3. É necessário um laptop Jupyter com GPU, ya que la GPU acelera el proceso de TreinamentoO treinamento é um processo sistemático projetado para melhorar as habilidades, Conhecimento ou habilidades físicas. É aplicado em várias áreas, como esporte, Educação e desenvolvimento profissional. Um programa de treinamento eficaz inclui planejamento de metas, prática regular e avaliação do progresso. A adaptação às necessidades individuais e a motivação são fatores-chave para alcançar resultados bem-sucedidos e sustentáveis em qualquer disciplina.... sobre 100 vezes em comparação com a CPU. Você pode acessá-lo de Google Collaborative que é um ambiente de laptop jupyter e fornece uma GPU gratuita. Referir Está para habilitar a GPU gratuita no Colab.
Treine um classificador de imagens
Vamos treinar um classificador de imagem MNIST básico usando Fast.ai. O conjunto de dados MNIST consiste em imagens de dígitos manuscritos do 0 al 9. Portanto, tenho 10 classes e é um problema de classificação multi-classe. Isso consiste de 60000 imagens no conjunto de treinamento e 10000 imagens no conjunto de validação.
Importações
Na primeira célula, execute o seguinte para se certificar de que todas as bibliotecas necessárias estão instaladas. Pelo contrário, a biblioteca fastai será instalada e você terá que reiniciar o tempo de execução.
!pip install fastai --upgrade
Mais tarde, vamos importar a biblioteca de visão fastai,
de importação fastai.vision.all *
Se você já teve alguma experiência em programação Python ou desenvolvimento de software, você se perguntará se deve importar todos os submódulos e funções da classe (quer dizer, usar *) é uma prática pouco saudável. Mas a biblioteca fastai é projetada de tal forma que apenas as funções necessárias são importadas e garante que não haverá carga desnecessária na memória.
Download de dados
Agora, vamos baixar os dados necessários,
path = untar_data(URLs.MNIST)
Aqui usamos uma função fastai untar_data que pega o url do conjunto de dados e baixa e extrai o conjunto de dados e, em seguida, retorna o caminho dos dados. Retorna um Pathlib's PosixPath objeto que pode ser usado para acessar e navegar em sistemas de arquivos com facilidade. Acessamos a URL do conjunto de dados MNIST do fastai URLs método que consiste em URLs de muitos conjuntos de dados diferentes.
Podemos verificar o conteúdo do caminho usando
#to list the contents
path.ls()
Podemos ver que existem duas pastas. Treinamento e testes consistindo em dados de treinamento e dados de validação, respectivamente.
Carregando dados
Agora podemos carregar os dados,
dls = ImageDataLoaders.from_folder(caminho = caminho,
                                   train='training',
                                   valid='testing',
                                   shuffle = True)
ImageDataLoaders é um dos tipos de classes que usamos para carregar conjuntos de dados para problemas de visão computacional. Geralmente, Os conjuntos de dados de visão computacional são estruturados de forma que a marca de uma imagem seja o nome da pasta na qual a imagem está presente. Como nosso conjunto de dados é estruturado dessa maneira, nós usamos um método from_folder para carregar imagens de pastas no caminho fornecido.
Nós especificamos o caminho do conjunto de dados de onde as imagens são carregadas em lotes, especificamos o nome das pastas que consistem em dados de treinamento e validação que serão usados para treinamento e validação, e então inicializamos embaralhar um verdadeiro, o que garante que enquanto o modelo está treinando, as imagens são misturadas e alimentadas no modelo.
Para obter mais informações sobre qualquer função fastai, podemos usar o método doc () que mostra a breve documentação sobre essa função.
doc(ImageDataLoaders.from_folder)
Podemos ver alguns dos dados usando show_batch () método,
dls.train.show_batch()
dls.valid.show_batch()
Mostre algumas imagens do conjunto de treinamento e do conjunto de validação, respectivamente.
Treinamento de modelo
Agora vamos criar o modelo,
learn = cnn_learner(dls,
                    resnet18,
                    metrics =[precisão, taxa de erro])
Aqui estamos usando cnn_learner quer dizer, especificar fastai para construir un modelo de convolucional neuronal vermelhoRedes Neurais Convolucionais (CNN) são um tipo de arquitetura de rede neural projetada especialmente para processamento de dados com uma estrutura de grade, como fotos. Eles usam camadas de convolução para extrair recursos hierárquicos, o que os torna especialmente eficazes em tarefas de reconhecimento e classificação de padrões. Graças à sua capacidade de aprender com grandes volumes de dados, As CNNs revolucionaram campos como a visão computacional.. a partir de la arquitetura dada, quer dizer resnet18 e treinar no carregador de dados especificado, quer dizer dls e rastrear as métricas fornecidas, quer dizer precisão e Taxa de erro.
CNN é a abordagem de ponta para modelagem de visão computacional. Aqui estamos usando uma técnica chamada transferência de aprendizagem para treinar nosso modelo. Esta técnica usa um Modelo pré-convertido quer dizer, uma arquitetura padrão e já treinada para um propósito diferente. Vamos entrar em detalhes na próxima seção.
Agora vamos treinar (na realidade, vamos sintonizar) o modelo,
Podemos ver que o modelo começa a treinar com dados durante 4 épocas. Os resultados são semelhantes aos seguintes,
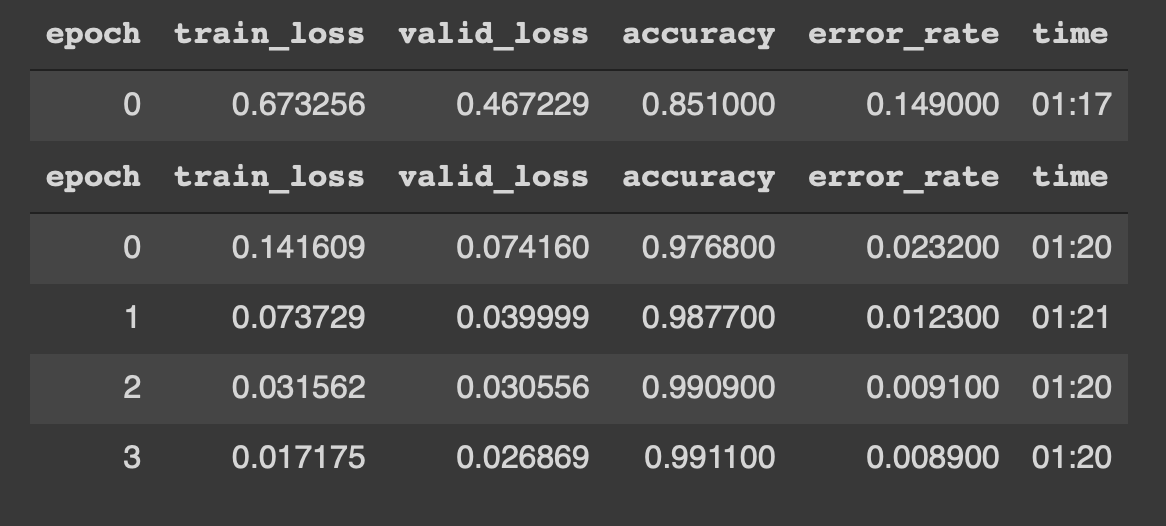
¡¡Woah !! uma precisão de 99% e quase um 0,8% de error_rate são, literalmente, resultados de ponta. O que mais, conseguimos isso com apenas 4 épocas, 5 linhas de código e 5 minutos de treinamento.
Colocando junto,
de importação fastai.vision.all *
path = untar_data(URLs.MNIST)
dls = ImageDataLoaders.from_folder(caminho = caminho,
                                   train='training',
                                   valid='testing',
                                   shuffle = True)
learn = cnn_learner(dls,
                    resnet18,
                    metrics =[precisão, taxa de erro])
learn.fine_tune(4)
Isso é possível graças a uma técnica chamada Aprendizagem de transferência. Vamos discutir isso com alguns detalhes.
Aprendizagem de transferência
Antes de continuar, devemos conhecer os modelos pré-treinados.
Modelos previamente treinados são basicamente arquiteturas que já foram treinadas em um conjunto de dados diferente e para uma finalidade diferente. Por exemplo, nós costumavamos reenviado 18 como nossa rede pré-treinada. Também conhecido como redes residuais, resent18 consiste em 18 camadas e é treinado em mais de um milhão de imagens do conjunto de dados ImageNet. Esta rede pré-treinada pode facilmente classificar imagens em 1000 aulas, como livros, lápis, animais, etc. Portanto, este modelo conhece vários objetos e coisas antes mesmo de ser treinado em nosso conjunto de dados. É por isso que é chamado Preentrenada vermelha.
Agora, transferência de aprendizagem é a técnica que nos permite usar um modelo previamente treinado para uma nova tarefa e conjunto de dados. Aprendizagem de transferência é basicamente o processo de usar um modelo pré-treinado para uma tarefa diferente daquele que foi originalmente treinado, quer dizer, neste caso, estamos usando o reenvio 18 para treinar em imagens de dígitos manuscritos.
Isso é possível devido a uma etapa fundamental chamada sintonia FINA. Quando temos um modelo previamente treinado, usamos esta etapa para atualizar o modelo previamente treinado de acordo com as necessidades de nossa tarefa / dados. O ajuste fino é basicamente uma técnica de transferência de aprendizagem que atualiza os pesos do modelo pré-treinado, treinando para algumas épocas no novo conjunto de dados..
Portanto, Usando esta técnica, podemos alcançar resultados de ponta em nossa tarefa, quer dizer, classificar dígitos manuscritos.
Agora vamos fazer algumas previsões
Prever imagens
Primeiro, vamos obter todos os caminhos de imagem no conjunto de teste e, em seguida, convertê-los em uma imagem e fazer a previsão.
# obter todos os caminhos de imagem da pasta de teste
images = get_image_files(path/'testing')
# selecione uma imagem e exiba
img = PILImage.create(imagens[4432])
img
Preveja a imagem
# prever a classe da imagem
lbl, _ , _ = learn.predict(img)
lbl
Relatório de classificação
Também podemos gerar um relatório de classificação a partir do modelo para inferência.
interep = ClassificationInterpretation.from_learner(aprender)
interep.plot_confusion_matrix()
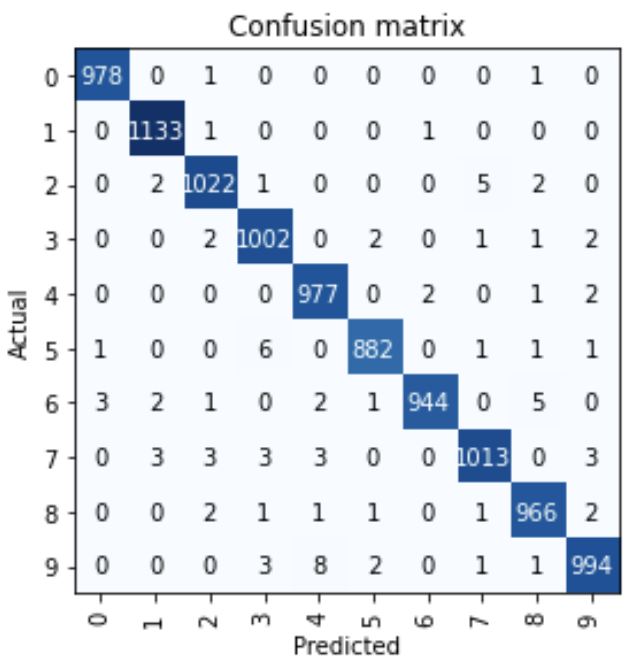
Podemos ver que quase 10000 imagens, apenas algumas imagens foram classificadas incorretamente.
Obrigado e feliz aprendizado profundo!!
Referências:
1. Aprendizagem profunda prática para programadores por Jeremy Howard e Sylvain Gugger
Por Narasimha Karthik J
Você pode se conectar comigo através de Do link o Twitter
A mídia mostrada neste artigo sobre a construção de modelos de aprendizado profundo de próxima geração com Fast.ai não é propriedade da DataPeaker e é usada a critério do autor.





