
Visão geral
- Introdução
- reduzir o tempo de execução
- conjunto de dados
- ler conjunto de dados
- gestão de variáveis categóricas
- característica dependente e independente
- TreinamentoO treinamento é um processo sistemático projetado para melhorar as habilidades, Conhecimento ou habilidades físicas. É aplicado em várias áreas, como esporte, Educação e desenvolvimento profissional. Um programa de treinamento eficaz inclui planejamento de metas, prática regular e avaliação do progresso. A adaptação às necessidades individuais e a motivação são fatores-chave para alcançar resultados bem-sucedidos e sustentáveis em qualquer disciplina.... de modelos con núcleos de CPU
- Nota final
Introdução
“o 65.536 processadores estavam dentro da máquina de conexão”
~ Philip Emeagwali
Todos nós temos formação em ciência da computação, usamos um computador diariamente e temos uma melhor compreensão do que é o computador. Os computadores têm um coração como o dos humanos, é chamado de CPU.
Todos nós conhecemos a CPU, sim, não é assim, a UPC é a unidade de processamento central no computador, ou é um circuito eletrônico que executa as várias instruções que compõem um programa de computador. A CPU realiza aritmética básica, lógica, etc.
Gerações anteriores de CPUs foram implementadas como componentes discretos e vários pequenos ICs em uma ou mais placas de circuito. Com o tempo, CPUs são alteradas, São atualizados. Eles são implementados em um circuito integrado, com uma ou mais CPUs em um único chip IC. Existem muitas funções ou operações que o computador executa, então leva muito tempo, para isso, o cientista projetou o processadores multicore, era uma combinação de chips de microprocessador com múltiplas CPUs.
Processadores multi-core são muito rápidos, pode trabalhar daqui a pouco. Como cientista de dados, descobrimos que algumas das bibliotecas Python são muito lentas e também longas, desacelerar a execução do programa, se necesita mucho tiempo para a ejecución dos nossos modelos de aprendizagem automática o aprendizado profundoAqui está o caminho de aprendizado para dominar o aprendizado profundo em, Uma subdisciplina da inteligência artificial, depende de redes neurais artificiais para analisar e processar grandes volumes de dados. Essa técnica permite que as máquinas aprendam padrões e executem tarefas complexas, como reconhecimento de fala e visão computacional. Sua capacidade de melhorar continuamente à medida que mais dados são fornecidos a ele o torna uma ferramenta fundamental em vários setores, da saúde.... Se você quiser ver quantos núcleos estão em seu computador, apenas abra o seu PainelUm painel é um grupo de especialistas que se reúne para discutir e analisar um tópico específico. Esses fóruns são comuns em conferências, Seminários e debates públicos, onde os participantes compartilham seus conhecimentos e perspectivas. Os painéis podem abordar uma variedade de áreas, Da ciência à política, e seu objetivo é incentivar a troca de ideias e a reflexão crítica entre os participantes.... Controle e pesquisar sistema você verá todas as informações sobre o seu computador.
Se falarmos sobre a biblioteca python panda que é usada em aprendizado de máquina para manipulação de dados e análise de dados, se analisarmos uma pequena quantidade de dados, não demorará tanto para realizar as operações, mas e se nosso conjunto de dados for grande? sem saber, levará muito tempo para realizar cálculos em uma grande quantidade de dados. Então, Isto é um grande problema, que todos os cientistas de dados enfrentam em suas carreiras. E se reduzirmos este tempo? é benéfico para nós?
nós discutiremos abaixo:
Reduza o tempo de execução
Acima temos uma breve discussão sobre a CPU, então, que significa? Significa que usamos núcleos da unidade central de processamento para entrenar o nosso modelo de aprendizagem automático. Hay uno de los parametroso "parametros" são variáveis ou critérios usados para definir, medir ou avaliar um fenômeno ou sistema. Em vários domínios, como a estatística, Ciência da Computação e Pesquisa Científica, Os parâmetros são essenciais para estabelecer normas e padrões que orientam a análise e interpretação dos dados. Sua seleção e manuseio adequados são cruciais para obter resultados precisos e relevantes em qualquer estudo ou projeto.... especiales dentro del algoritmo de aprendizaje automático que normalmente lo usamos, mas não temos conhecimento sobre isso ou não. Eu sei o significado exato disso, Isso parece incrível!
Esses núcleos de CPU são partes muito importantes do treinamento de qualquer modelo de aprendizado de máquina., isso também é importante ao trabalhar com aprendizado profundo, porque esses núcleos de CPU serão possíveis programação paralela ou execução paralela do programa. Não podemos treinar modelos de aprendizado de máquina com a ajuda de GPUs, portanto, CPUs são mais úteis nesta condição.
Para treinamento de aprendizado de máquina mais rápido em qualquer projeto de aprendizado de máquina, você pode usar esses núcleos de CPU, desde que tenha uma grande quantidade de dados no conjunto de dados para treinar o modelo de aprendizado de máquina.
Agora, vemos como treinamos o modelo de aprendizado de máquina usando núcleos de CPU para melhorar o desempenho em relação ao modelo de aprendizado de máquina:
Conjunto de dados
Para treinar esta declaração de problema particular, temos que levar o Wine_Quality conjunto de dados, o link de referência para este conjunto de dados é aqui.
Para entender melhor este conjunto de dados, você pode verificar este link: Clique aqui
Lembre-se se você tiver que resolver este problema específico com núcleos de CPU, então você deve ter um conjunto de dados simples com um grande tamanho de dados.
A razão por trás do uso deste conjunto de dados é que ele é um conjunto de dados simples com um grande tamanho de dados presente neste conjunto de dados..
Vamos ver qual é o tamanho desses dados:
Leia o conjunto de dados
Em primeiro lugar, temos que ler o conjunto de dados de qualidade do vinho usando pandas.
#importando pandas
df = pd.read_csv('wine_quality.csv')
df.head()

df.shape()

Depois de executar este código, você pode ver que temos 6497 filas e 13 colunas no conjunto de dados de qualidade do vinho.
Agora, verificamos as categorias exclusivas que estão presentes em um qualidade variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos....,
Unique_points = df['qualidade'].exclusivo()
Unique_points

Como vemos, existem 6, 5, 7, 8, 4, 3, 9 pontos de dados únicos na variável de qualidade, onde esses pontos de dados são as medidas de qualidade do vinho.
Variáveis categóricas de Handel
# vars catogerical
next_df = pd.get_dummies(new_df,drop_first = True)
# exibir novo dataframe
next_df

Característica dependente e independente
Para aplicar o modelo de aprendizado de máquina, temos que dividir as características dependentes e independentes:
# características independentes
x = next_df.drop(['qualidade','best quality'],eixo = 1)
# característica dependente
y = next_df['best quality']
Treinamento de modelo com núcleos de CPU
Vindo para execução agora, estamos fazendo isso aplicando alguns passos:
Paso 1: Usando o algoritmo de aprendizado de máquina RandomForestClassifier.
Paso 2: Usando RepeatedStratifiedKFold para validação cruzada.
Paso 3: Treine o modelo usando a pontuação de validação cruzada.
Quando inicializamos todas essas coisas, o tempo será calculado com base nesta pontuação de validação cruzada. Antes de verificar a hora, importamos os módulos necessários:
Importação de módulo:
de tempo de tempo de importação
# importando RepeatedStratifiedKFold
from sklearn.model_selection import RepeatedStratifiedKFold
from sklearn.ensemble import RandomForestClassifier
de sklearn.model_selection import cross_val_score
# importando RandomForestClassifier
Agora, verificamos o tempo usando os diferentes núcleos da CPU:
Aqui, usamos o algoritmo de aprendizado de máquina RandomForestClassifie, quando você verifica os parâmetros de RandomForestClassifier, você descobre que há um n_jobs parâmetro.

n_jobs é o parâmetro que realmente o ajudará a basicamente atribuir quantos núcleos um determinado treino de sistema deve levar.
Por exemplo, se quisermos levar n_jobs = 1 então vai levar 1 Núcleo da CPU, sim pegue 2, vai levar 2 Núcleos de CPU, e assim por diante. Quando você deseja usar todos os núcleos da CPU para treinamento e não sabe quantos núcleos existem no sistema, Apenas use n_jobs = -1.
1 Núcleos de CPU:
## Núcleos de CPU que usamos n_jobs
random = RandomForestClassifier(n_estimators = 100)
# criando objeto de RepeatedStratifiedKFold
cv = RepeatedStratifiedKFold(n_splits = 5, n_repetições = 3, random_state = 4)
# tempo de execução inicial
start_time = time()
n_scores = cross_val_score(aleatória,x,e,score='accurate', cv = cv, n_jobs = 1)
# hora de término da execução
end_time = time()
final_time = end_time-start_time
# mostrar o tempo de execução
imprimir('final execution time is : {}'.format(final_time))

Aqui vemos que com 1 núcleo são necessários em torno 10 segundos para correr, e este é um grande momento.
Nós não escrevemos o n_jobs dentro do RandomForestClassifier, em vez de escrevê-lo no cross_val_score porque nos ajuda a fazer validação cruzada usando RepeatedStratifiedKFold
Agora, usamos este mesmo código com uma pequena mudança para mais núcleos:
2 Núcleos de CPU:
## Núcleos de CPU que usamos n_jobs
random = RandomForestClassifier(n_estimators = 100)
# criando objeto de RepeatedStratifiedKFold
cv = RepeatedStratifiedKFold(n_splits = 5, n_repetições = 3, random_state = 4)
# tempo de execução inicial
start_time = time()
n_scores = cross_val_score(aleatória,x,e,score='accurate', cv = cv, n_jobs = 2) # 2 núcleos
# hora de término da execução
end_time = time()
final_time = end_time-start_time
# mostrar o tempo de execução
imprimir('final execution time is : {}'.format(final_time))

sim, aqui você pode ver qual é a diferença entre 1 núcleo e 2 núcleos, o tempo de execução é muito diferente de 1 núcleo.
3 Núcleos de CPU:
## Núcleos de CPU que usamos n_jobs
random = RandomForestClassifier(n_estimators = 100)
# criando objeto de RepeatedStratifiedKFold
cv = RepeatedStratifiedKFold(n_splits = 5, n_repetições = 3, random_state = 4)
# tempo de execução inicial
start_time = time()
n_scores = cross_val_score(aleatória,x,e,score='accurate', cv = cv, n_jobs = 3)   # 3 núcleos
# hora de término da execução
end_time = time()
final_time = end_time-start_time
# mostrar o tempo de execução
imprimir('final execution time is : {}'.format(final_time))

Pegue todos os núcleos:
## Núcleos de CPU que usamos n_jobs
random = RandomForestClassifier(n_estimators = 100)
# criando objeto de RepeatedStratifiedKFold
cv = RepeatedStratifiedKFold(n_splits = 5, n_repetições = 3, random_state = 4)
# tempo de execução inicial
start_time = time()
n_scores = cross_val_score(aleatória,x,e,score='accurate', cv = cv, n_jobs = -1) # todos os núcleos
# hora de término da execução
end_time = time()
final_time = end_time-start_time
# mostrar o tempo de execução
imprimir('final execution time is : {}'.format(final_time))

Comparação de tempo de núcleo:
## Núcleos de CPU que usamos n_jobs
para núcleo em [1,2,3,4,5,6,7,8,9,10]:
    random = RandomForestClassifier(n_estimators = 100)
    # criando objeto de RepeatedStratifiedKFold
    cv = RepeatedStratifiedKFold(n_splits = 5, n_repetições = 3, random_state = 4)
    # tempo de execução inicial
    start_time = time()
    n_scores = cross_val_score(aleatória,x,e,score='accurate', cv = cv, n_jobs = core)
    # hora de término da execução
    end_time = time()
    final_time = end_time-start_time
    # mostrar o tempo de execução
    imprimir('final execution time of core {} é : {}'.format(essencial,final_time))
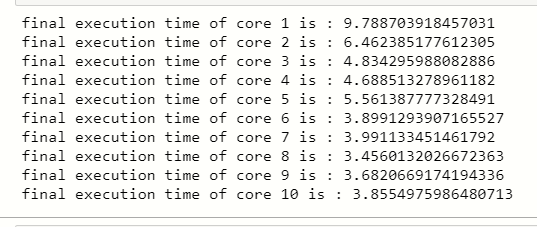
Você pode ver que há uma grande diferença quando usamos 1 núcleo para treinar nosso modelo de ML e 10 núcleos para treinar o modelo de ML.
Notas finais
Olá, neste artigo, você aprendeu o treinamento de modelos de ML usando núcleos de CPU, agora é a hora de implementar essa técnica em seu modelo de aprendizado de máquina para reduzir o tempo de execução.
Espero que você goste deste artigo., Compartilhe com seus amigos.
Você pode se conectar comigo no LinkedIn: www.linkedin.com/in/mayur-badole-189221199
Confira meus outros artigos: https://www.analyticsvidhya.com/blog/author/mayurbadole2407/
Obrigado.
A mídia mostrada neste artigo não é propriedade da DataPeaker e é usada a critério do autor.





