
Introdução
“Os dados são o combustível para algoritmos de aprendizado de máquina”.
Antes de procurar informações nos dados, primeiro temos que realizar tarefas de pré-processamento que só nos permitem usar esses dados para observação posterior e treinar nosso modelo de aprendizado de máquina.
A correção de valor ausente é necessária para reduzir o viés e produzir modelos adequados e poderosos. A maioria dos algoritmos não consegue lidar com dados perdidos, então você tem que agir de alguma forma para não deixar seu código travar. Então, vamos começar com os métodos para resolver o problema.
Métodos para lidar com valores ausentes
Exemplo 1, Vamos ter um conjunto de dados fictício em que existem três características independentes (preditores) e uma característica dependente (responder).
| Recurso-1 | Recurso-2 | Recurso-3 | Produção |
| Masculino | 23 | 24 | sim |
| – – – – | 24 | 25 | Não |
| Mulher | 25 | 26 | sim |
| Masculino | 26 | 27 | sim |
Aqui, temos um valor ausente na linha 2 para Feature-1.
Os métodos populares que a comunidade de aprendizado de máquina usa para lidar com o valor ausente de variáveis categóricas no conjunto de dados são os seguintes:
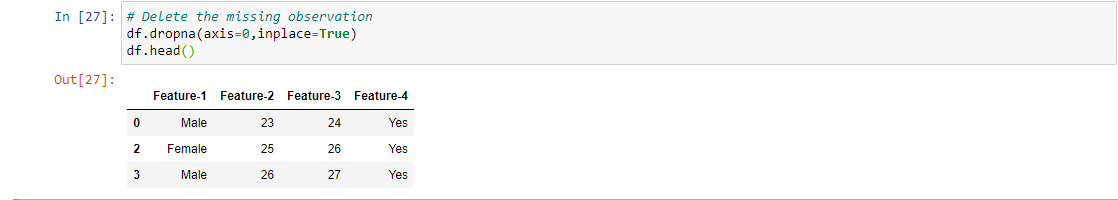
1. Exclua as observações: Se houver um grande número de observações no conjunto de dados, onde todas as classes a serem previstas são suficientemente representadas nos dados de treinamento, tente remover observações de valor faltante, o que não geraria mudanças significativas em seu feed a partir de seu modelo.
Por exemplo, 1, Implementar este método em um determinado conjunto de dados, podemos remover toda a linha que contém os valores ausentes (excluir linha 2).
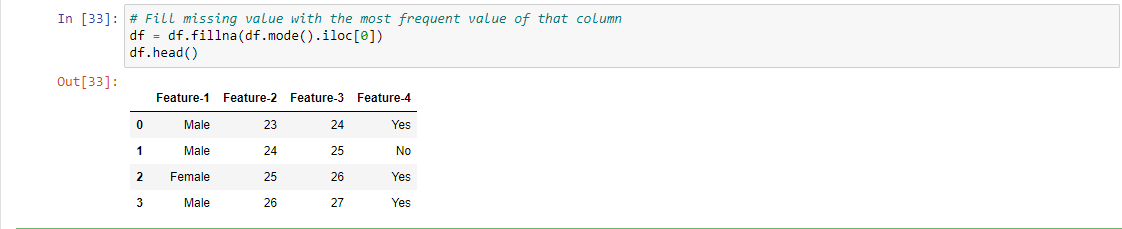
2. Substitua os valores ausentes pelo valor mais frequente: Você sempre pode cobrá-los com base em Caminho no caso de variáveis categóricas, certifique-se de não ter distribuições de classes muito distorcidas.
NOTA: Mas em alguns casos, esta estratégia pode tornar os dados desequilibrados nas classes wrt se houver muitos valores ausentes presentes em nosso conjunto de dados.
– Geralmente, substitua os valores ausentes pela média / medianaA mediana é uma medida estatística que representa o valor central de um conjunto de dados ordenados. Para calculá-lo, Os dados são organizados do menor para o maior e o número no meio é identificado. Se houver um número par de observações, Os dois valores principais são calculados em média. Este indicador é especialmente útil em distribuições assimétricas, uma vez que não é afetado por valores extremos.... / a moda é uma forma grosseira de lidar com valores ausentes. Dependendo do contexto, como si la variación es baja o si la variávelEm estatística e matemática, uma "variável" é um símbolo que representa um valor que pode mudar ou variar. Existem diferentes tipos de variáveis, e qualitativo, que descrevem características não numéricas, e quantitativo, representando quantidades numéricas. Variáveis são fundamentais em experimentos e estudos, uma vez que permitem a análise de relações e padrões entre diferentes elementos, facilitando a compreensão de fenômenos complexos.... tiene un apalancamiento bajo sobre la respuesta, essa aproximação aproximada é aceitável e pode dar resultados satisfatórios. Neste caso, já que você está dizendo que é uma variável categórica, esta etapa pode não ser aplicável.
Por exemplo, 1, Para implementar este método, substituímos o valor ausente pelo valor mais frequente para aquela coluna específica, aqui, substituímos o valor ausente por Masculino, uma vez que a contagem de Masculino é maior do que a de Feminino (Masculino = 2 e feminino = 1).
3. Desenvolva um modelo para prever valores ausentes: Uma maneira inteligente de fazer isso seria treinar um classificador em suas colunas de valores ausentes como uma variável dependente em relação a outras características em seu conjunto de dados e tentar imputar com base no classificador recém-treinado.
Aqui está o algoritmo que você pode seguir:
– Divida os dados em duas partes. Uma parte terá os valores atuais da coluna, incluindo coluna de saída original, a outra parte terá as linhas com os valores ausentes.
– Divida a 1ª parte (valores atuais) em um conjunto de validação cruzada para seleção de modelo.
– Treine seus modelos e teste suas métricas com dados de validação cruzada. Você também pode realizar uma pesquisa em grade ou uma pesquisa aleatória para obter os melhores resultados.
– Finalmente, com o modelo, prevê valores desconhecidos ausentes em nosso problema.
NOTA: Uma vez que você está tentando imputar valores ausentes, as coisas serão mais agradáveis assim, uma vez que eles não são tendenciosos e você obtém as melhores previsões do melhor modelo.
Por exemplo, 1, Para implementar a estratégia dada, primeiro vamos considerar a coluna Característica-2, Recurso-3 e saída para nosso novo classificador, o que significa que você é 3 As colunas são usadas como características independentes para o nosso novo classificador e a Característica-1 é considerada um resultado e uma nota objetiva que aqui consideramos apenas as linhas que não estão faltando, uma vez que nossos dados de trem e observações que têm um valor ausente se tornarão nossos dados de teste. Temos que fazer a previsão usando nosso modelo nos dados de teste e, depois das previsões, temos o conjunto de dados que não está faltando nenhum valor.
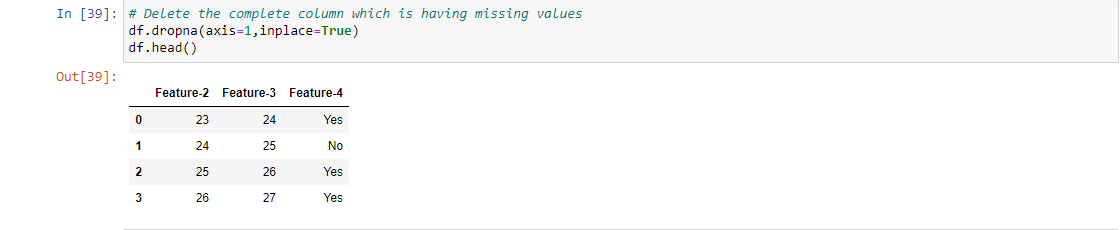
4. Eliminando a variável: Se houver um conjunto excepcionalmente maior de valores ausentes, tente excluir a própria variável para um modelo adicional, mas você tem que se certificar de que não é muito significativo prever a variável de destino, quer dizer, a correlação entre a variável descartada e a variável alvo é muito baixa ou redundante.
Por exemplo, 1, Para implementar esta estratégia para lidar com valores ausentes, temos que remover toda a coluna que contém os valores ausentes, então, para um determinado conjunto de dados, removemos a Característica-1 completamente e usamos apenas as características à esquerda para prever nossa variável alvo.
5. Aplicar técnicas de aprendizado de máquina não supervisionadas: Nesta abordagem, usamos técnicas não supervisionadas, como K-means, Agrupamento hierárquico, etc. A ideia é que você pode pular as colunas que têm valores ausentes e considerar todas as outras colunas, exceto a coluna de destino e tentar criar tantos quanto nenhum cluster de características independentes (depois de remover as colunas de valor em falta), finalmente encontre a categoria em que a linha que falta se encaixa.
Por exemplo, 1, Para implementar esta estratégia, eliminamos a coluna Característica-1 e, em seguida, usamos a Característica-2 e a Característica-3 como nossas características para o novo classificador e, em seguida,, Finalmente, depois de la formación del cachoUm cluster é um conjunto de empresas e organizações interconectadas que operam no mesmo setor ou área geográfica, e que colaboram para melhorar sua competitividade. Esses agrupamentos permitem o compartilhamento de recursos, Conhecimentos e tecnologias, Promover a inovação e o crescimento económico. Os clusters podem abranger uma variedade de setores, Da tecnologia à agricultura, e são fundamentais para o desenvolvimento regional e a criação de empregos...., tentamos ver em qual cluster o registro ausente está e estamos prontos com nosso conjunto de dados final para análise posterior.
Implementação Python
Importe as dependências necessárias.

Carregue e leia o conjunto de dados.

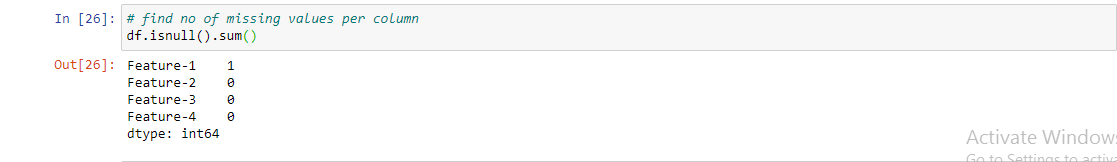
Encontre o número de valores ausentes por coluna.
Aplicar estratégia-1 (remover observações faltantes).
Aplicar Estratégia-2 (Substitua os valores ausentes pelo valor mais frequente).
Aplicar Estratégia-3 (Remova a variável que tem valores ausentes).
Aplicar a estratégia 4 (Desenvolva um modelo para prever valores ausentes).
Para esta estratégia, primeiro, codificamos nossas colunas categóricas independentes usando "One Hot Encoder" e colunas categóricas dependentes usando "Label Encoder".
– Leia e carregue o conjunto de dados codificado.
– Faça registros ausentes, como nossos dados de teste.
– Haga registos que no falten como os nossos dados de TreinamentoO treinamento é um processo sistemático projetado para melhorar as habilidades, Conhecimento ou habilidades físicas. É aplicado em várias áreas, como esporte, Educação e desenvolvimento profissional. Um programa de treinamento eficaz inclui planejamento de metas, prática regular e avaliação do progresso. A adaptação às necessidades individuais e a motivação são fatores-chave para alcançar resultados bem-sucedidos e sustentáveis em qualquer disciplina.....
– Variáveis independentes e dependentes separadas.

– Ajustar nosso modelo de regressão logística.
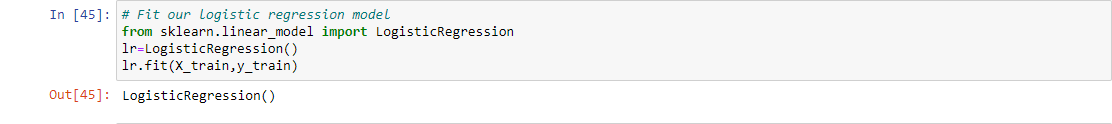
– Preveja a classe de registros perdidos.

Isso conclui nossa parte de implementação!!
Notas finais
Obrigado pela leitura!
Este artigo apresenta diferentes maneiras de abordar o problema de ter valores ausentes para variáveis categóricas..
Se gostou e quer saber mais, visite meus outros artigos sobre ciência de dados e aprendizado de máquina clicando no link
Sinta-se à vontade para entrar em contato comigo em Linkedin, Correio eletrônico.
Qualquer coisa não mencionada ou você deseja compartilhar suas idéias? Sinta-se à vontade para comentar abaixo e eu entrarei em contato com você.
Até então, fique em casa, fique seguro para evitar a propagação de COVID-19, E continue aprendendo!
Sobre o autor
Chirag Goyal
Atualmente, Estou cursando bacharelado em tecnologia (B.Tech) em Ciência da Computação e Engenharia da o Instituto Indiano de Tecnologia de Jodhpur (IITJ). Estou muito animado com o aprendizado de máquina, a aprendizado profundoAqui está o caminho de aprendizado para dominar o aprendizado profundo em, Uma subdisciplina da inteligência artificial, depende de redes neurais artificiais para analisar e processar grandes volumes de dados. Essa técnica permite que as máquinas aprendam padrões e executem tarefas complexas, como reconhecimento de fala e visão computacional. Sua capacidade de melhorar continuamente à medida que mais dados são fornecidos a ele o torna uma ferramenta fundamental em vários setores, da saúde... e inteligência artificial.
A mídia mostrada neste artigo não é propriedade da DataPeaker e é usada a critério do autor.





