
Dieser Artikel wurde im Rahmen der Data Science Blogathon
Einführung
Wenn Sie diesen Artikel lesen, Ich vermute, Sie sind bereits in der Welt der Data Science und haben eine Vorstellung von Machine Learning. Wenn dies nicht der Fall ist, Kein Problem. Ich werde mit den grundlegenden Terminologien beginnen, die Sie kennen müssen, bevor Sie sie verstehen das Hauptthema der Diskussion, nämlich, lineare Regression.
In diesem Artikel erfahren Sie alles, was Sie über die lineare Regression wissen müssen., der erste Algorithmus für maschinelles Lernen in der Datenwissenschaft.
Inhaltsverzeichnis
- Kurze Einführung in maschinelles Lernen und seine Arten
- Lineare Regression verstehen
- Annahmen zur linearen Regression.
- Umgang mit der Verletzung der Annahmen
- Bewertungsmetriken für Regressionsprobleme
Einführung in das maschinelle Lernen
Machine Learning ist ein Zweig der künstlichen Intelligenz (ER) konzentriert sich auf die Entwicklung von Anwendungen, die aus Daten lernen und die Genauigkeit im Laufe der Zeit verbessern, ohne dafür programmiert zu sein.
Arten des maschinellen Lernens:
Überwachtes maschinelles Lernen: Es ist eine ML-Technik, bei der Modelle mit gekennzeichneten Daten trainiert werden, nämlich, se proporciona una VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... de salida en este tipo de problemas. Hier, Modelle finden Mapping-Funktion, um Eingabevariablen auf Ausgabevariablen oder Labels abzubilden.
Regression und Klassifizierung Probleme sind Teil des überwachten maschinellen Lernens.
Unüberwachtes maschinelles Lernen: Es ist die Technik, bei der die Modelle die gekennzeichneten Daten nicht erhalten und die Muster und die Struktur in den Daten finden müssen, um die Daten zu kennen.
Gruppierung und Assoziation Algorithmen sind Teil der unbeaufsichtigten ML.
Lineare Regression verstehen
In den einfachsten Worten Lineare Regression ist das Modell des überwachten maschinellen Lernens, in dem das Modell findet die lineare Best-Fit-Linie zwischen der unabhängigen und der abhängigen Variablen nämlich, finde die lineare Beziehung zwischen den abhängigen und unabhängigen Variablen.
Es gibt zwei Arten der linearen Regression: Einfach und mehrfach. Einfache lineare Regression ist, wenn nur eine unabhängige Variable vorhanden ist und das Modell seine lineare Beziehung zu der abhängigen Variablen finden muss
Während in Multiple lineare Regression Es gibt mehr als eine unabhängige Variable für das Modell, um die Beziehung zu finden.
Einfache lineare Regressionsgleichung, wo bÖ ist die Kreuzung, B1 ist Koeffizient oder Steigung, x ist die unabhängige Variable und y ist die abhängige Variable.
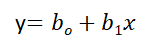

Mehrfache lineare Regressionsgleichung, wo bÖ ist die Kreuzung, B1,B2,B3,B4…,BNorden sind Koeffizienten oder Steigungen der unabhängigen Variablen x1,x2,x3,x4…,xNorden und y ist die abhängige Variable.
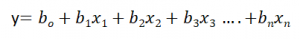

Das Hauptziel eines linearen Regressionsmodells besteht darin, die am besten passende lineare Linie und die optimalen Werte von Schnittpunkt und Koeffizienten so zu finden, dass der Fehler minimiert wird.
Der Fehler ist die Differenz zwischen dem tatsächlichen Wert und dem vorhergesagten Wert und das Ziel besteht darin, diese Differenz zu reduzieren.
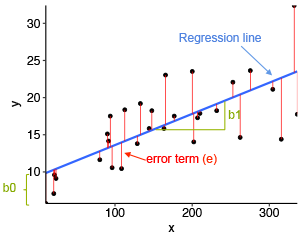
Lassen Sie uns dies mit Hilfe eines Diagramms verstehen.
Bildquelle: Statistiktools für leistungsstarke Datenanalyse
Im Diagramm oben,
- x ist unsere abhängige Variable, die auf der x-Achse aufgetragen ist und y ist die abhängige Variable, die auf der y-Achse aufgetragen ist.
- Die schwarzen Punkte sind die Datenpunkte, nämlich, die tatsächlichen Werte.
- BÖ ist der Schnittpunkt 10 und B1 ist die Steigung der Variablen x.
- Die blaue Linie ist die vom Modell vorhergesagte Linie der besten Anpassung, nämlich, prognostizierte Werte sind auf der blauen Linie.
Der vertikale Abstand zwischen dem Datenpunkt und der Regressionsgerade wird als Fehler oder Residuum bezeichnet. Jeder Datenpunkt hat einen Rest und die Summe aller Differenzen ist bekannt als die Summe der Residuen / Fehler.
Mathematischer Ansatz:
Restwert / Fehler = Istwerte – Vorhergesagte Werte
Summe der Residuen / Fehler = Summe (erwartete Ist-Werte)
Quadrat der Summe der Residuen / Fehler = (Summe (erwartete Ist-Werte))2
nämlich
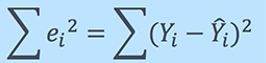
Für ein tiefes Verständnis der Mathematik hinter der linearen Regression, siehe Anhang Videoerklärung.
Annahmen zur linearen Regression
Die Grundannahmen der linearen Regression lauten wie folgt:
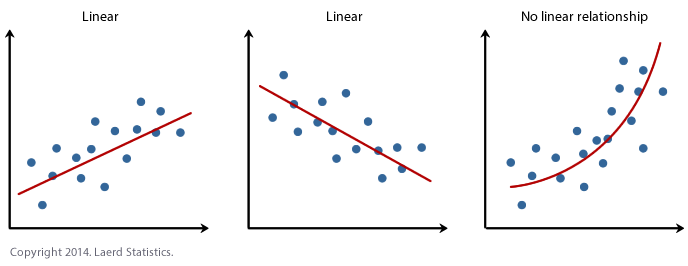
1. Linearität: Legt fest, dass die abhängige Variable Y linear zu den unabhängigen Variablen stehen muss. Diese Annahme kann durch Zeichnen eines Streudiagramms zwischen beiden Variablen überprüft werden.
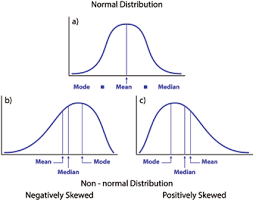
2. Normal: Die Variablen X und Y müssen eine Normalverteilung haben. Histogramme können verwendet werden, KDE-Graphen und QQ-Graphen zur Überprüfung der Normalitätsannahme.
In meinem angehängten Blog finden Sie eine detaillierte Erklärung zum Überprüfen der Normalität und zum Transformieren von Variablen, die gegen die Annahme verstoßen.
Quelle: https://heljves.com/gallery/vol_1_issue_1_2019_8.pdf
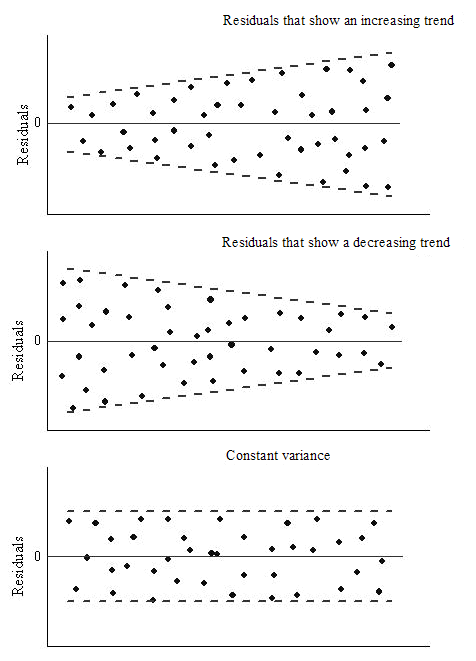
3. Homoskedastizität: Die Varianz der Fehlerterme muss konstant sein, nämlich, die Streuung der Residuen muss für alle Werte von X . konstant sein. Diese Annahme kann durch Zeichnen eines Residuengraphen verifiziert werden. Wenn die Annahme verletzt ist, die Punkte bilden eine Trichterform, sonst bleiben sie konstant.
Quelle: OriginLab
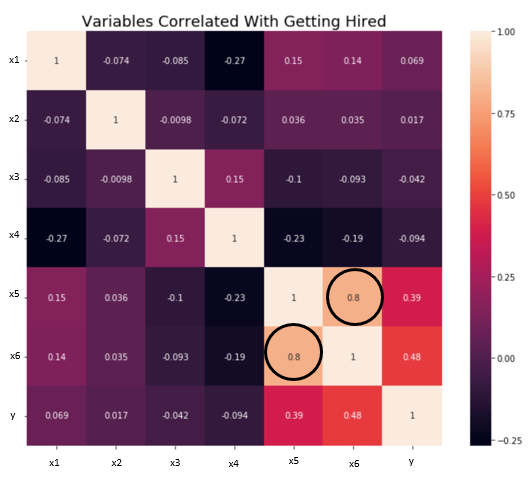
4. Die Unabhängigkeit / Keine Multikollinearität: Die Variablen müssen voneinander unabhängig sein, nämlich, es sollte keine Korrelation zwischen den unabhängigen Variablen bestehen. Um die Annahme zu überprüfen, wir können eine Korrelationsmatrix oder einen VIF-Score verwenden. Wenn der VIF-Wert größer ist als 5, die Variablen sind stark korreliert.
Im Bild unten, es besteht eine hohe Korrelation zwischen den Variablen x5 und x6.
Quelle: in Richtung Data Science
5. das Fehlerterme sollten normal verteilt werden. QQ-Diagramme und Histogramme können verwendet werden, um die Verteilung von Fehlertermen zu überprüfen.
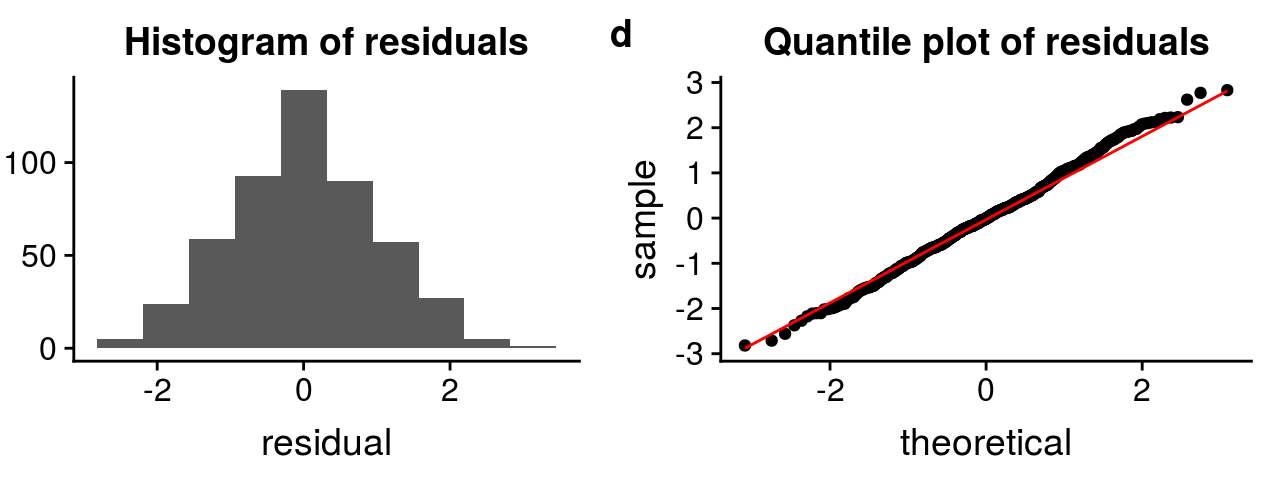
Quelle: http://rstudio-pubs-static.s3.amazonaws.com
6. Keine Autokorrelation: Die Fehlerterme müssen voneinander unabhängig sein. Autokorrelation kann mit dem Durbin Watson-Test getestet werden. Die Nullhypothese geht davon aus, dass keine Autokorrelation vorliegt. Der Wert des Tests liegt zwischen 0 Ja 4. Ist der Testwert 2, keine Autokorrelation.
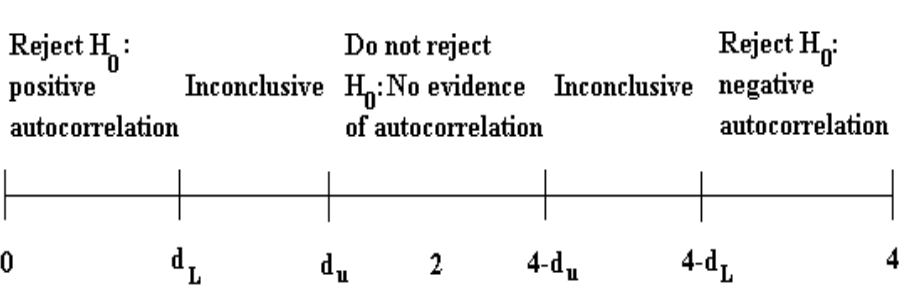
Quelle: itfeature.com
Wie man mit der Verletzung einer der Annahmen umgeht
Eine Verletzung der Annahmen führt zu einer Verringerung der Genauigkeit des Modells, die Vorhersagen sind also nicht genau und der Fehler ist auch hoch.
Zum Beispiel, wenn die Unabhängigkeitsannahme verletzt wird, der Zusammenhang zwischen unabhängiger und abhängiger Variable kann nicht genau bestimmt werden.
Es stehen verschiedene Methoden und Techniken zur Verfügung, um mit der Verletzung der Annahmen umzugehen. Lassen Sie uns einige von ihnen unten analysieren.
Verletzung der Annahme der Normalität von Variablen oder Fehlertermen
Um dieses Problem zu behandeln, Wir können die Variablen mit verschiedenen Transformationsfunktionen wie der logarithmischen Transformation in die Normalverteilung transformieren, Reziproke Box-Cox-Transformation.
Alle Funktionen werden in diesem Artikel von mir besprochen: So transformieren Sie in die Normalverteilung
Verletzung der Multikollinearitätsannahme
Es kann behandelt werden durch:
- Nichts tun (wenn kein großer Unterschied in der Präzision besteht)
- Eliminieren einiger der stark korrelierten unabhängigen Variablen.
- Leiten Sie eine neue Kennlinie ab, indem Sie die unabhängigen Variablen linear kombinieren, wie man sie hinzufügt oder eine mathematische Operation durchführt.
- Durchführung einer Analyse für hochkorrelierte Variablen, wie Hauptkomponentenanalyse.
Bewertungsmetriken für die Regressionsanalyse
Um die Leistung des Regressionsmodells zu verstehen, eine Evaluation des Modells ist notwendig. Einige der Bewertungsmetriken, die für die Regressionsanalyse verwendet werden, sind:
1. R zum Quadrat oder Bestimmtheitsmaß: Die am häufigsten verwendete Metrik für die Modellbewertung in der Regressionsanalyse ist R quadriert. Es kann als Verhältnis der Variation zur Gesamtvariation definiert werden. Der Wert von R zum Quadrat liegt zwischen 0 Ja 1, je näher an 1, desto besser das Modell.
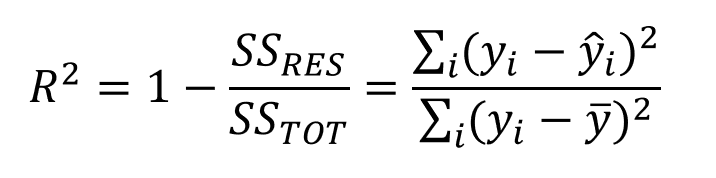
Quelle: medium.datadriveninvestor.com
wobei SSRES die Residualsumme der Quadrate und SSOT die Gesamtsumme der Quadrate ist
2. R im Quadrat montiert: Es ist die Verbesserung von R zum Quadrat. Das Problem / Nachteil von R2 ist, dass mit zunehmenden Funktionen, der Wert von R2 steigt auch, was die Illusion eines guten Modells erweckt. Dann, Angepasstes R2 löst das R2-Problem. Es berücksichtigt nur die für das Modell wichtigen Merkmale und zeigt die tatsächliche Verbesserung des Modells auf.
Angepasstes R2 ist immer kleiner als R2.
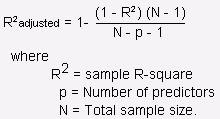
Quelle: statistik.stackexchange.com
3. Quadratischer Fehler (MSE): Ein weiteres gängiges Maß für die Bewertung ist der quadratische Mittelwertfehler., das ist der Mittelwert der quadrierten Differenz der realen Werte gegenüber den vorhergesagten.
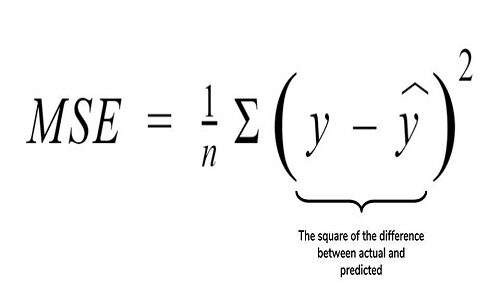
Quelle: cppsecrets.com
4. Quadratischer Fehler (RMSE): Es ist die Wurzel von MSE, nämlich, die Wurzel der mittleren Differenz der tatsächlichen und vorhergesagten Werte. RMSE bestraft große Fehler, während MSE dies nicht tut.
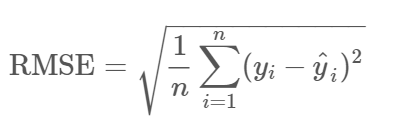
Quelle: community.qlik.com
Abschließende Anmerkungen
Wir haben die meisten Konzepte von Regressionsmodellen in diesem Blog behandelt.. Wenn Sie mehr über die Mathematik hinter dem Modell erfahren möchten, siehe die Links zum Blog.
Bitte, melde dich gerne bei mir LinkedIn und teile deinen wertvollen Input. Bitte, schau dir meine anderen Artikel hier an.
Über den Autor :
Soja Deepanshi Dhingra, Ich arbeite derzeit als Data Science Researcher und habe einen Hintergrund in Analytik, explorative Datenanalyse, aprendizaje automático y tiefes LernenTiefes Lernen, Eine Teildisziplin der Künstlichen Intelligenz, verlässt sich auf künstliche neuronale Netze, um große Datenmengen zu analysieren und zu verarbeiten. Diese Technik ermöglicht es Maschinen, Muster zu lernen und komplexe Aufgaben auszuführen, wie Spracherkennung und Computer Vision. Seine Fähigkeit, sich kontinuierlich zu verbessern, wenn mehr Daten zur Verfügung gestellt werden, macht es zu einem wichtigen Werkzeug in verschiedenen Branchen, von Gesundheit....
Dieser Artikel wurde im Rahmen der Data Science Blogathon





