
vor dem Fortfahren, lass uns kurz analysieren Abgekratzt und später AutoScraper:
Was ist kratzen?
Web-Scraping ist eine grundlegende Technik, um nützliche Informationen wie Kontakte zu extrahieren, E-Mails, Bilder, URL, etc ... der Webseiten. Die andere Form des Web-Scrapings ist das Crawlen. Wird verwendet, wenn wir eine große Menge strukturierter und gekennzeichneter Daten für industrielle Grundlagen benötigen. Web-Scraping-Software kann über HTML-Protokolle direkt auf das World Wide Web zugreifen.
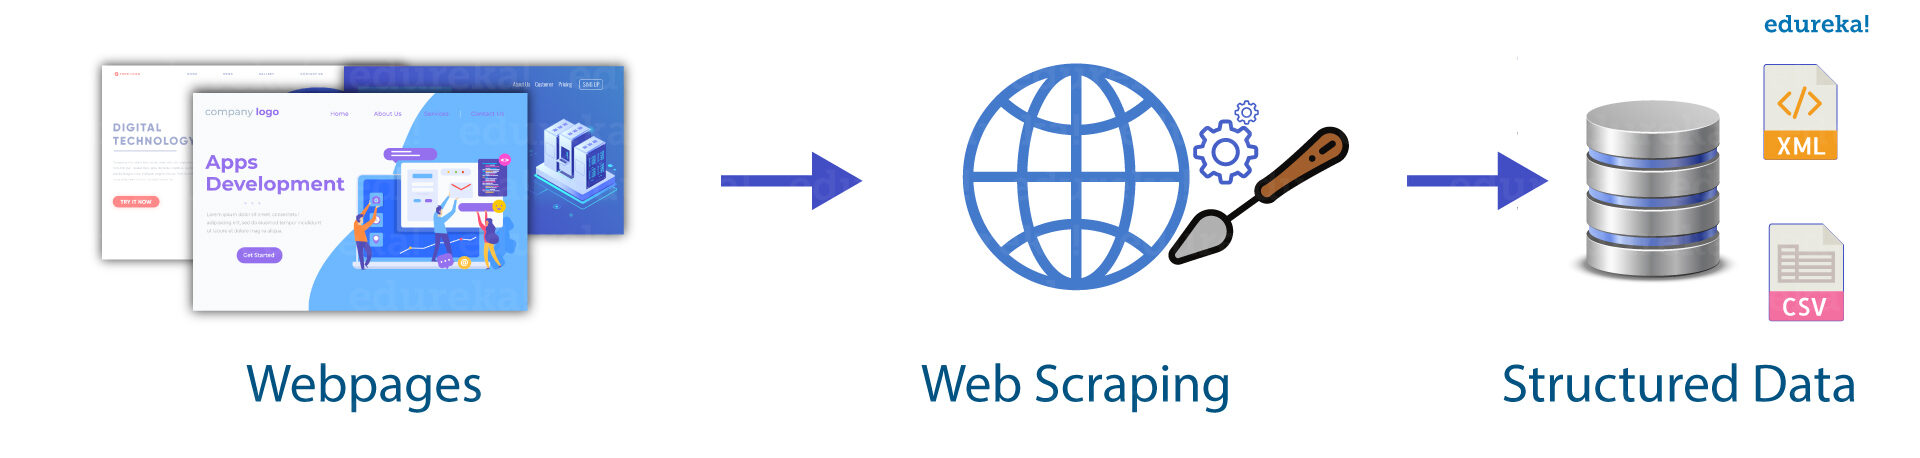
Sie wissen, dass neue Formen des Web-Scrapings die Beobachtung des Datenfeeds auf Webservern beinhalten, zum Beispiel, eine Datei JSONJSON, o JavaScript-Objekt-Notation, Es handelt sich um ein leichtgewichtiges Datenaustauschformat, das für Menschen leicht zu lesen und zu schreiben ist, und für Maschinen einfach zu analysieren und zu generieren. Es wird häufig in Webanwendungen verwendet, um Informationen zwischen einem Server und einem Client zu senden und zu empfangen. Seine Struktur basiert auf Schlüssel-Wert-Paaren, Dadurch ist es vielseitig einsetzbar und in der Softwareentwicklung weit verbreitet.. die als Überträger zwischen dem Client und dem Webserver verwendet wird.
Es gibt viele große Websites, die Google, Facebook, Amazonas, etc. APIs bereitstellen, mit denen Sie auf Ihre Daten in einem strukturierten oder gekennzeichneten Format zugreifen können.
Jetzt, wir analysieren kurz die AutoScraper-Bibliothek:
Was ist AutoScraper??
Wenn wir über Kratzen sprechen, Es gibt viele Dinge auf der Website, die wir entfernen möchten, aber beschreibbare Skripte brauchen lange, um Daten zu entfernen, und es ist ein sehr langer Prozess, um dieses Problem zu überwinden, eine Gruppe von Python-Entwicklern entwickelt eine Bibliothek. wodurch alle Daten einer Website auf einfache Weise extrahiert werden. Dann AutoScraper ist eine Web-Scraping-Python-Bibliothek, mit der Daten auf einfache Weise von einer Website gescrapt werden können, einfach und schnell. Es hat eine benutzerfreundliche Umgebung mit diesem Schaber, mit dem Sie leicht mit dieser Bibliothek interagieren können.
Verwendet Website-URLs und HTML-Inhalte, um zuverlässige Informationen und Daten zu extrahieren.
Zu beachtender Punkt: Lernen Sie die Scraping-Regeln und geben Sie ähnliche Artikel in gutem Format zurück.
Es ist einfach, Website-Inhalte zu entfernen, die als Titel leicht zu überprüfen waren, Preis, Name, Bewertungen, etc. Warte eine Minute! Was machen wir mit den Bildern? Es ist eine große Frage, die sich stellt, wir können das Bild während der Ausführung des Programms geben😅. Ich finde eine Möglichkeit, Bilder von Websites zu entfernen. Lass uns unten analysieren:
Zuerst, Los geht's mit der Installation dieser Bibliothek:
AutoScraper installieren
Es gibt zwei Möglichkeiten, AutoScraper zu installieren:
Verwenden von pip: –
Geben Sie den folgenden Code an der Eingabeaufforderung ein,
Pip Autoscraper installieren
oder mit dem Git-Repository,
clon de git https://github.com/brandonrobertz/autoscrape-py
cd autoscrape-py /
pip installieren.[alle]
Jetzt importieren wir wichtige Module:
Modulimport
# AutoScraper importieren
aus Autoscraper importieren AutoScraper
Hier importieren wir die AutoScraper-Klasse aus der Bibliothek.
Jetzt füttern wir die URL an die AutoScraper-Funktion, um mit dem Scrapen fortzufahren:
URL: – https://www.bookswagon.com/
Hier füttern wir die E-Commerce-Website-URL an die AutoScraper-Klasse, um die Buchbilder zu extrahieren oder zu verkratzen.
Jetzt, bevor du weitermachst, Wir sehen die Demo zuerst, indem wir Buchtitel und Preise kratzen, um ein besseres und grundlegendes Verständnis des Kratzcodes zu erhalten:
Scraping-Demo
Jetzt, Wir werden die Liste der zu kratzenden Gegenstände füttern, Also müssen wir zuerst die AutoScraper-Klasse mit ihrem Objekt initialisieren:
Fahndungsliste:
eine Liste mit Elementen erstellen
# eine Liste von Elementen erstellen
Gegenstände = [Rs.349 , Das Geheimnis der Nagas]
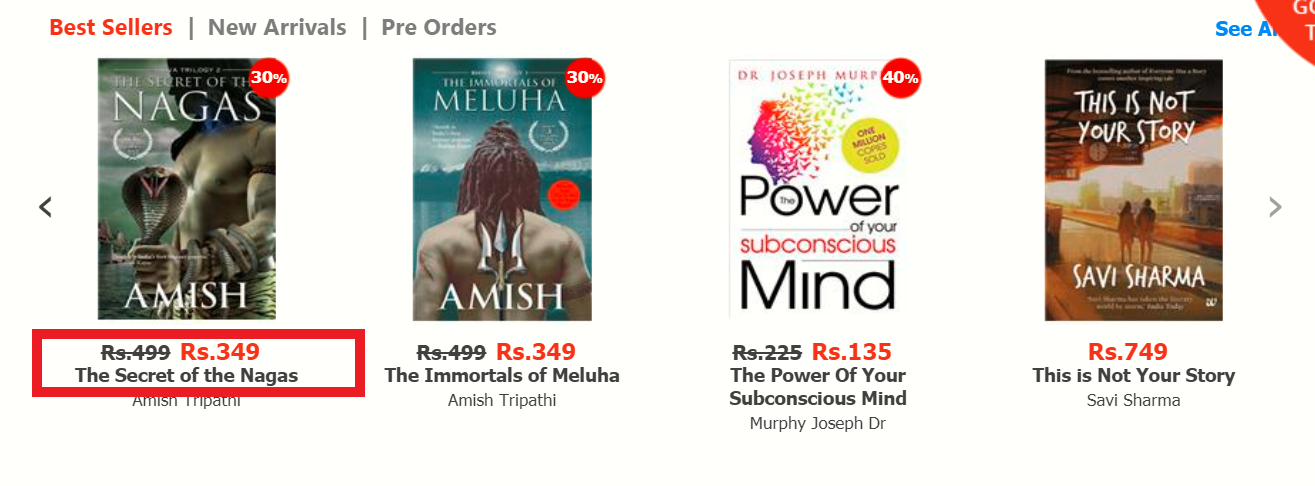
Objekterstellung:
# Objekt erstellen
kratzen = AutoScraper()
# Fütterung zum Schaben
final_result = scratche.build(URL,Produkte)
# Ergebnis anzeigen
drucken(Endergebnis)
Zeit das Bild zu löschen
Jetzt, eine Idee zum Web-Scraping-Code haben, den wir zuvor besprochen haben, Daher verwenden wir dieselbe Methode, um Website-Bilder mit einigen Änderungen abzukratzen. Deswegen, wir werden die Methode oder Technik besprechen, um die Bilder aus den Daten zu extrahieren. mal sehen als nächstes:
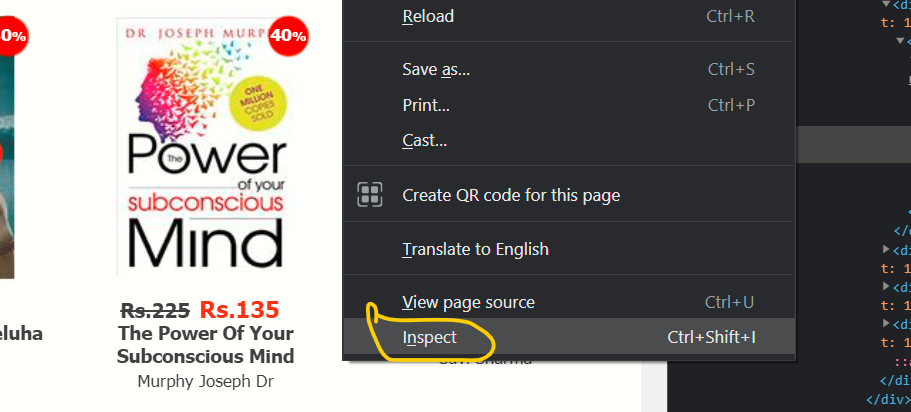
Paso 1:
Im ersten Schritt, Wir müssen mit der rechten Maustaste klicken und dann die Prüfoption aus der Menüliste auswählen:
Paso 2:
Nach Auswahl der Prüfoption, neben dem Bildschirm öffnet sich eine Seite mit HTML-Inhalten, dann schwebt es über dem Buchbild; in diesem Moment, Beachten Sie auf der HTML-Inhaltsseite, dass Sie die Bild URL.
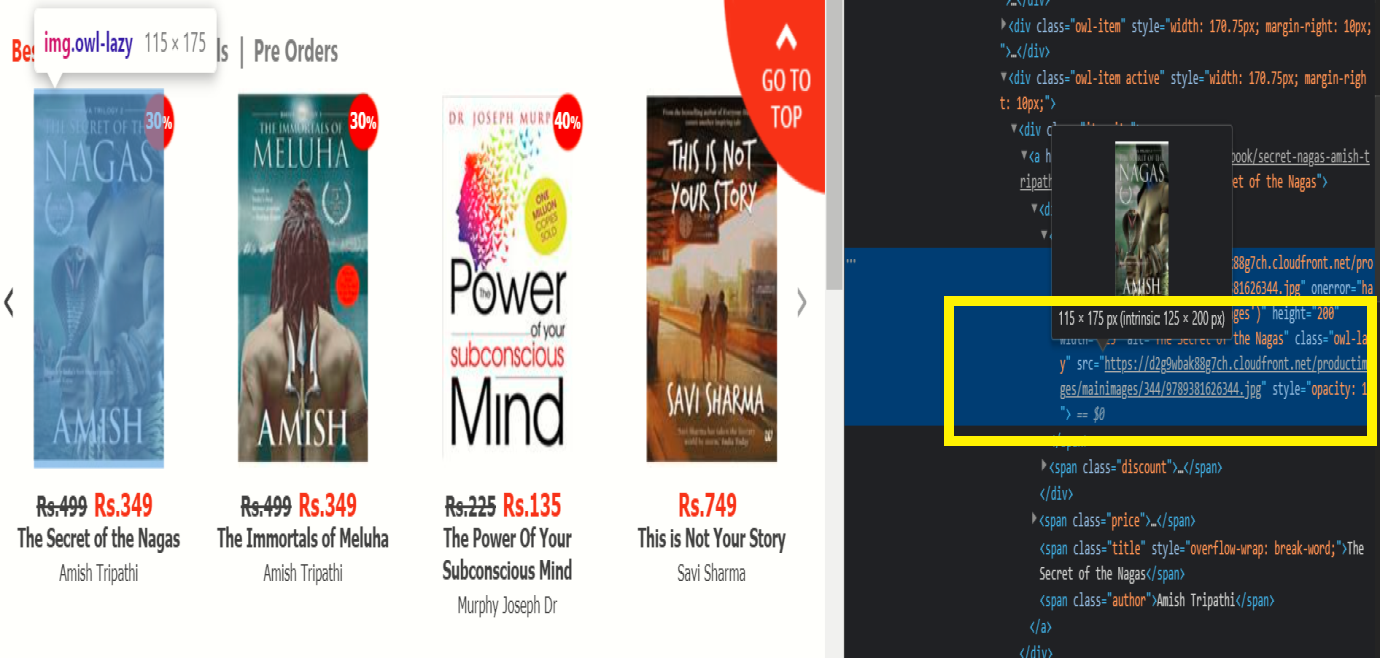
Wenn Sie die URL des jeweiligen Bildes finden, kopiere es und wir werden es in der Wunschliste verwenden. Dies ist nur die Änderung, die erforderlich ist, um die Bilder von der Website zu entfernen.
Paso 3:
Jetzt, Wir werden diese Bild-URL zusammen mit den Büchern konfigurieren, die in unsere Suchliste aufgenommen wurden,
Artikel = ['https://d2g9wbak88g7ch.cloudfront.net/productimages/mainimages/344/9789381626344.jpg,Dies ist nicht deine Geschichte]
Nach dem Erstellen einer Liste, wir machen den gleichen Prozess wie oben:
# Objekt erstellen
kratzen = AutoScraper()
# building result
final_result = scrap.build( URL, Artikel )
# Ergebnis anzeigen
drucken(Endergebnis)
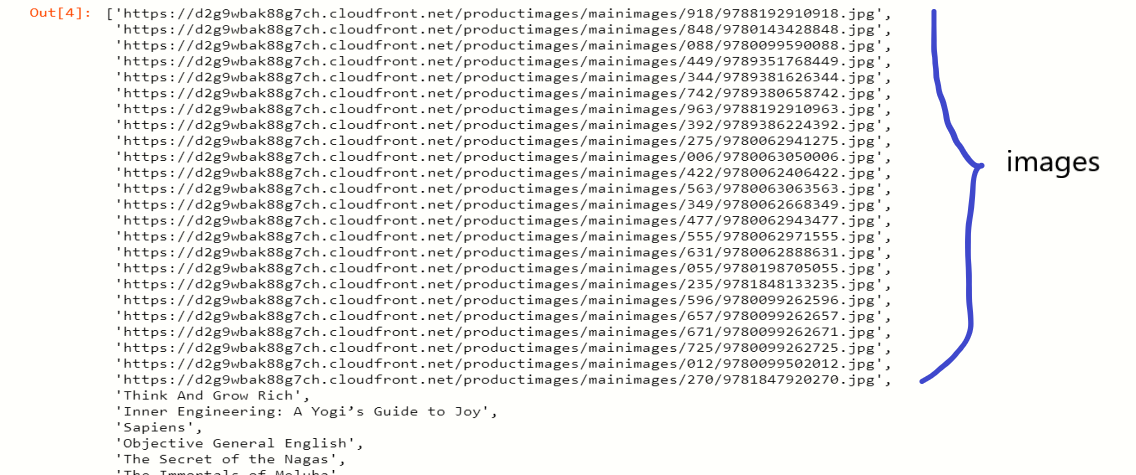
Notiz: Verwenden Sie die Bilder-URL, um die Bilder von der Website zu extrahieren
Dann, Dies ist der Prozess, um Bilder von jeder Website zu kratzen.
Schlussbemerkung
Dann, hier werden wir das Bild-Scraping von Websites besprechen, wenn Sie Bilder von der Website entfernen möchten, benutze diese Technik. Ich bin sehr überrascht, diese AutoViz-Bibliothek zu verwenden. Ich hoffe, Ihnen hat dieser Artikel gefallen und danke, dass Sie diesen Artikel gelesen haben.
Sie können sich mit mir auf Linkedin verbinden: Profil-URL
Lesen Sie auch meine anderen Artikel: https://www.analyticsvidhya.com/blog/author/mayurbadole2407/
Dankeschön.
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





