
R Sind Sie bereit? Lass uns lernen, in R zu gruppieren.
http: // www.SeiteS: //www.rstudio.com/products/rstudio/download/
Datenvisualisierung mit R
In der heutigen Zeit, Bilder sprechen mehr als Zahlen oder Wortanalysen. Jawohl, Grafiken und Diagramme sind für das menschliche Auge attraktiver und leichter zu erkennen. Hier kommt die Bedeutung der R-Datenanalyse ins Spiel.. Kunden verstehen die grafische Darstellung ihres Wachstums besser / Auswertung / Produktverteilung. Deswegen, Data Science boomt heutzutage und R ist eine dieser Sprachen, die Flexibilität beim Plotten und Grafik bieten, da es spezielle Funktionen und Pakete für solche Aufgaben hat. RStudio ist eine Software, bei der Daten und Visualisierung Seite an Seite stattfinden, was es für einen Datenanalysten sehr günstig macht. Streudiagramme, BoxplotsBox-Diagramme, Auch bekannt als Box- und Whisker-Diagramme, sind statistische Werkzeuge, die die Verteilung eines Datensatzes darstellen. Diese Diagramme zeigen den Median, Quartile und Ausreißer, Ermöglicht die Visualisierung von Datenvariabilität und -symmetrie. Sie sind nützlich für den Vergleich zwischen verschiedenen Gruppen und in der explorativen Analyse, So lassen sich Trends und Muster in den Daten leichter erkennen...., Balkendiagramme, Liniendiagramme, Liniendiagramme, Heatmaps, etc. sind in R mit nur einer einfachen Funktion möglich, zum Beispiel: das Histogramm kann mit der hist-Funktion gezeichnet werden (Datenname) mit ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten.... Wie xlab (x-Tag), Farbe, sollte, etc.
Diesen Komfort nutzen, Kommen wir zu einer Methode der Unüberwachtes LernenUnüberwachtes Lernen ist eine Technik des maschinellen Lernens, die es Modellen ermöglicht, Muster und Strukturen in Daten ohne vordefinierte Beschriftungen zu identifizieren. Durch Algorithmen wie k-means und Hauptkomponentenanalyse, Dieser Ansatz wird in einer Vielzahl von Anwendungen eingesetzt, wie z. B. Kundensegmentierung, Anomalieerkennung und Datenkomprimierung. Seine Fähigkeit, verborgene Informationen preiszugeben, macht es zu einem wertvollen Werkzeug in der...: Clusterbildung.
Überwachtes und unüberwachtes Lernen
Es gibt zwei Arten des Lernens in der Datenanalyse: überwachtes LernenÜberwachtes Lernen ist ein Ansatz des maschinellen Lernens, bei dem ein Modell mit einem Satz von beschrifteten Daten trainiert wird. Jede Eingabe im Dataset ist mit einer bekannten Ausgabe verknüpft, So kann das Modell lernen, Ergebnisse für neue Eingaben vorherzusagen. Diese Methode wird häufig in Anwendungen wie der Bildklassifizierung eingesetzt., Spracherkennung und Trendvorhersage, und unterstreicht seine Bedeutung in... und unbeaufsichtigt.
Überwachtes Lernen – Die markierten Daten sind eine Eingabe für die lernende Maschine. Rückschritt, die Klassifizierung, Entscheidungsbäume, etc. sind überwachte Lernmethoden.
Beispiel für betreutes Lernen:
Lineare Regression liegt vor, wenn es nur eine gibt VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... abhängig. Gleichung: y = mx + C, y hängt von x . ab.
Zum Beispiel: das Alter und der Umfang eines Baumes sind die 2 Labels als Eingabedatensatz, die Maschine muss das Alter eines Baumes mit einem Umfang als Eingabe vorhersagen, nachdem sie den eingegebenen Datensatz kennt. Alter abhängig vom Umfang.
Deswegen, Lernen wird anhand von Tags überwacht.
Unbeaufsichtigtes Lernen – Ungetaggte Daten werden an die Maschine gesendet, um selbst ein Muster zu finden. Clustering ist eine unüberwachte Lernmethode mit Modellen: KMeans, hierarchische Gruppierung, DBSCAN, etc.
Die visuelle Darstellung der Cluster zeigt die Daten in einem leicht verständlichen Format, da es Elemente eines großen Datensatzes nach ihren Ähnlichkeiten gruppiert. Das erleichtert die Analyse. Aber trotzdem, unüberwachtes Lernen ist nicht immer genau und ein komplexer Prozess für die Maschine, da die Daten nicht beschriftet sind.
Fahren wir nun mit einem Beispiel fort für GruppierungDas "Gruppierung" Es handelt sich um ein Konzept, das sich auf die Organisation von Elementen oder Individuen in Gruppen mit gemeinsamen Merkmalen oder Zielen bezieht. Dieses Verfahren wird in verschiedenen Disziplinen eingesetzt, einschließlich Psychologie, Pädagogik und Biologie, um die Analyse und das Verständnis von Verhaltensweisen oder Phänomenen zu erleichtern. Im Bildungsbereich, zum Beispiel, Gruppenbildung kann die Interaktion und das Lernen unter den Schülern verbessern, indem sie die Arbeit fördert.. unter Verwendung des Irisblüten-Datasets.
Gruppierung
Cluster sie sind eine Gruppe derselben Elemente oder Elemente wie eine Sterngruppe oder eine Weintraube oder eine Gruppe von Netzen und so weiter …
Clustering in der realen Welt nutzen:
Es wird in E-Commerce-Sites verwendet, um Kundengruppen basierend auf ihrem Profil wie z. B. Alter zu bilden, Sex, Ausgaben, Regelmäßigkeit, etc. Es ist nützlich in Marketing und Vertrieb, da es hilft, die Zielgruppe des Produkts zu gruppieren. Spam-Filterung in E-Mails und vieles mehr sind echte Clustering-Anwendungen.
Clustering in R bezieht sich auf die Assimilation des gleichen Datentyps in Gruppen oder Cluster, um eine Gruppe von den anderen zu unterscheiden. (Sammlung der gleichen Art von Daten). Dies kann im grafischen Format durch R . dargestellt werden. Wir verwenden in diesem Prozess das KMeans-Modell.
Was ist der K Means-Algorithmus??
K Means ist ein Clustering-Algorithmus, der einem Datenpunkt gemäß den Eigenschaften des Punkts wiederholt eine Gruppe aus den k vorhandenen Gruppen zuweist. Es ist eine Gruppierungsmethode basierend auf Schwerpunkten.
Die Anzahl der Cluster ist festgelegt, Clusterzentren werden zufällig am weitesten voneinander entfernt ausgewählt, der Abstand zwischen jedem Datenpunkt und dem Zentrum wird mit der euklidischen Distanz berechnet, der Datenpunkt wird dem Cluster zugewiesen, dessen Zentrum diesem Punkt am nächsten liegt. Dieser Vorgang wird wiederholt, bis sich die Mitte der Gruppen nicht ändert und die Datenpunkte in derselben Gruppe bleiben..
Das ist alles Theorie, aber in der praxis, R hat ein Bündelungspaket, das die oben genannten Schritte berechnet.
Paso 1
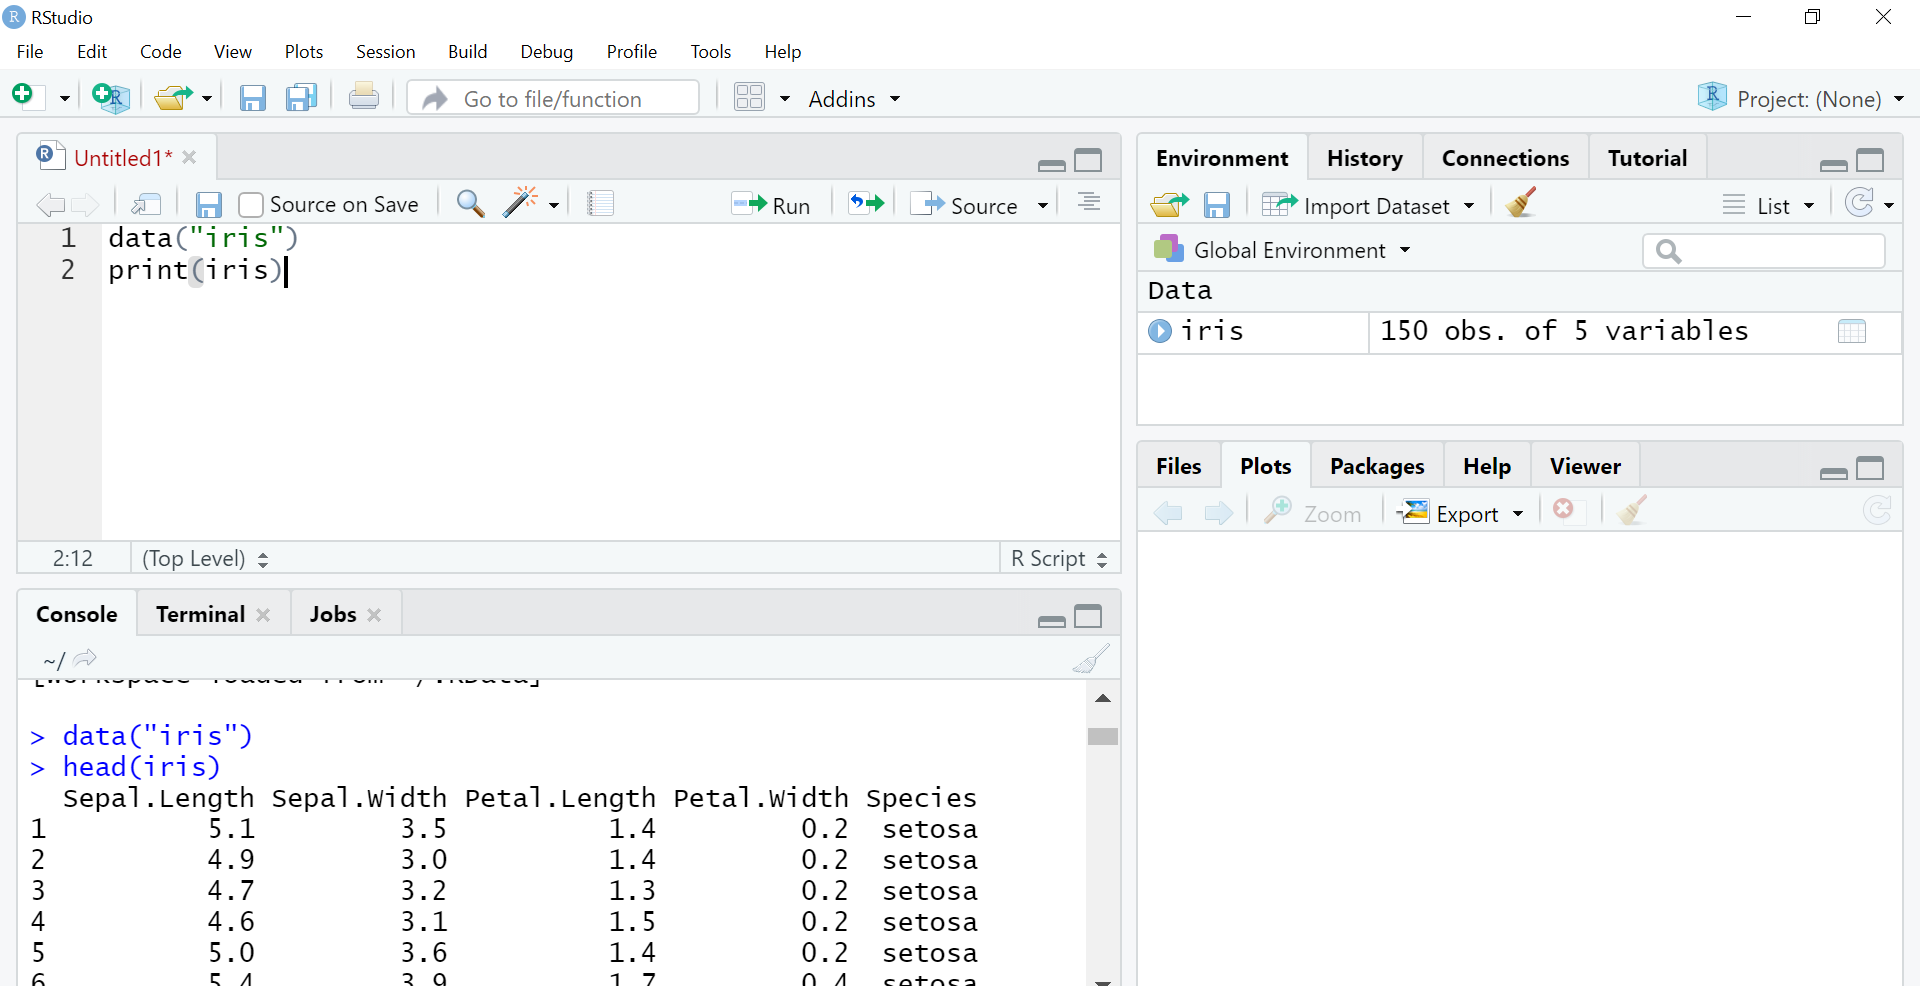
Ich werde am Iris-Datensatz arbeiten, Dies ist ein integrierter Datensatz in R mit dem Cluster-Paket. Verfügt über 5 Säulen, nämlich: Kelchblattlänge, Kelchbreite, Blütenblattlänge, Blütenblattbreite und Art. Iris ist eine Blume und hier in diesem Datensatz werden sie erwähnt 3 seiner Art Setosa, Versicolor, Verginica. Wir werden die Blumen nach ihrer Art gruppieren. Der Code zum Laden des Datensatzes:
Daten("Iris")
Kopf(Iris) #wird nach oben zeigen 6 nur Reihen
Paso 2
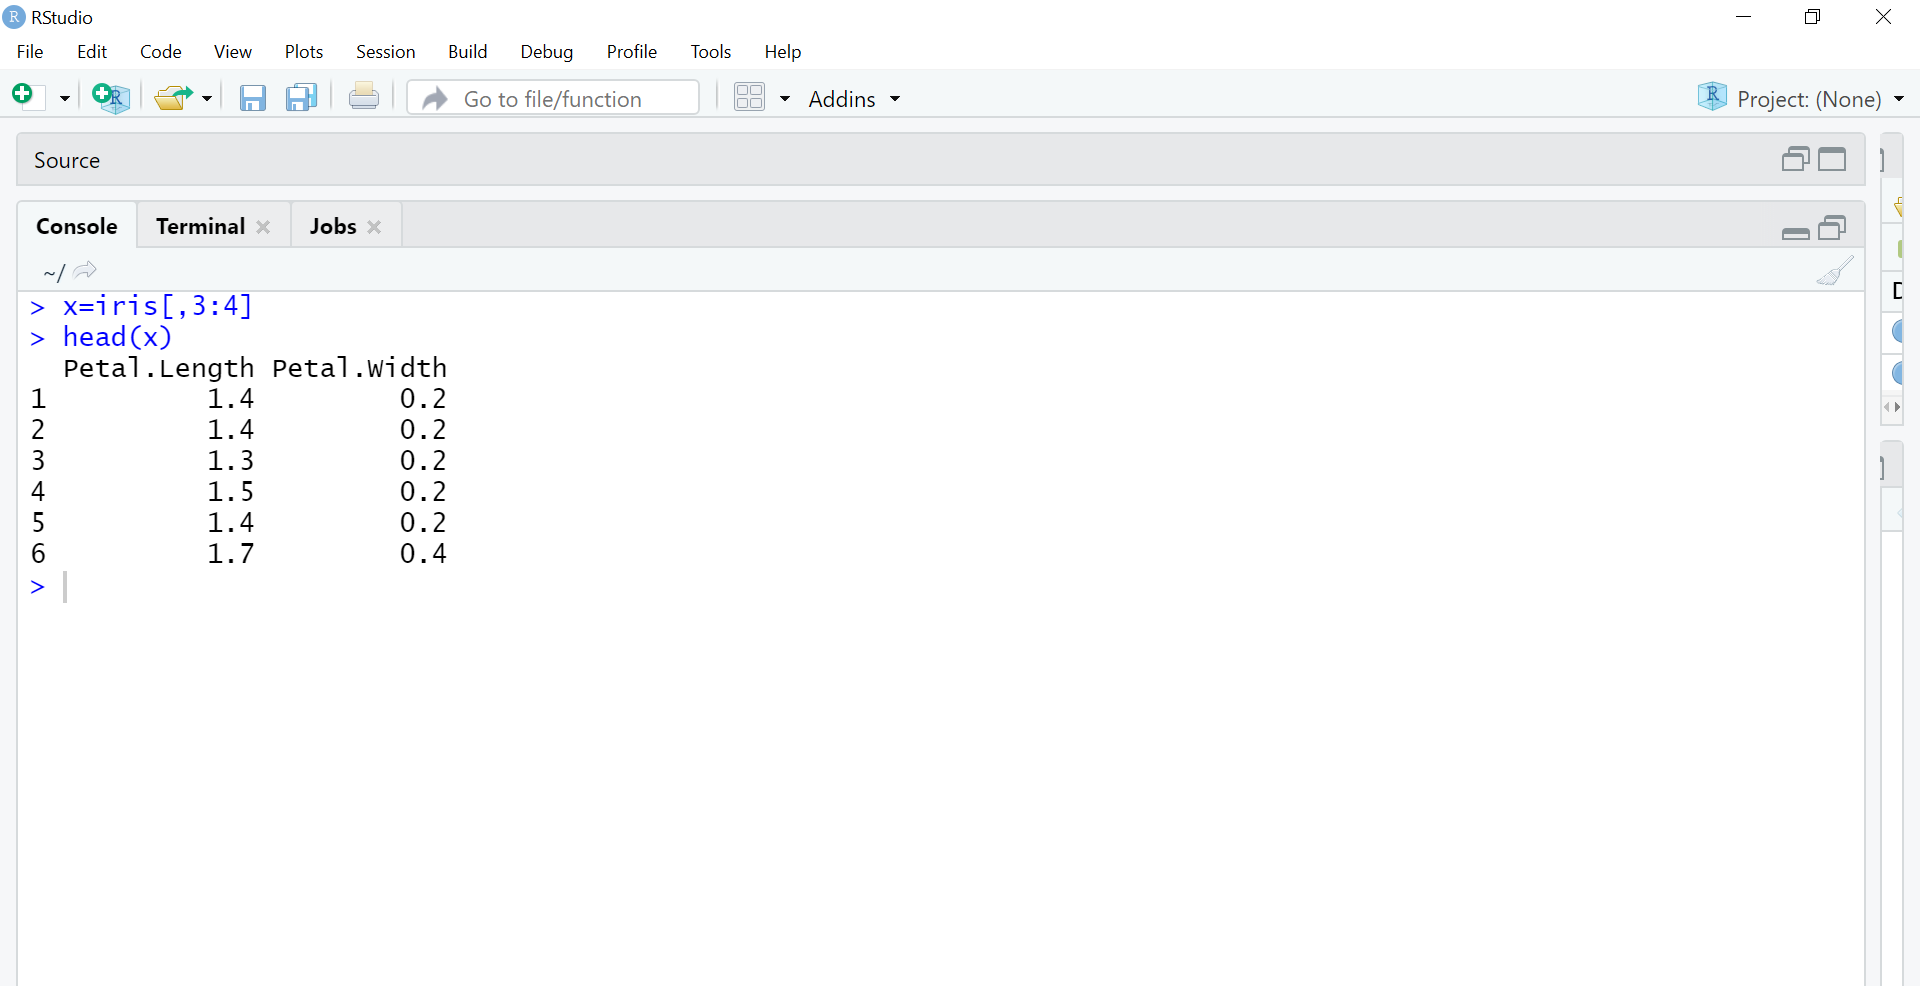
Der nächste Schritt besteht darin, die Spalten zu trennen 3 Ja 4 in einem separaten x-Objekt, da wir die unüberwachte Lernmethode verwenden. Wir entfernen Etiketten für die Maschine, um die riesige Eingabe von Spalten für Blütenblattlänge und -breite für die unbeaufsichtigte Gruppierung zu verwenden.
x = Iris[,3:4] #nur Spalten für Blütenblattlänge und -breite verwenden
Kopf(x)
Paso 3
Der nächste Schritt besteht darin, den K Means-Algorithmus zu verwenden. K Means ist die von uns verwendete Methode mit Parametern (Daten, Nein. Von Clustern zu Gruppen). Hier sind unsere Daten das Objekt x und wir haben k = 3 Gruppen, weil dort sind 3 Arten im Datensatz.
So dass er ‚Cluster-Paket benannt. Das Clustering in R erfolgt mit diesem integrierten Paket, das die gesamte Mathematik erledigt. Die Funktion Clusplot erstellt einen 2D-Plot der Cluster.
model=kmeans(x,3)
 Bücherei(Cluster)
clusplot(x,model$cluster)
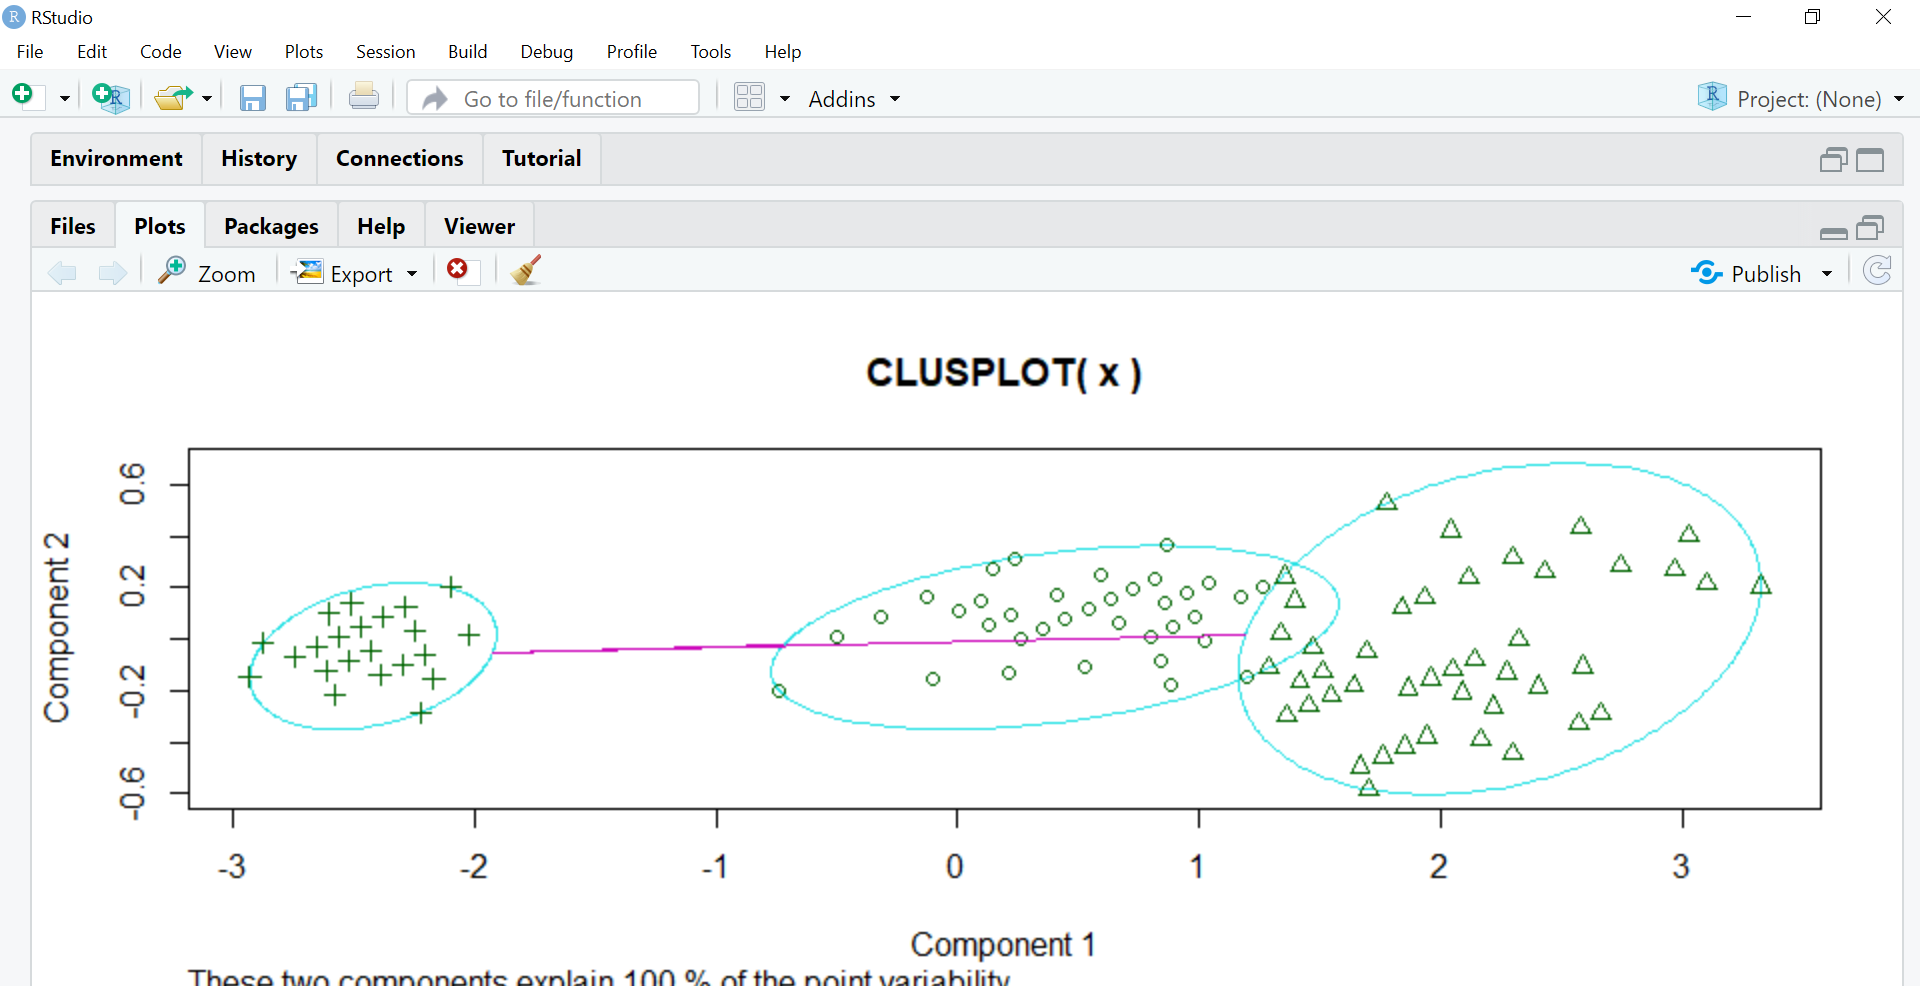
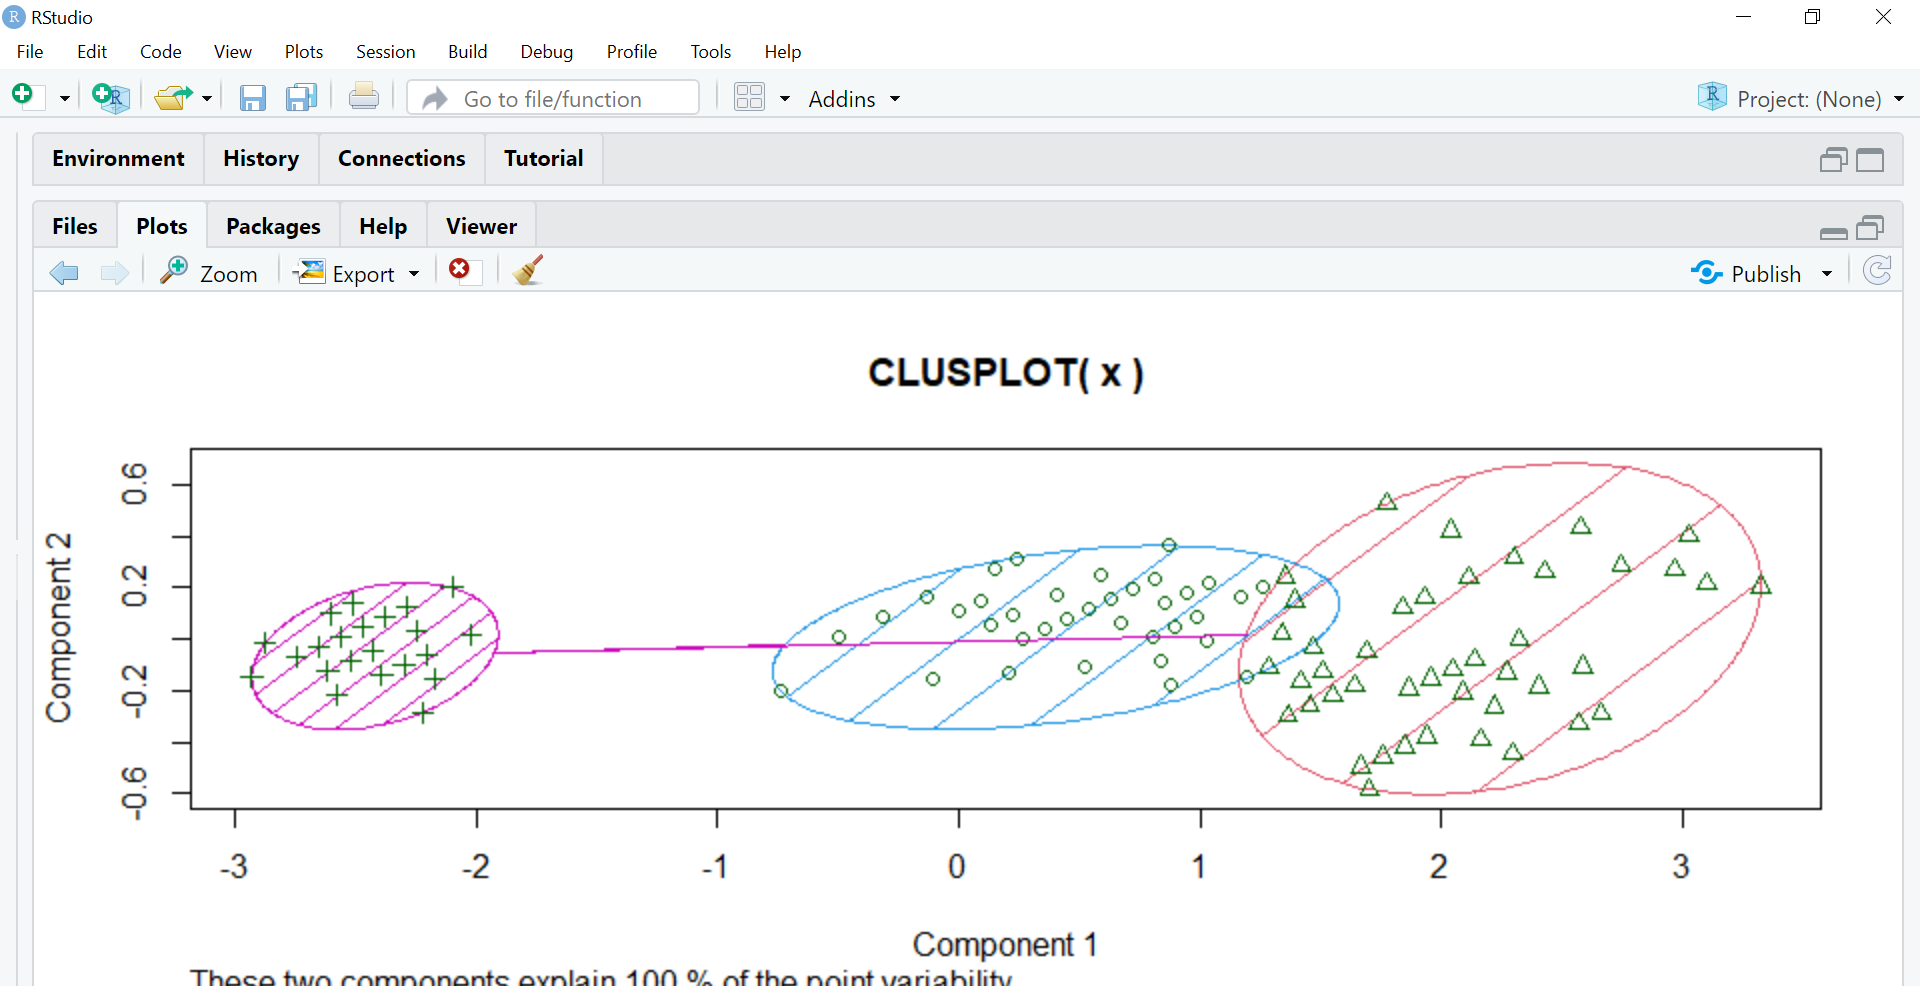
Die Komponente 1 und die Komponente 2 in der Grafik zu sehen sind die beiden Komponenten von PCA (Hauptkomponentenanalyse), Dies ist im Grunde eine Methode zur Merkmalsextraktion, die die wichtigen Komponenten verwendet und den Rest entfernt. Reduziert die Dimensionalität der Daten, um die Anwendung von KMeans zu erleichtern. All dies wird von der ClusterEin Cluster ist eine Gruppe miteinander verbundener Unternehmen und Organisationen, die im selben Sektor oder geografischen Gebiet tätig sind, und die zusammenarbeiten, um ihre Wettbewerbsfähigkeit zu verbessern. Diese Gruppierungen ermöglichen die gemeinsame Nutzung von Ressourcen, Wissen und Technologien, Förderung von Innovation und Wirtschaftswachstum. Cluster können sich über eine Vielzahl von Branchen erstrecken, Von der Technologie bis zur Landwirtschaft, und sind von grundlegender Bedeutung für die regionale Entwicklung und die Schaffung von Arbeitsplätzen.... ein R.
Diese beiden Komponenten erklären die Variabilität der 100% am Ausgang, Das bedeutet, dass das PCA zugeführte Datenobjekt x genau genug war, um mit KMeans klare Gruppen zu bilden, und es gibt nur minimale Überschneidungen (unbedeutend) unter ihnen.
Paso 4
Der nächste Schritt besteht darin, den Gruppen unterschiedliche Farben zuzuweisen und sie zu schattieren, Daher, wir verwenden die Farb- und Schattenparameter, indem wir sie auf T . setzen, was wahr bedeutet.
clusplot(x,model$cluster,Farbe=T,Schatten = T)
Fazit
Dies alles fasst die Grundlagen des Clusterings in R . zusammen. Hier verwende ich einen eingebauten Datensatz, importierte Datensätze können aber auch für das Clustering verwendet werden. Zum Beispiel: Gruppieren von Site-Benutzern basierend auf bevorzugten Artikeln, etc. Es ist sehr nützlich, um Unternehmensvergleiche anzustellen.
Datensätze in R . importieren:
Datensatz <- lesen.csv("Pfad.csv")
Sicht(Datensatz)
anfügen(Datensatz)
Danke, dass Sie sich die Zeit genommen haben und diesen Artikel gelesen haben.,Fühlen Sie sich frei zu kommentieren, was verbessert werden kann, denn Lernen ist ein täglicher Prozess.nachalle..
VerbindenmitmichÜberLinkedIn:https://www.linkedin.com/in/akansha-bose-149b14164/
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





