
Dieser Artikel wurde im Rahmen der Data Science Blogathon.
Überblick
- Alle grundlegenden und fundamentalen Komponenten, die für die Sentiment-Analyse erforderlich sind.
- Ich habe einen einfachen Ansatz verwendet, um alle Grundlagen zu erklären, damit auch ein Anfänger alle Konzepte vollständig verstehen kann.
- Themen: Textvorverarbeitung, Wortschatzkorpus, Merkmalsextraktion (Spärliche Darstellung und Frequenzwörterbuch), Logistisches Regressionsmodell zur Sentimentanalyse.
Die Stimmungsanalyse ist eine überwachte maschinelle Lerntechnik, die verwendet wird, um die Polarität von Stimmungen in einem Text zu analysieren und vorherzusagen (entweder positiv oder negativ).
Es wird oft von Unternehmen und Unternehmen verwendet, um die Erfahrung ihrer Benutzer zu verstehen, Emotionen, Antworten, etc. damit sie die Qualität und Flexibilität ihrer Produkte und Dienstleistungen verbessern können.
Jetzt, Lassen Sie uns genauer untersuchen, wie Ingenieure für maschinelles Lernen diese Sentimentanalysetechnik verwenden, um die Stimmung aus verschiedenen Texten zu untersuchen.
Daten sammeln
"MEHR DATEN, BESSER! „
Es gibt so viele offene Datenquellen, die zum Trainieren von ML-Modellen verwendet werden können, Daher ist es eine persönliche Entscheidung, Daten selbst zu sammeln oder offene Datensätze zu verwenden, um unseren Algorithmus zu trainieren.
Textbasierte Datensätze werden in der Regel verteilt als JSONJSON, o JavaScript-Objekt-Notation, Es handelt sich um ein leichtgewichtiges Datenaustauschformat, das für Menschen leicht zu lesen und zu schreiben ist, und für Maschinen einfach zu analysieren und zu generieren. Es wird häufig in Webanwendungen verwendet, um Informationen zwischen einem Server und einem Client zu senden und zu empfangen. Seine Struktur basiert auf Schlüssel-Wert-Paaren, Dadurch ist es vielseitig einsetzbar und in der Softwareentwicklung weit verbreitet.. o CSV Formate, also um sie zu benutzen, wir können die Daten in einer Python-Liste oder in einem Wörterbuch abrufen / Datenrahmenobjekt.
Die Daten müssen auf den Zug aufgeteilt werden, Validierungs- und Test-Sets auf eine gemeinsame Weise von 60% 20% 20% Ö 70% 15% 15%.
Der beliebte Twitter-Datensatz kann heruntergeladen werden unter hier.
Pipeline
Jede Machine-Learning-Aufgabe sollte eine RohrleitungPipeline ist ein Begriff, der in einer Vielzahl von Zusammenhängen verwendet wird, hauptsächlich im Technologie- und Projektmanagement. Es bezieht sich auf eine Reihe von Prozessen oder Phasen, die den kontinuierlichen Arbeitsfluss von der Konzeption einer Idee bis zu ihrer endgültigen Umsetzung ermöglichen. Im Bereich der Softwareentwicklung, zum Beispiel, Eine Pipeline kann die Planung umfassen, Testen und Bereitstellen, Dies garantiert mehr Effizienz und Qualität in der.... Pipelines werden verwendet, um Ihre Machine-Learning-Workflows in unabhängige modulare Teile zu unterteilen, wiederverwendbar, die dann zusammengeführt werden können, um die Modellgenauigkeit kontinuierlich zu verbessern und einen erfolgreichen Algorithmus zu erreichen.
Wir folgen einer grundlegenden Pipeline-Struktur für unser Problem, damit ein Leser jeden Teil der Pipeline, die in unserem Workflow verwendet wird, leicht verstehen kann. Unsere Pipeline wird die folgenden Schritte umfassen:
- Textvorverarbeitung und Wortschatzaufbau: Beseitigung unerwünschter Texte (leere Worte), Interpunktion, URLs, Kennungen, etc. die keinen sentimentalen Wert haben. Und dann vorverarbeitete einzigartige Wörter zu einem Vokabular hinzufügen.
- Merkmalsextraktion: Durch jedes Datenbeispiel iterieren, um Merkmale mit einem Häufigkeitswörterbuch zu extrahieren und schließlich ein Array von Merkmalen zu erstellen.
- Modell von AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen....: Wir werden dann unsere Feature-Matrix verwenden, um ein logistisches Regressionsmodell zu trainieren, um dieses Modell zur Vorhersage von Stimmungen zu verwenden..
- Testmuster: Verwenden unseres trainierten Modells, um die Vorhersagen aus Daten zu erhalten, die Sie nie gesehen haben.
Datenvorverarbeitung
Es ist ein wichtiger Schritt in unserem Projektportfolio. Die Textvorverarbeitung kann verwendet werden, um Wörter und Punktzahlen aus Textdaten zu entfernen, die keinen sentimentalen Wert haben, da die Textvorverarbeitung unsere Einarbeitungszeit deutlich verbessern kann, da die Größe unserer Daten reduziert und auf Wörter beschränkt wird, die einen gewissen sentimentalen Wert haben. Die Vorverarbeitung umfasst die Handhabung von
-
Für Worte
Wörter ohne Wert / semantisches oder sentimentales Gewicht in einem Satz. zum Beispiel: Ja, es ist, das, Sie, etc.
So verarbeiten Sie sie? Wir erstellen eine Liste mit allen möglichen Stoppwörtern wie
['uns selbst', 'ihres', 'zwischen', 'du selbst', 'aber', 'wieder', 'dort', 'Über', 'wenn', 'während', 'aus', 'sehr', 'haben', 'mit', 'Sie', 'besitzen', 'ein', 'Sein', 'etwas', 'zum', 'tun', 'es ist', 'dein', 'eine solche', 'hinein', 'von', 'die meisten', 'selbst', 'Sonstiges', 'aus', 'ist', 'S', 'bin', 'oder', 'Wer', 'wie', 'von', 'ihm', 'jede einzelne', 'das', 'sich', 'bis um', 'unter', 'sind', 'wir', 'diese', 'Ihre', 'seine', 'durch', 'anziehen', 'Noch', 'mich', 'wurden', 'Sie', 'mehr', 'selbst', 'Dies', 'Nieder', 'sollen', 'unsere', 'ihr', 'während', 'Oben', 'beide', 'hoch', 'zu', 'unsere', 'hatte', 'Sie', 'alle', 'Nein', 'Wenn', 'bei', 'irgendein', 'Vor', 'Sie', 'gleich', 'und', 'gewesen', 'verfügen über', 'in', 'Wille', 'An', 'tut', 'euch', 'dann', 'das', 'da', 'was', 'Über', 'warum', 'so', 'kann', 'Tat', 'nicht', 'jetzt', 'unter', 'er', 'Sie', 'Sie selbst', 'hat', 'nur', 'wo', 'auch', 'nur', 'mich selber', 'welcher', 'jene', 'ich', 'nach', 'wenig', 'dem', 'T', 'Sein', 'wenn', 'ihre', 'mein', 'gegen', 'ein', 'von', 'tun', 'es', 'wie', 'weiter', 'war', 'Hier', 'als']
Wir werden nun jedes Beispiel in unseren Daten durchlaufen und jedes Wort aus unseren Daten entfernen, das in der Stoppwortliste vorhanden ist.
-
Spielstände
Satzzeichen sind Symbole, mit denen wir unseren Text hervorheben. zum Beispiel:! , @, #, $, etc.
So verarbeiten Sie sie? Wir werden sie auf ähnliche Weise verarbeiten, wie wir Stoppwörter verarbeitet haben, wir erstellen eine Liste davon und verarbeiten jedes Beispiel mit dieser Liste.
-
URLs und Bezeichner
URLs sind die Links, die mit der HTTP-Protokolldeklaration beginnen, zum Beispiel. ‚https: //….‘ und Identifikatoren werden verwendet, um Personen in sozialen Medien zu erwähnen, zum Beispiel. ‚@Nutzername‘ beide teilen eine null sentimentale Bedeutung.
So verarbeiten Sie sie? Verarbeiten Sie sie, indem Sie eine Funktion erstellen ‚process_handles_urls ()‘ die die Daten unseres Trainings nimmt und Wörter entfernt, die mit ‚https: //‘ Ö ‚@‘ von jedem Beispiel.
-
Derivat
Die Ableitung ist ein Prozess, bei dem ein Wort auf seinen Grundwortstamm reduziert wird. Zum Beispiel, ‚Dreh dich‘ ist ein Wurzelwort der Drehung, Dreh dich, Dreh dich, etc. Da das Wurzelwort für alle seine angehängten Wörter den gleichen sentimentalen Wert bietet, wir können jedes Wort auf seine Grundwurzel reduzieren, was unseren Wortschatz und unsere Trainingszeit reduzieren kann. ebenso gut wie.
So verarbeiten Sie sie? Verarbeiten Sie sie, indem Sie eine Funktion erstellen ‚do_stemming ()‘ die die Daten nimmt und die Wörter aus jedem Beispiel ableitet.
-
Unteres Gehäuse
Wir sollten für jedes Wort in den Daten ähnliche Groß- und Kleinschreibung verwenden, um ‚Wort‘, ‚WORD‘, ‚Wort‘ es sollte nur ein Fall folgen, nämlich, Kleinbuchstaben, Dies kann auch dazu beitragen, den Wortschatz zu reduzieren und Wortwiederholungen zu vermeiden.
So verarbeiten Sie sie? Durchlaufen Sie jedes Beispiel, Verwenden Sie die .lower-Methode () um jeden Textblock in Kleinbuchstaben umzuwandeln.
Wortschatzkorpus
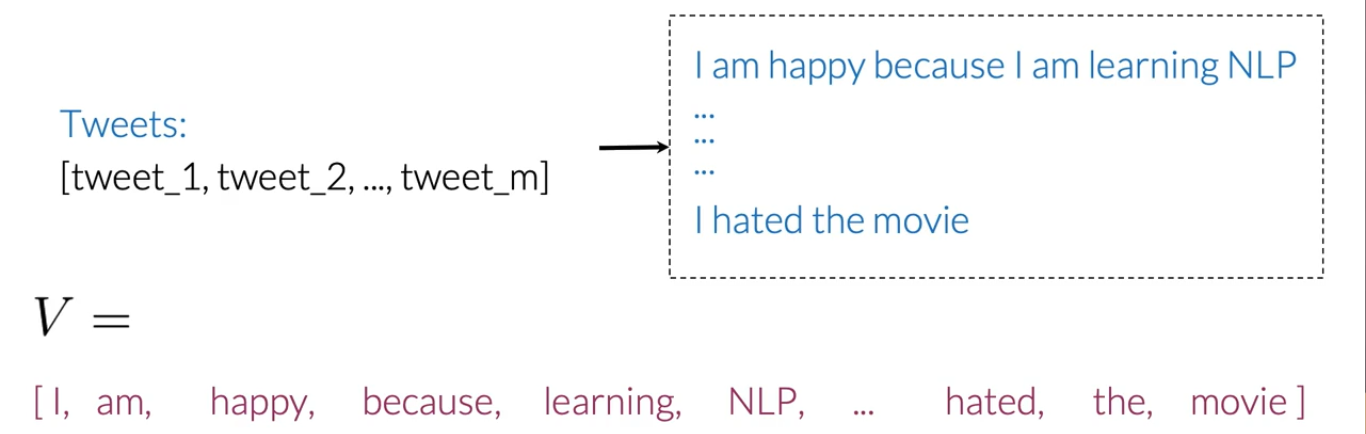
Nach der Vorverarbeitung der Daten, Es ist an der Zeit, ein Vokabular zu erstellen, das jedes einzelne Wort speichert und jedem einzelnen Wort einen numerischen Wert zuweist (dies wird auch Tokenisierung genannt).
Wir werden dieses Vokabelwörterbuch für die Merkmalsextraktion verwenden.
Merkmalsextraktion
Eines der Probleme, bei der Arbeit mit Sprachverarbeitung, ist, dass maschinelle Lernalgorithmen nicht direkt mit Rohtext arbeiten können. Dann, wir brauchen einige Techniken zur Merkmalsextraktion, um Text in ein Array zu konvertieren (o Vektor) numerische Eigenschaften.
Nehmen wir einige Beispiele für positive und negative Tweets:
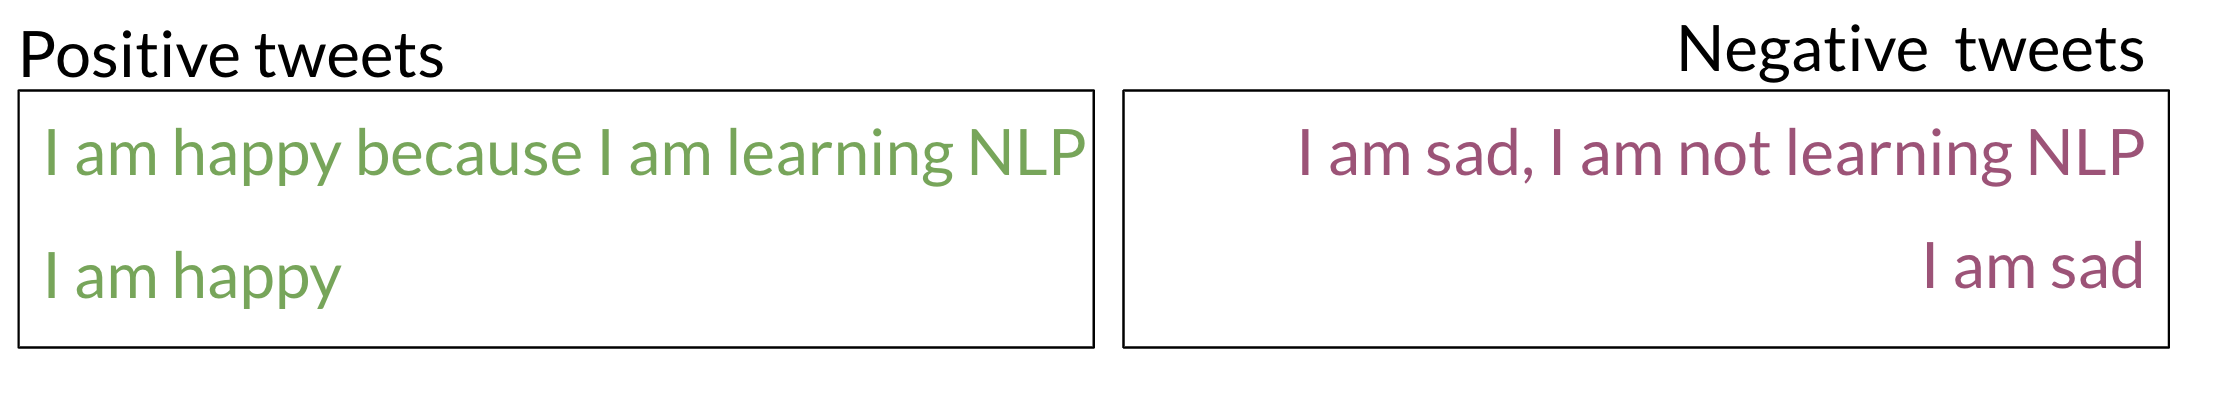
HINWEIS: Das obige Beispiel ist noch nicht verarbeitet, also werden wir es zuerst verarbeiten, bevor wir zu weiteren Schritten übergehen.
Schlechte Darstellung
Es ist ein naiver Ansatz, Merkmale aus einem Text zu extrahieren. Nach der spärlichen Darstellung, Wir können eine Reihe von Funktionen erstellen, indem wir die vollständigen Daten durchlaufen, und für jedes Wort, im Textbeispiel werden wir zuweisen 1 an der Position dieses Wortes in der Vokabelliste und für Wörter, die nicht vorkommen, UNS ‚ ich werde zuweisen 0. Dann, unsere Feature-Matrix hat Zeilen = Gesamtzahl der Sätze in unseren Daten und Spalten = Gesamtzahl der Wörter im Wortschatz.

Nachteile:
- Super Trainingszeit
- Tolle Vorhersagezeit
Frequenzwörterbuch
Ein Häufigkeitswörterbuch verfolgt die positiven und negativen Häufigkeiten jedes Wortes in unseren Daten.

Positive Frequenz: das Wie oft ein Wort in Sätzen mit positiver Stimmung vorkommt.
Negative Frequenz: das Wie oft ein Wort in Sätzen mit negativem Gefühl vorkommt.
Merkmalsextraktion mit Frequenzwörterbuch:
Verwenden des Häufigkeitswörterbuchs für die Merkmalsextraktion, wir können die Dimensionen jeder Zeile reduzieren, die jeden Satz einer Merkmalsmatrix repräsentiert (nämlich, gleich der Anzahl der Wörter im Vokabular bei Unterrepräsentation) dreidimensional.
Die Merkmale der Daten eines Textes werden mit dem Merkmalswörterbuch mit den folgenden Formeln extrahiert:

Der Prozess sieht fast so aus:
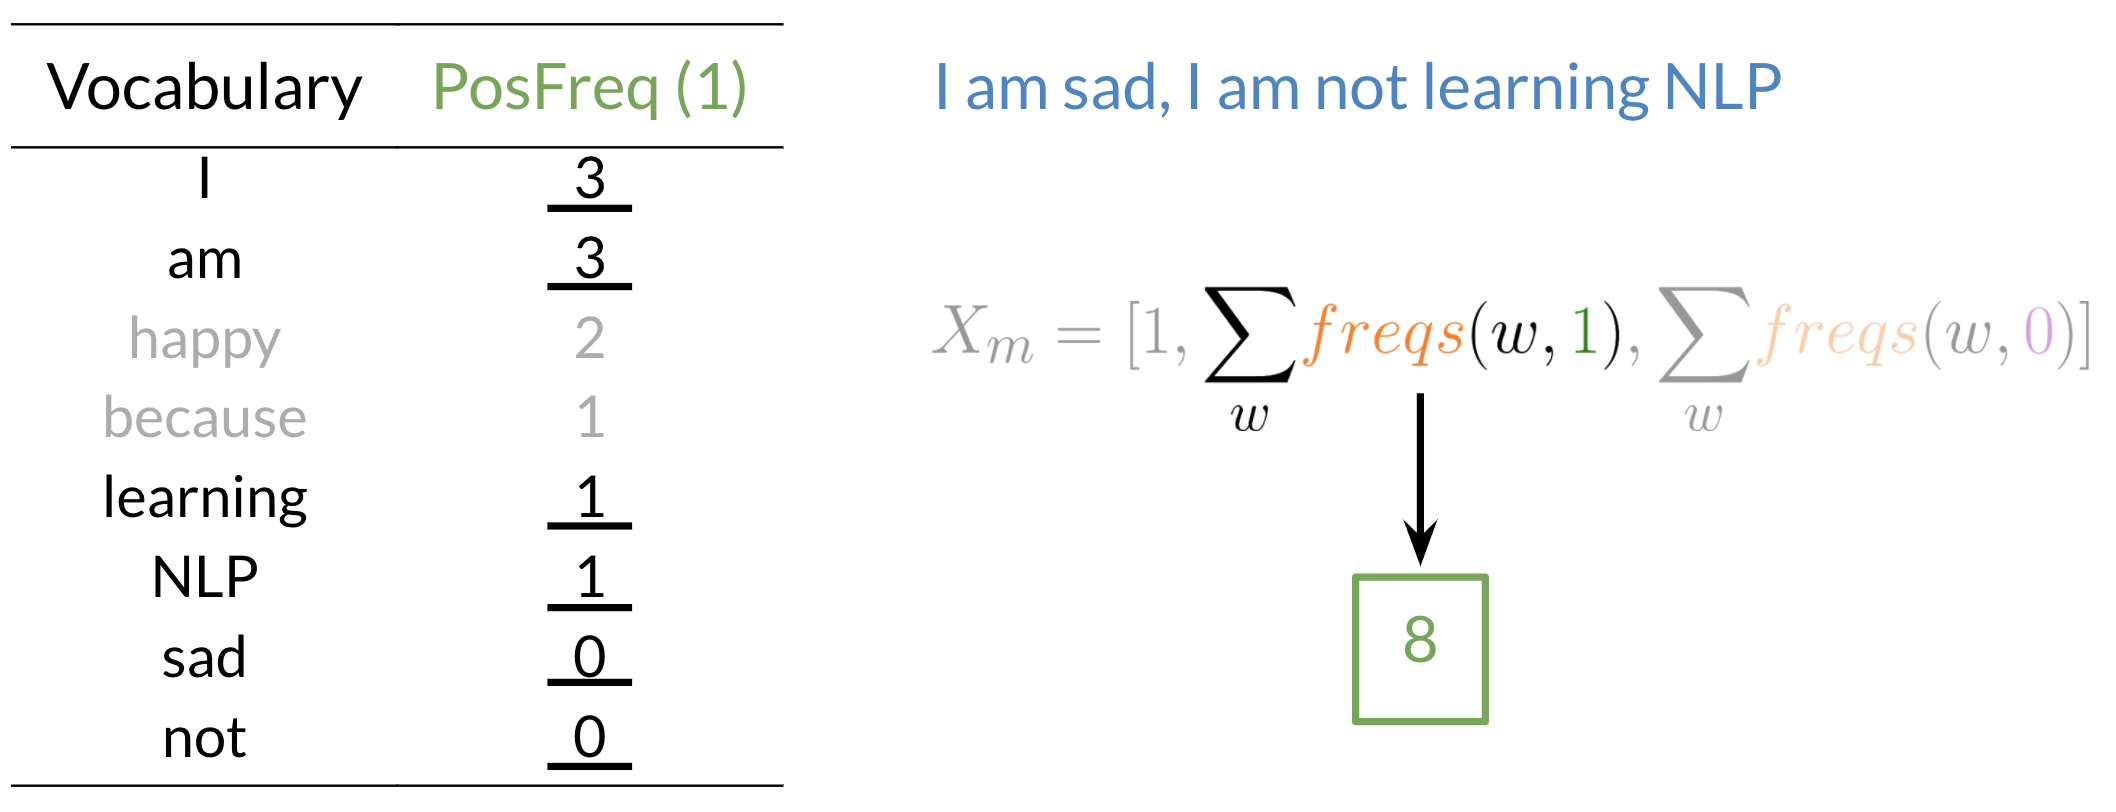
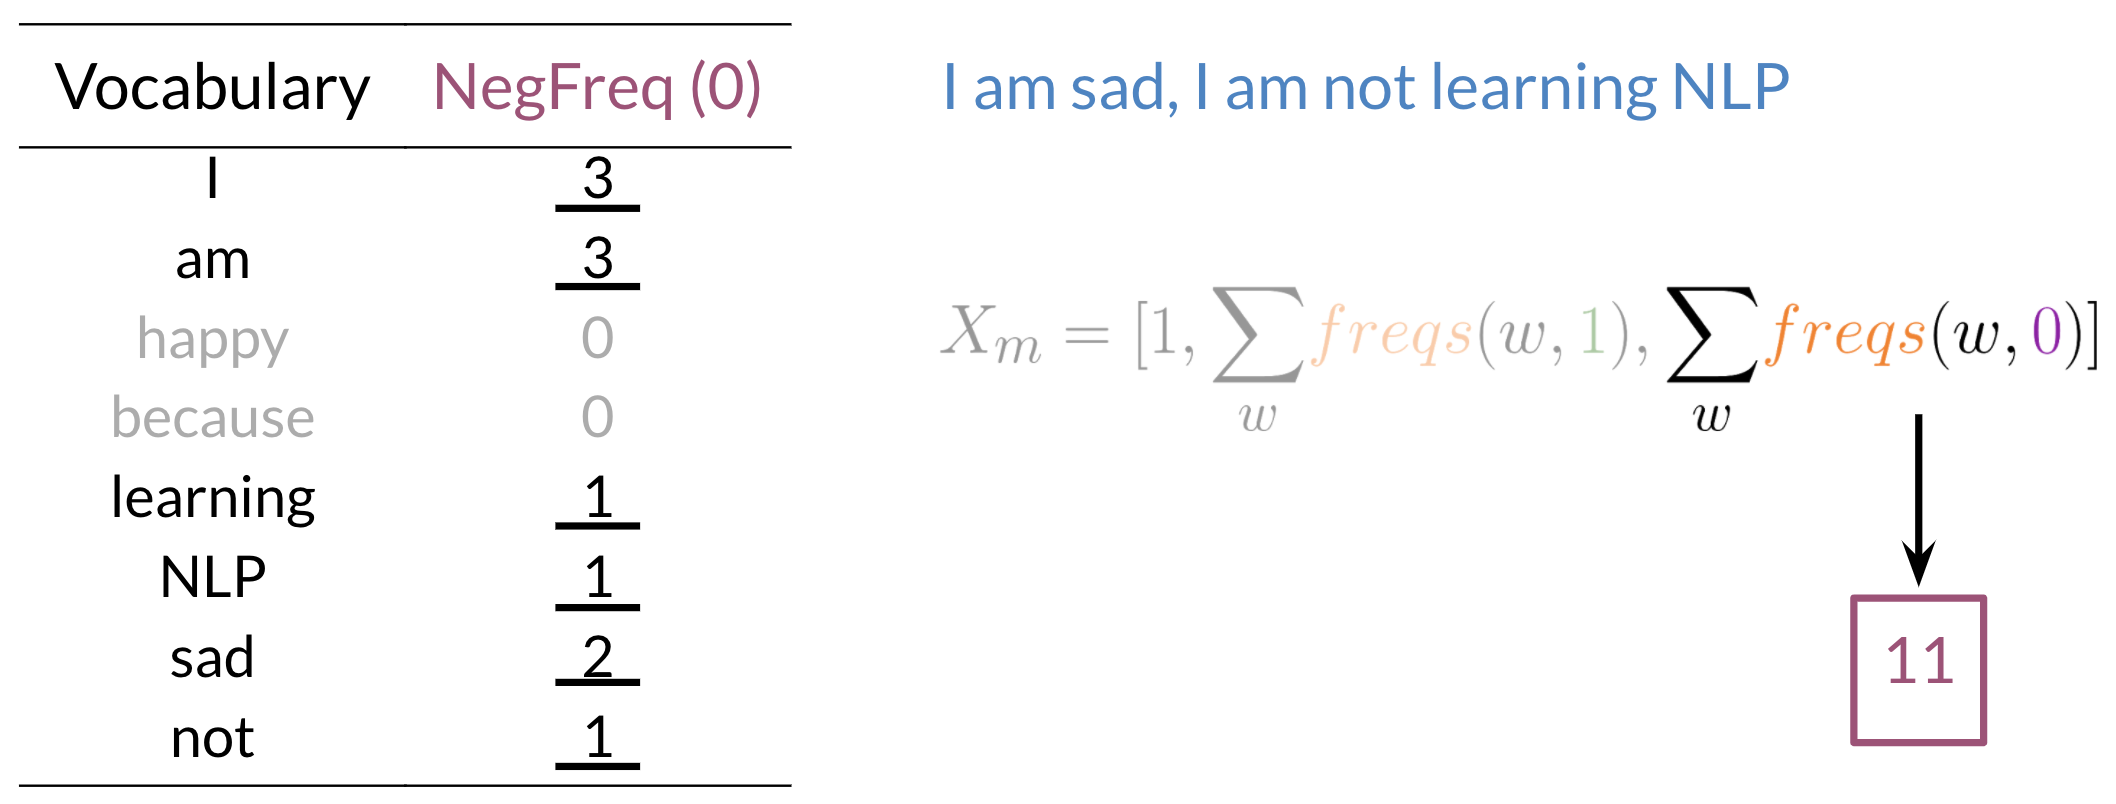
Wir haben jetzt einen dreidimensionalen Feature-Vektor für unseren Tweet, der so aussieht:
Xm = [1,8,11]
Jetzt durchlaufen wir jedes Beispiel, um Merkmale aus jedem Beispiel zu extrahieren, und verwenden dann diese Merkmale, um die Merkmalsmatrix zu erstellen, die wir für das Training verwenden können.. Schließlich, Wir haben eine Reihe von Eigenschaften wie:

Logistische Regression zur Sentimentanalyse
Logistische Regression modelliert die Wahrscheinlichkeiten von Klassifikationsproblemen mit zwei möglichen Ergebnissen. Es ist eine Erweiterung des linearen Regressionsmodells für Klassifikationsprobleme.
Anwendungen der logistischen Regression eine Sigmoidfunktion um die Ausgabe unserer linearen Funktion abzubilden (θTx) Komm herein 0 Ja 1 mit einer gewissen Schwelle (allgemein 0.5) zwischen zwei Klassen unterscheiden, also wenn er> 0.5 es ist eine positive klasse, und wenn ha <0.5 es ist eine negative klasse. (Die Erläuterung der vollständigen logistischen Regression würde den Rahmen dieses Artikels sprengen.)

Sentimentanalysemodell trainieren
Das Training unseres Modells wird den folgenden Schritten folgen:
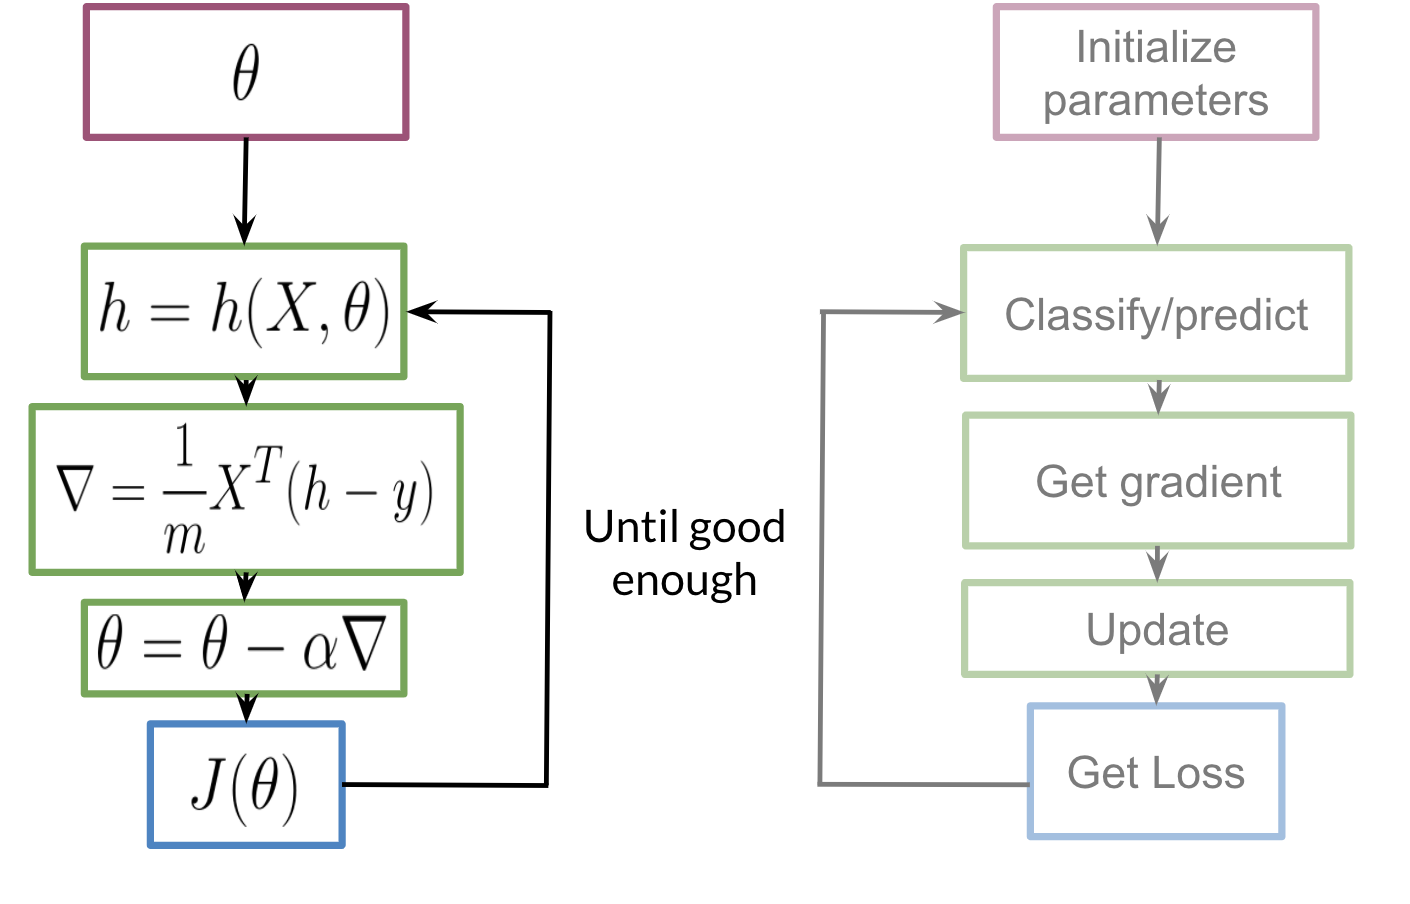
Wir initialisieren unseren Parameter θ, die wir in unserem sigmoid verwenden können, dann berechnen wir das SteigungGradient ist ein Begriff, der in verschiedenen Bereichen verwendet wird, wie Mathematik und Informatik, um eine kontinuierliche Variation von Werten zu beschreiben. In Mathematik, bezieht sich auf die Änderungsrate einer Funktion, während des Studiums im Grafikdesign, Gilt für den Farbübergang. Dieses Konzept ist unerlässlich, um Phänomene wie die Optimierung von Algorithmen und die visuelle Darstellung von Daten zu verstehen, ermöglicht eine bessere Interpretation und Analyse in... das wir verwenden, um θ zu aktualisieren, und dann berechnen wir die Kosten. Wir werden die Schritte so lange wiederholen, bis die Kosten minimiert sind / konvergieren.
Testen unseres Modells
Um unser Modell zu testen, verwenden wir unser Validierungsset und folgen den folgenden Schritten:
- Teilen Sie die Daten in X_validation (Text) und Y_validation (Gefühl).
- Verwenden Sie die Merkmalsextraktion für X_validation, um Texte in numerische Merkmale umzuwandeln.
- Finden Sie den Vektor h (= Sigmoide (θTx)) für jeden Text im Validierungsset.
- Weisen Sie eine Funktion zu, um die tatsächlichen Klassen beim Vergleich mit einem Schwellenwert zu erhalten.
- Finden Sie die Genauigkeit unserer Vorhersagen.

Zusammenfassung
Ich freue mich, dass du es bis hierher geschafft hast! Wenn Sie ein Anfänger in der Verarbeitung natürlicher Sprache sind, Ich hoffe, ich kann Ihnen eine Vorstellung davon geben, wie die Dinge unter der Haube funktionieren und Sie in die Lage versetzen, komplexere und fortgeschrittene Themen abzudecken und, wenn du ein Profi bist, Ich hoffe, ich konnte deine Grundlagen auffrischen.
Die Verarbeitung natürlicher Sprache ist eine riesige Domäne der künstlichen Intelligenz, seine Anwendungen werden in verschiedenen Paradigmen verwendet, wie Chatbots, Stimmungsanalyse, automatische Übersetzung, Autokorrektur, etc. Es gibt mehrere E-Learning-Plattformen und Artikel, funktioniert, etc. kostenlose Verteilung, die hilfreich sein kann, um die Reise weiter voranzutreiben.
Verweise: Spezialisierung auf Verarbeitung natürlicher Sprache





