
Dieser Artikel wurde im Rahmen der Data Science Blogathon
Einführung
sind beobachtbar. Da wir die Werte für die unbeobachteten Variablen nicht haben (latent), das Erwartungsmaximierung Der Algorithmus versucht, anhand vorhandener Daten die optimalen Werte für diese Variablen zu ermitteln und findet dann die ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten.... des Modells.
Inhaltsverzeichnis
- 👉 Was ist der Erwartungsmaximierungsalgorithmus? (IN)?
- 👉 Detaillierte Erläuterung des EM-Algorithmus
- 👉 Flussdiagramm
- 👉 Vor- und Nachteile
- 👉 Anwendungen des EM-Algorithmus
- 👉 Anwendungsfall des EM-Algorithmus
- Einführung in die Gauß-Verteilungen
- Gaußsche Mischungsmodelle (GMM)
- 👉 Implementierung von Gaußschen Mischungsmodellen in Python
Was ist der Erwartungsmaximierungsalgorithmus? (IN)?
👉 Es ist ein Modell für VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... latent.
Zuerst, Lassen Sie uns verstehen, was mit latentem Variablenmodell gemeint ist.
Ein latentes Variablenmodell besteht aus beobachtbar Variablen zusammen mit unbeobachtbar Variablen. Beobachtete Variablen sind die Variablen im Datensatz, die gemessen werden können, während die unbeobachteten Variablen (latent / versteckt) werden aus den beobachteten Variablen abgeleitet.
- 👉 Kann verwendet werden, um zu finden lokale maximale Wahrscheinlichkeit (MLE) Parameter oder maximal a posteriori (KARTE) Parameter für latente Variablen
in einem statistischen oder mathematischen Modell. - 👉 Wird verwendet, um diese fehlenden Werte im Datensatz vorherzusagen, vorausgesetzt, wir kennen die allgemeine Form der Wahrscheinlichkeitsverteilung, die mit diesen latenten Variablen verbunden ist.
- 👉 In einfachen Worten, Die Grundidee dieses Algorithmus besteht darin, die beobachtbaren Stichproben latenter Variablen zu verwenden, um die Werte von Stichproben vorherzusagen, die für das Lernen nicht beobachtbar sind. Dieser Vorgang wird wiederholt, bis die Konvergenz der Werte eintritt.
Detaillierte Erläuterung des EM-Algorithmus
👉 Hier ist der Algorithmus, dem Sie folgen müssen:
- Bei einem unvollständigen Datensatz, Beginnen Sie mit einem Satz initialisierter Parameter.
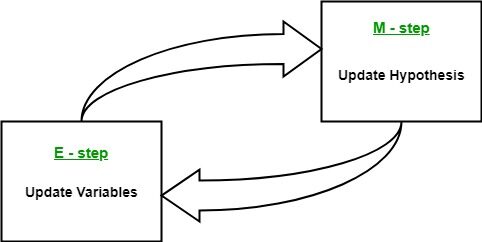
- Erwartungsschritt (Schritt E): In diesem Erwartungsschritt, unter Verwendung der beobachteten Daten, die aus dem Datensatz verfügbar sind, wir können versuchen, die fehlenden Datenwerte zu schätzen oder zu erraten. Schließlich, nach diesem schritt, wir erhalten vollständige Daten ohne fehlende Werte.
- Maximierungsschritt (Schritt M): Jetzt, Wir müssen die vollständigen Daten verwenden, die sich im Erwartungsschritt vorbereiten, und aktualisieren Sie die Parameter.
- Schritt wiederholen 2 und der schritt 3 bis wir zu unserer Lösung konvergieren.
Bildquelle: Verknüpfung
👉
Ziel des Erwartungsmaximierungsalgorithmus
Der Erwartungsmaximierungsalgorithmus zielt darauf ab, die aus dem Datensatz verfügbaren beobachteten Daten zu verwenden, um die fehlenden Daten für die latenten Variablen zu schätzen und diese Daten dann zu verwenden, um die Parameterwerte im Maximierungsschritt zu aktualisieren..
Lassen Sie uns den EM-Algorithmus im Detail verstehen:
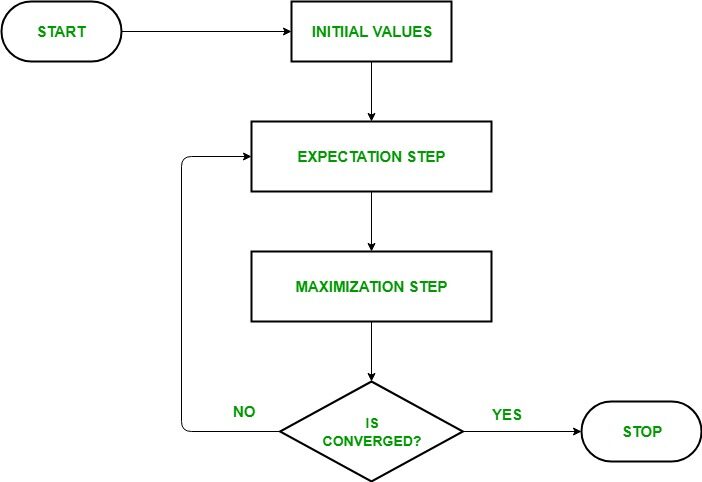
- ichInitialisierungsschritt: In diesem Schritt, wir initialisieren die Parameterwerte mit einem Satz von Anfangswerten, dann liefern wir den unvollständigen beobachteten Datensatz an das System mit der Annahme, dass die beobachteten Daten von einem bestimmten Modell stammen. nämlich, Wahrscheinlichkeitsverteilung.
- Erwartungsschritt: In diesem Schritt, Verwenden Sie beobachtete Daten, um fehlende oder unvollständige Datenwerte zu schätzen oder zu erraten. Wird verwendet, um Variablen zu aktualisieren.
- Maximierungsschritt: In diesem Schritt, Wir verwenden die vollständigen Daten, die in der „Erwartung“ Schritt zum Aktualisieren der Parameterwerte, nämlich, aktualisiere die Hypothese.
- Auf Konvergenz prüfen Schritt: Jetzt, in diesem Schritt, wir prüfen, ob die Werte konvergieren oder nicht, wenn ja, Halt, andernfalls wiederholen Sie diese beiden Schritte, nämlich, das „Erwartung“ Schritt und „Maximierung“ Schritt, bis Konvergenz eintritt.
Flussdiagramm für den EM-Algorithmus
Bildquelle: Verknüpfung
Vor- und Nachteile des EM-Algorithmus
👉 Vorteil
- Die zwei grundlegenden Schritte des EM-Algorithmus, nämlich, E-Schritt und M-Schritt, sind in der Implementierung für viele Machine-Learning-Probleme in der Regel ziemlich einfach.
- Die Lösung der Schritte M existiert oft in geschlossener Form.
- Der Wahrscheinlichkeitswert steigt garantiert immer nach jeder Iteration.
👉 Nachteile
- Verfügt über langsame Konvergenz.
- Konvergieren Sie zum lokales Optimum nur.
- Es berücksichtigt sowohl die Vorwärts- als auch die Rückwärtswahrscheinlichkeit. Dies steht im Gegensatz zur numerischen Optimierung, die nur Chancen auf Vorschuss.
Anwendungen des EM-Algorithmus
Das Modell der latenten Variablen hat mehrere reale Anwendungen im maschinellen Lernen:
- 👉 Wird verwendet, um die zu berechnen Gaußsche Dichte einer Funktion.
- 👉 Nützlich, um die verlorene Daten während einer Show.
- 👉 Findet viel Verwendung in verschiedenen Domänen wie Verarbeitung natürlicher Sprache (NLP), Computer Vision, etc.
- 👉 Wird bei der Bildrekonstruktion im Bereich der Medizin und Bautechnik.
- 👉 Es wird verwendet, um die Parameter der Hidden-Markov-Modell (HMM) und auch für einige andere gemischte Modelle wie Gaußsche Mischung Modelleetc.
- 👉 Es wird verwendet, um die Werte von latenten Variablen zu finden.
Anwendungsfall des EM-Algorithmus
Grundlagen der Gaußschen Verteilung
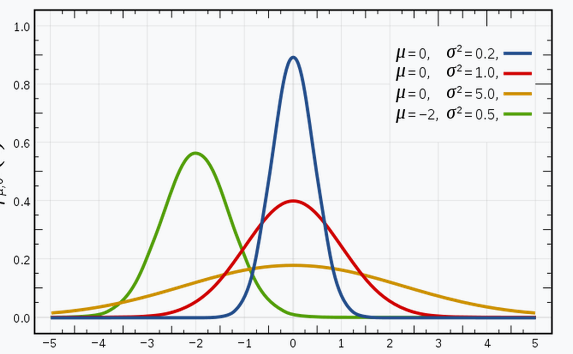
Du kennst bestimmt Gaußsche Verteilungen (oder die Normalverteilung), da diese Verteilung viel im Bereich des maschinellen Lernens und der Statistik verwendet wird. Hat eine glockenförmige Kurve, mit den Beobachtungen symmetrisch um den Mittelwert verteilt (Durchschnitt).
Das gezeigte Bild hat einige Gaußsche Verteilungen mit unterschiedlichen Werten des Mittelwertes (μ) und die Varianz (σ2). Denken Sie daran, dass je größer der Wert von σ (Standardabweichung), je größer die Ausdehnung entlang der Achse.
Bildquelle: Verknüpfung
Im 1D-Raum, das Wahrscheinlichkeitsdichtefunktion einer Gaußschen Verteilung ist gegeben durch:
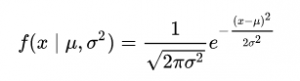
Feige. Wahrscheinlichkeitsdichtefunktion (PDF)
wobei μ den Mittelwert darstellt und σ2 repräsentiert die Varianz.
Dies würde jedoch nur für eine Variable in 1-D gelten. Bei zwei Variablen, Wir werden eine 3D-Glockenkurve anstelle einer 2D-Glockenkurve haben, wie unten gezeigt:
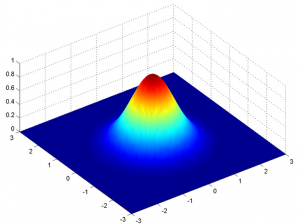
Die Wahrscheinlichkeitsdichtefunktion wäre gegeben durch:
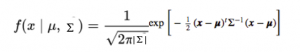
wobei x der Eingabevektor ist, μ ist der 2-D-Mittelwertvektor und Σ ist die Kovarianzmatrix 2 × 2. Wir können das Gleiche für die Abmessungen"Dimension" Es handelt sich um einen Begriff, der in verschiedenen Disziplinen verwendet wird, wie z.B. Physik, Mathematik und Philosophie. Er bezieht sich auf das Ausmaß, in dem ein Objekt oder Phänomen analysiert oder beschrieben werden kann. In der Physik, zum Beispiel, Es ist die Rede von räumlichen und zeitlichen Dimensionen, während es sich in der Mathematik auf die Anzahl der Koordinaten beziehen kann, die notwendig sind, um einen Raum darzustellen. Es zu verstehen, ist grundlegend für das Studium und... D.
Deswegen, für das multivariate Gauß-Modell, wir haben x und μ als Vektoren der Länge d, und Σ wäre ein dxd Kovarianzmatrix.
Deswegen, für einen Datensatz mit D Merkmale, wir hätten eine Mischung aus k Gaußsche Verteilungen (wo k repräsentiert die Anzahl der Cluster), jeweils mit Mittelwertvektor und Varianzmatrix ermittelt.
Aber unsere Frage ist: „Wie können wir den Mittelwert und die Varianz jedes Gaußschen bestimmen??“
Um diese Werte zu finden, Wir verwenden eine Technik namens Expectation-Maximization (IN).
Gaußsche Mischungsmodelle
Die Hauptannahme dieser Mischungsmodelle ist, dass es eine bestimmte Anzahl von Gauß-Verteilungen gibt, und jede dieser Verteilungen repräsentiert eine Gruppe. Deswegen, ein Gaußsches Mischungsmodell versucht, die Beobachtungen zu gruppieren, die zu einer einzelnen Verteilung gehören.
Gaußsche Mischmodelle sind probabilistische Modelle, die die GruppierungDas "Gruppierung" Es handelt sich um ein Konzept, das sich auf die Organisation von Elementen oder Individuen in Gruppen mit gemeinsamen Merkmalen oder Zielen bezieht. Dieses Verfahren wird in verschiedenen Disziplinen eingesetzt, einschließlich Psychologie, Pädagogik und Biologie, um die Analyse und das Verständnis von Verhaltensweisen oder Phänomenen zu erleichtern. Im Bildungsbereich, zum Beispiel, Gruppenbildung kann die Interaktion und das Lernen unter den Schülern verbessern, indem sie die Arbeit fördert.. Glätten, um Beobachtungen in verschiedene Gruppen zu verteilen, nämlich, verschiedene Gauß-Verteilungen.
Zum Beispiel, das Gaußsche Mischungsmodell von 2 Gaußsche Verteilungen
Wir haben zwei Gauß-Verteilungen: n (μ1, σ12) und N(μ2, σ22)
Hier, wir müssen insgesamt schätzen 5 Parameter:
= (P, μ1, σ12,μ2, σ22)
wobei p die Wahrscheinlichkeit ist, dass die Daten aus der ersten Gauß-Verteilung stammen und 1-p, dass sie aus der zweiten Gauß-Verteilung stammen.
Dann, die Wahrscheinlichkeitsdichtefunktion (PDF) des Mischungsmodells ist gegeben durch:
g (x |θ) = p1(x | μ1, σ12) + (1-P) g2(x | μ2, σ22 )
Ziel: Um eine gegebene Wahrscheinlichkeitsdichte besser anzupassen, indem man findet = (P, μ1, σ12, μ2, σ22) durch EM-Iterationen.
GMM-Implementierung in Python
Zeit, in den Code einzutauchen! Hier zur Umsetzung, wir nehmen das Sklearn-Bibliothek von Python.
Von sklearn, Wir verwenden die GaussianMixture-Klasse, die den EM-Algorithmus implementiert, um eine Mischung aus Gauss-Modellen anzupassen. Nach der Objekterstellung, Verwendung der GaussianMixture.fit Methode können wir ein Gaußsches Mischungsmodell aus den Daten von AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen.....
Paso 1: Importieren Sie die erforderlichen Pakete
numpy als np importieren
import matplotlib.pyplot als plt
aus sklearn.mixture importieren GaussianMixture
Paso 2: Erstellen Sie ein Objekt der Klasse Gaussian Mixture
gmm = Gaußsche Mischung(n_Komponenten = 2, Maut=0,000001)
Paso 3: passt das erstellte Objekt an den gegebenen Datensatz an
gmm.fit(np.expand_dims(Daten, 1))
Paso 4: Druckparameter von 2 ankommende Gaussianer
Gaussian_nr = 1
drucken('Eingabe Normal_distb {:}: μ = {:.2}, = {:.2}'.format("1", Mittelwert1, Standard_dev1))
drucken('Eingabe Normal_distb {:}: μ = {:.2}, = {:.2}'.format("2", Mittelwert2, Standard_dev2))
Ausgabe:

Eingabe Normal_distb 1: μ = 2.0, = 4.0

Eingabe Normal_distb 2: μ = 9.0, = 2.0
Paso 5: Druckparameter nach dem Mischen 2 Gaussianos
für mu, sd, p in zip(gmm.means_.flatten(), np.sqrt(gmm.covariances_.flatten()), gmm.gewichte_):
    drucken('Normal_distb {:}: μ = {:.2}, = {:.2}, Gewicht = {:.2}'.format(Gaussian_nr, mu, sd, P))
    g_s = stats.norm(mu, sd).pdf(x) * P
    plt.plot(x, g_s, Etikett="Gaussian sklearn");
    Gaussian_nr += 1
Produktion:
Normal_distb 1: μ = 1,7, = 3,8, Gewicht = 0,61
Normal_distb 2: μ = 8.8, = 2.2, Gewicht = 0.39
Paso 6: Zeichnen Sie die Verteilungsdiagramme
sns.distplot(Daten, Behälter=20, kde = Falsch, norm_hist=Wahr)
gmm_sum = np.exp([gmm.score_samples(e.umformen(-1, 1)) für e in x])
plt.plot(x, gmm_sum, Etikett="Gaußsche Mischung");
plt.legende();
Produktion:
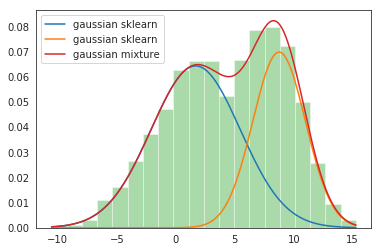
Damit ist unsere GMM-Implementierung abgeschlossen!!
Abschließende Anmerkungen
Danke fürs Lesen!
Wenn dir das gefallen hat und du mehr wissen möchtest, Besuchen Sie meine anderen Artikel zu Data Science und Machine Learning, indem Sie auf das klicken Verknüpfung
Kontaktieren Sie mich gerne unter Linkedin, Email.
Alles was nicht erwähnt wurde oder du deine Gedanken teilen möchtest? Fühlen Sie sich frei, unten einen Kommentar zu hinterlassen und ich melde mich bei Ihnen.
Über den Autor
Chirag Goyal
Heutzutage, Ich studiere meinen Bachelor of Technology (B.Tech) in Informatik und Ingenieurwissenschaften von Indisches Technologieinstitut Jodhpur (IITJ). Ich freue mich sehr über maschinelles Lernen, das tiefes LernenTiefes Lernen, Eine Teildisziplin der Künstlichen Intelligenz, verlässt sich auf künstliche neuronale Netze, um große Datenmengen zu analysieren und zu verarbeiten. Diese Technik ermöglicht es Maschinen, Muster zu lernen und komplexe Aufgaben auszuführen, wie Spracherkennung und Computer Vision. Seine Fähigkeit, sich kontinuierlich zu verbessern, wenn mehr Daten zur Verfügung gestellt werden, macht es zu einem wichtigen Werkzeug in verschiedenen Branchen, von Gesundheit... und Künstliche Intelligenz.
Die in diesem Artikel gezeigten Medien über Algorithmus zur Erwartungsmaximierung sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





