
Dieser Artikel wurde im Rahmen der Data Science Blogathon.
Einführung
Und wir lernen nebenbei.
Die Unternehmen, ähnlich, wenden ihre Erfahrungen aus der Vergangenheit auf die Entscheidungsfindung in Bezug auf Operationen und neue Initiativen an, zum Beispiel, bezogen auf die Kundenklassifizierung, Produkte, etc. Aber trotzdem, Hier wird es etwas komplexer, da mehrere Stakeholder beteiligt sind. Was ist mehr, Entscheidungen müssen aufgrund ihrer Breitenwirkung genau sein.
Mit der Entwicklung der digitalen Technologie, Menschen haben mehrere Vermögenswerte entwickelt; Maschinen sind eine davon. Wir haben gelernt (und wir machen weiter) Maschinen zu verwenden, um Daten mithilfe von Statistiken zu analysieren, um nützliche Informationen zu generieren, die bei der Entscheidungsfindung und Prognose helfen.
Maschinen zaubern nicht mit Daten, sie wenden einfache Statistiken an.
In diesem Kontext, Sehen wir uns einige häufig verwendete Algorithmen für maschinelles Lernen zur Klassifizierung an und versuchen wir zu verstehen, wie sie funktionieren und miteinander verglichen werden. Aber zuerst, Lassen Sie uns einige verwandte Konzepte verstehen.
Grundlegendes Konzept
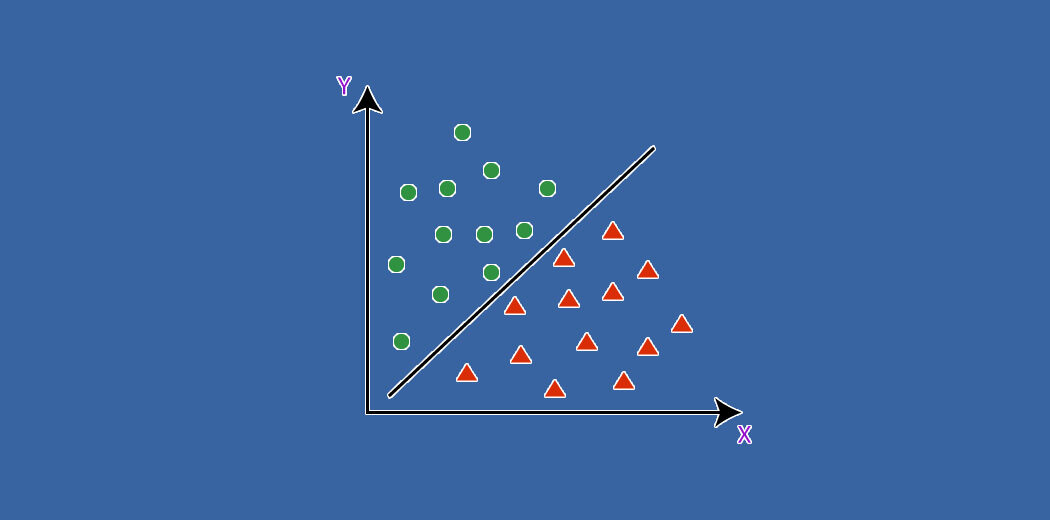
Das überwachtes LernenÜberwachtes Lernen ist ein Ansatz des maschinellen Lernens, bei dem ein Modell mit einem Satz von beschrifteten Daten trainiert wird. Jede Eingabe im Dataset ist mit einer bekannten Ausgabe verknüpft, So kann das Modell lernen, Ergebnisse für neue Eingaben vorherzusagen. Diese Methode wird häufig in Anwendungen wie der Bildklassifizierung eingesetzt., Spracherkennung und Trendvorhersage, und unterstreicht seine Bedeutung in... se define como la categoría de análisis de datos donde el resultado objetivo es conocido o etiquetado, zum Beispiel, ob der Kunde oder die Kunden ein Produkt gekauft haben oder nicht. Aber trotzdem, wenn die Absicht besteht, sie basierend auf dem, was jeder gekauft hat, zu gruppieren, dann wird es unbeaufsichtigt. Dies kann getan werden, um die Beziehung zwischen Kunden und dem, was sie kaufen, zu erkunden.
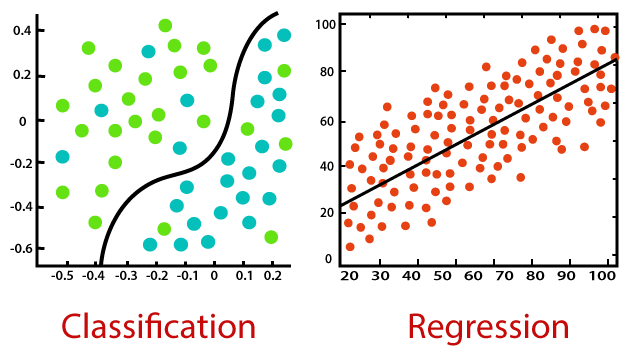
Sowohl Klassifikation als auch Regression gehören zum überwachten Lernen, aber das erste gilt, wenn das Ergebnis endlich ist, während letzteres für unendlich mögliche Ergebniswerte gilt (zum Beispiel, den Dollarwert des Kaufs vorhersagen).
La distribución normal es la conocida distribución en forma de campana de una VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... continua. Dies ist eine natürliche Erweiterung der Werte, die ein Parameter normalerweise annimmt.
Da Prädiktoren unterschiedliche Wertebereiche haben können, zum Beispiel, Das menschliche Gewicht kann bis zu . betragen 150 (kg), aber die typische höhe ist nur bis zu 6 (Kuchen); Werte brauchen Skala (um den jeweiligen Mittelwert) um sie vergleichbar zu machen.
Kollinearität liegt vor, wenn zwei oder mehr Prädiktoren verwandt sind, nämlich, ihre Werte rücken zusammen.
Ausreißer sind außergewöhnliche Werte eines Prädiktors, das kann stimmen oder nicht.
Logistische Regression
Die logistische Regression nutzt die Kraft der Regression, um eine Klassifikation durchzuführen, und macht dies seit mehreren Jahrzehnten sehr gut., um unter den beliebtesten Modellen zu bleiben. Einer der Hauptgründe für den Erfolg des Modells ist seine Erklärbarkeit, nämlich, weisen Sie auf den Beitrag einzelner Prädiktoren hin, quantitativ.
Im Gegensatz zur Regression, die kleinste Quadrate verwendet, das Modell verwendet die maximale Wahrscheinlichkeit, um eine Sigmoid-Kurve in die Verteilung der Zielvariablen einzupassen.
Angesichts der Anfälligkeit des Modells für Multikollinearität, Die schrittweise Anwendung stellt sich als besserer Ansatz heraus, um die gewählten Prädiktoren des Modells zu finalisieren.
Der Algorithmus ist eine beliebte Wahl bei vielen Aufgaben zur Verarbeitung natürlicher Sprache, zum Beispiel, toxische Spracherkennung, Klassifizierung von Themen, etc.
Künstliche neurale Netzwerke
Künstliche neurale Netzwerke (ANN), so genannt, weil sie versuchen, das menschliche Gehirn nachzuahmen, eignen sich für große und komplexe Datensätze. Seine Struktur besteht aus Schichten von Zwischenknoten (ähnlich wie Neuronen) die zusammen auf die mehreren Eingänge und den Zielausgang abgebildet werden.
Es ist ein selbstlernender Algorithmus, da es mit einer ersten Zuordnung beginnt (zufällig) Ja, seit damals, Passen Sie bezogene Gewichtungen iterativ automatisch an, um die gewünschte Ausgabe für alle Register fein abzustimmen. Las múltiples capas brindan una capacidad de tiefes LernenTiefes Lernen, Eine Teildisziplin der Künstlichen Intelligenz, verlässt sich auf künstliche neuronale Netze, um große Datenmengen zu analysieren und zu verarbeiten. Diese Technik ermöglicht es Maschinen, Muster zu lernen und komplexe Aufgaben auszuführen, wie Spracherkennung und Computer Vision. Seine Fähigkeit, sich kontinuierlich zu verbessern, wenn mehr Daten zur Verfügung gestellt werden, macht es zu einem wichtigen Werkzeug in verschiedenen Branchen, von Gesundheit... para poder extraer características de nivel superior de los datos sin procesar.
Der Algorithmus bietet eine hohe Vorhersagegenauigkeit, aber es ist notwendig, numerische Eigenschaften zu skalieren. Es hat breite Anwendungen in zukünftigen Bereichen, einschließlich Computer Vision, PNL, Spracherkennung, etc.
Zufälliger Wald
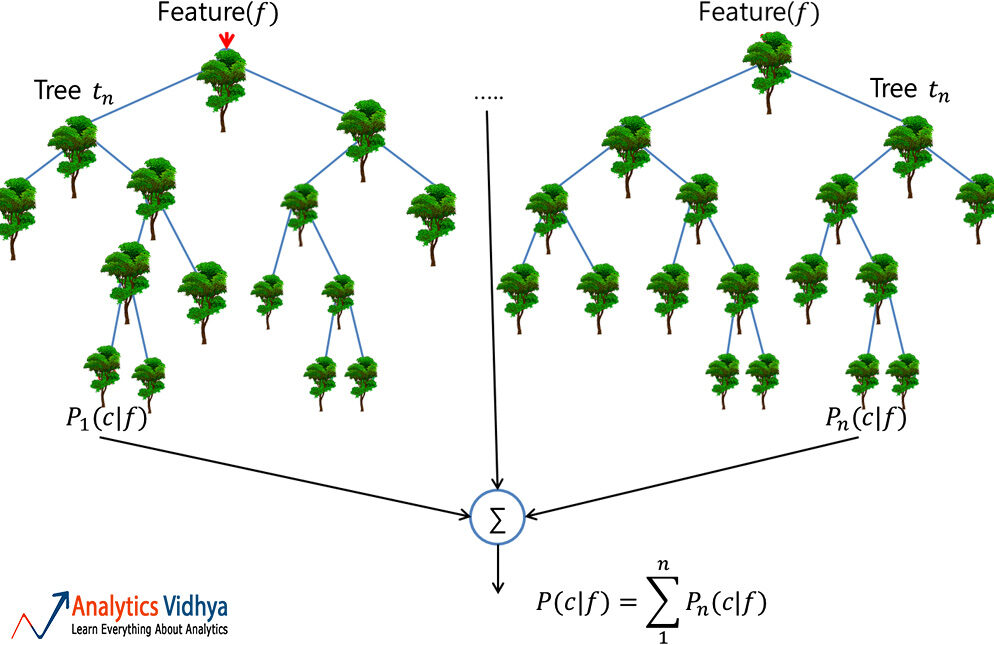
Ein Random Forest ist ein zuverlässiger Satz von mehreren Entscheidungsbäumen (o WARENKORB); obwohl beliebter für die Klassifizierung als Regressions-Apps. Hier, einzelne Bäume werden durch Absacken gebaut (nämlich, Aggregation von Bootstraps, die nichts anderes als mehrere Stream-Datensätze sind, die durch Datensatz-Sampling mit Ersetzung erstellt wurden) und mit weniger Funktionen aufteilen. Der vielfältige Wald, der aus unkorrelierten Bäumen resultiert, weist eine reduzierte Variation auf; Daher, ist robuster gegenüber Datenänderungen und verlagert seine Vorhersagegenauigkeit auf neue Daten.
Aber trotzdem, der Algorithmus funktioniert nicht gut für Datensätze mit vielen Ausreißern, etwas, das vor dem Erstellen des Modells angegangen werden muss.
Es hat breite Anwendungsmöglichkeiten im Finanzbereich, Einzelhändler, Luftfahrt und viele andere.
Bayes ingenuo
Auch wenn wir dies vielleicht nicht erkennen, Dies ist der am häufigsten verwendete Algorithmus zum Filtern von Spam-E-Mails!!
Wenden Sie die sogenannte Posterior-Wahrscheinlichkeit an, indem Sie den Satz von Bayes verwenden, um unstrukturierte Daten zu kategorisieren. Und dabei, nimmt naiv an, dass Prädiktoren unabhängig sind, was kann nicht wahr sein.
El modelo funciona bien con un pequeño conjunto de datos de AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen...., vorausgesetzt, dass alle Klassen des kategorialen Prädiktors vorhanden sind.
KNN
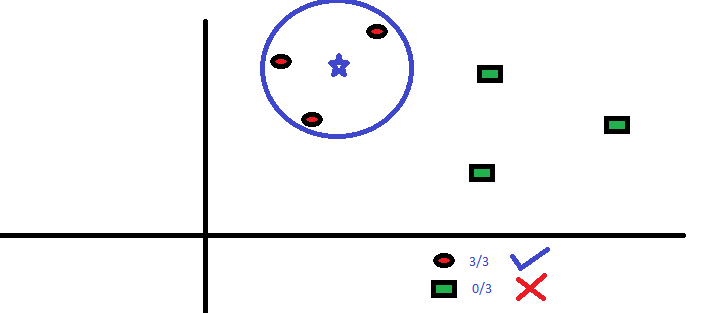
Der K-Nemost Neighbor Algorithmus (KNN) prognostiziert basierend auf der angegebenen Zahl (k) der nächsten benachbarten Datenpunkte. Hier, Die Datenvorverarbeitung ist von Bedeutung, da sie sich direkt auf Entfernungsmessungen auswirkt. Nicht wie andere, das Modell hat keine mathematische Formel, noch beschreibende Fähigkeit.
Hier, der Parameter ‚k‘ muss mit Bedacht gewählt werden; da ein niedriger als optimaler Wert zu einem Bias führt, während ein höherer Wert die Genauigkeit der Vorhersage beeinflusst.
Es ist ein einfaches und ziemlich genaues Modell, das meistens für kleinere Datensätze bevorzugt wird, aufgrund der umfangreichen Berechnungen, die bei kontinuierlichen Prädiktoren erforderlich sind.
Auf einer einfachen Ebene, KNN kann in einer bivariaten Vorhersageumgebung verwendet werden, zum Beispiel, Größe und Gewicht, um das Geschlecht anhand einer Probe zu bestimmen.
Alles zusammenfügen
Die Leistung eines Modells hängt hauptsächlich von der Art der Daten ab. Da Geschäftsdatensätze mehrere Prädiktoren haben und komplex sind, Es ist schwierig, einen Algorithmus zu finden, der immer gut funktioniert. Deswegen, die übliche Praxis ist, mehrere Modelle auszuprobieren und das richtige zu finden.
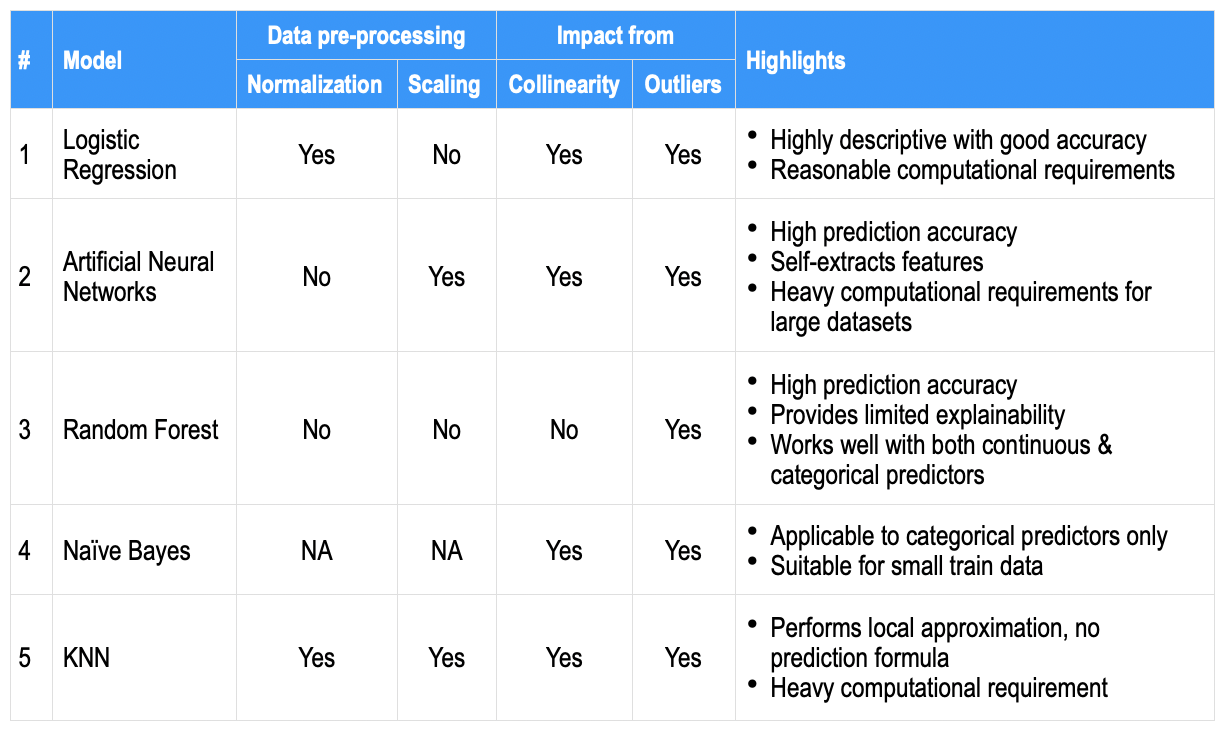
Als High-Level-Vergleich, Los aspectos más destacados que se encuentran generalmente para cada uno de los algoritmos anteriores se anotan a continuación en algunos ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten.... comunes; als schnelle Referenz-Schnappschuss dienen.
Was ist mehr, es gibt mehrere hebel, zum Beispiel, Datenausgleich, Zurechnung, Kreuzvalidierung, zwischen Algorithmen setzen, größter Zugdatensatz, etc. plus Modell-Hyperparameter-Tuning, das kann verwendet werden, um Präzision zu gewinnen. Während Vorhersagegenauigkeit am wünschenswertesten sein kann, Unternehmen suchen auch nach prominenten Prädiktoren, die dazu beitragen (nämlich, ein beschreibendes Modell oder seine daraus resultierende Erklärbarkeit).
Schließlich, maschinelles Lernen ermöglicht es dem Menschen, quantitativ zu entscheiden, vorhersagen und über das Offensichtliche hinausschauen, wenn auch manchmal in bisher unbekannten Aspekten.





