
Einführung
Konvolutionelle neuronale Netze (CNN): das Konzept hinter den jüngsten Fortschritten und Entwicklungen in der tiefes LernenTiefes Lernen, Eine Teildisziplin der Künstlichen Intelligenz, verlässt sich auf künstliche neuronale Netze, um große Datenmengen zu analysieren und zu verarbeiten. Diese Technik ermöglicht es Maschinen, Muster zu lernen und komplexe Aufgaben auszuführen, wie Spracherkennung und Computer Vision. Seine Fähigkeit, sich kontinuierlich zu verbessern, wenn mehr Daten zur Verfügung gestellt werden, macht es zu einem wichtigen Werkzeug in verschiedenen Branchen, von Gesundheit....
CNN hat neue Maßstäbe gesetzt und den Thron bestiegen, um die neueste Technologie zu werden. Computer Vision Technik. Unter den verschiedenen Arten von Neuronale Netze (andere umfassen rekurrente neuronale Netze (RNN), Langzeit-Kurzzeitgedächtnis (LSTM), künstliche neurale Netzwerke (ANN), etc.), CNNs sind mit Abstand die beliebtesten.
Diese konvolutionellen neuronalen Netzmodelle sind im Bilddatenraum allgegenwärtig. Sie funktionieren phänomenal gut bei Computer-Vision-Aufgaben wie der Bildklassifizierung, Objekterkennung, Bilderkennung, etc.
Dann, Wo können Sie Ihre CNN-Fähigkeiten üben?? Gut, Sie sind an der richtigen Stelle!
Es gibt mehrere Datensätze, die Sie nutzen können, um konvolutionelle neuronale Netze anzuwenden. Hier sind drei beliebte Datensätze:
In diesem Artikel, Wir werden Bildklassifizierungsmodelle mit CNN für jeden dieser Datensätze erstellen. Korrekt! Wir werden MNSIT erkunden, CIFAR-10 und ImageNet zum Verständnis, auf praktische Weise, wie CNN für die Bildklassifizierungsaufgabe funktioniert.
Sie können alles über Convolutional Neural Networks erfahren (CNN) in diesem kostenlosen Kurs: Konvolutionelle neuronale Netze (CNN) von Anfang an
Meine Inspiration zum Schreiben dieses Artikels ist es, der Community zu helfen, theoretisches Wissen praktisch anzuwenden. Dies ist eine sehr wichtige Übung, da es Ihnen nicht nur hilft, ein tieferes Verständnis des zugrunde liegenden Konzepts zu entwickeln, es werden Ihnen auch praktische Details vermittelt, die nur durch die Umsetzung des Konzepts erlernt werden können.
Wenn Sie neu in der Welt der neuronalen Netze sind, CNN, Bildklassifizierung, Ich empfehle Ihnen, diese ausgezeichneten detaillierten Tutorials zu befolgen:
Und wenn Sie Computer Vision und Deep Learning in der Tiefe erlernen möchten, Sie sollten sich unsere beliebten Kurse ansehen:
Inhaltsverzeichnis
- Verwenden von CNN zum Klassifizieren handgeschriebener Ziffern im MNIST-Datensatz
- Bildidentifikation aus dem CIFAR-10-Datensatz mit CNN
- Bildkategorisierung des ImageNet-Datensatzes mit CNN
- Wohin von hier aus?
Notiz: In diesem Artikel werde ich Keras verwenden, um die Bildklassifizierung mit CNN zu demonstrieren. Keras ist ein hervorragendes Framework zum Lernen, wenn Sie gerade erst mit Deep Learning beginnen..
Verwenden von CNN zum Klassifizieren handgeschriebener Ziffern im MNIST-Datensatz

MNIST (Nationales modifiziertes Institut für Standards und Technologie) ist ein bekannter Datensatz, der in verwendet wird Computer Vision die von Yann Le Cun et . gebaut wurde. Alabama. Es besteht aus Bildern, die handgeschriebene Ziffern (0-9), aufgeteilt in eine Menge von AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen.... von 50,000 Bilder und ein Test-Set von 10,000 wo jedes Bild hat 28 x 28 Pixelbreite und -höhe.
Dieser Datensatz wird häufig verwendet, um einen Algorithmus zu üben, der für die Bildklassifizierung erstellt wurde., da der Datensatz recht einfach zu erobern ist. Deswegen, Ich empfehle, dass dies Ihr erster Datensatz ist, wenn Sie nur im Feld experimentieren.
MNIST wird standardmäßig mit Keras geliefert und Sie können die Zug- und Testdateien einfach mit wenigen Codezeilen laden:
aus keras.datasets importieren mnist

# Laden des Datensatzes
(X_Zug, y_train), (X_test, y_test) = mnist.load_data()
# lassen Sie uns die Form des Datensatzes ausdrucken
drucken("X_Zug-Form", X_train.shape)
drucken("y_Zugform", y_train.shape)
drucken("X_Testform", X_test.shape)
drucken("y_Testform", y_test.shape)
Hier ist die X-Form (Merkmale) und und (Zielsetzung) für Trainings- und Validierungsdaten:
X_Zug-Form (60000, 28, 28)
y_Zugform (60000,)
X_Testform (10000, 28, 28)
y_Testform (10000,)
Vor dem Training eines CNN-Modells, Lass uns ein Basismodell bauen Vollständig verbundenes neuronales Netzwerk für den Datensatz. Die grundlegenden Schritte zum Aufbau eines Bildklassifikationsmodells unter Verwendung eines rotes neuronalesNeuronale Netze sind Rechenmodelle, die von der Funktionsweise des menschlichen Gehirns inspiriert sind. Sie nutzen Strukturen, die als künstliche Neuronen bekannt sind, um Daten zu verarbeiten und daraus zu lernen. Diese Netze sind grundlegend im Bereich der künstlichen Intelligenz, Dies ermöglicht erhebliche Fortschritte bei Aufgaben wie der Bilderkennung, Verarbeitung natürlicher Sprache und Vorhersage von Zeitreihen, unter anderen. Ihre Fähigkeit, komplexe Muster zu erlernen, macht sie zu mächtigen Werkzeugen.. Sohn:
- Reduzieren Sie die Abmessungen des Eingabebilds auf 1D (Pixel breit x Pixel hoch)
- Bildpixelwerte normalisieren (Teilen durch 255)
- One-Hot-Kodierung der kategorialen Spalte
- Erstellen Sie eine Modellarchitektur (sequentiell) mit dichten Schichten
- Trainieren Sie das Modell und treffen Sie Vorhersagen
Dann, wir zeigen Ihnen, wie Sie ein neuronales Netzmodell für MNIST . erstellen können. Ich habe die relevanten Teile des Codes zum besseren Verständnis kommentiert:
Nach dem Ausführen des obigen Codes, festgestellt, dass wir eine gute Validierungsgenauigkeit von etwa 97% leicht.
Lassen Sie uns den obigen Code ändern, um a zu erstellen CNN Modell.
Einer der Hauptvorteile der Verwendung von CNN gegenüber NN besteht darin, dass die Eingabebilder nicht auf 1D abgeflacht werden müssen, da sie mit 2D-Bilddaten arbeiten können. Dies hilft, die Eigenschaften zu erhalten „räumlich“ der Bilder.
Hier ist der vollständige Code für das CNN-Modell:
Obwohl unsere maximale Validierungspräzision mit einem einfachen neuronalen Netzwerkmodell rund war 97%, Das Modell von CNN kann mehr als 98% mit einer einzigen Faltungsschicht.
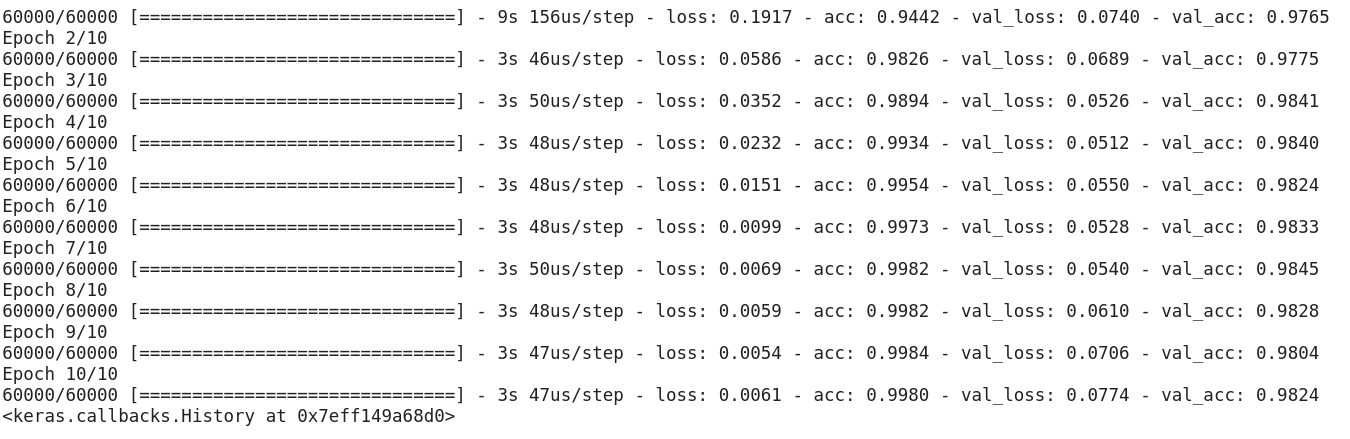
Sie können fortfahren und weitere Conv2D-Ebenen hinzufügen, und spielen auch mit den Hyperparametern des CNN-Modells.
Bildidentifikation aus dem CIFAR-10-Datensatz mit CNN
MNIST ist ein anfängerfreundlicher Datensatz in Computer Vision. Es ist einfach, eine Punktzahl von mehr als zu erreichen 90% bei der Validierung mit einem CNN-Modell. Aber, Was ist, wenn Sie kein Anfänger sind und etwas Herausforderndes brauchen, um Ihre Konzepte in die Praxis umzusetzen??
Das ist, wo die CIFAR-10-Datensatz betritt die Szene!

So arbeiten die Entwickler hinter CIFAR (Kanadisches Institut für fortgeschrittene Forschung) den Datensatz beschreiben:
Der CIFAR-10-Datensatz besteht aus 60.000 Farbbilder von 32 x 32 In 10 Lektionen, mit 6.000 Bilder pro Klasse. Es gibt 50.000 Trainingsbilder und 10.000 Testbilder.
Die wichtigen Punkte, die diesen Datensatz vom MNIST unterscheiden, sind:
- Die Bilder sind in CIFAR-10 gefärbt, verglichen mit der Schwarz-Weiß-Textur von MNIST
- Jedes Bild ist von 32 x 32 Pixel
- 50.000 Trainingsbilder und 10.000 Testbilder
Jetzt, Diese Bilder wurden bei unterschiedlichen Lichtverhältnissen und aus verschiedenen Blickwinkeln aufgenommen, und da es sich um farbige Bilder handelt, Sie werden sehen, dass es viele Variationen in der Farbe ähnlicher Objekte gibt (zum Beispiel, die Farbe des Meerwassers). Wenn Sie das einfache verwenden CNN Architektur, die wir im obigen MNIST-Beispiel gesehen haben, Sie erhalten eine niedrige Validierungsgenauigkeit von etwa 60%.
Aus diesem Grund empfehle ich CIFAR-10 als guten Datensatz, um Ihre Hyperparameter-Tuning-Fähigkeiten für CNN zu üben.. Das Gute ist, dass, wie MNIST, CIFAR-10 ist auch in Keras . erhältlich.
Sie können den Datensatz einfach mit dem folgenden Code laden:
aus keras.datasets importieren cifar10
# Laden des Datensatzes
(X_Zug, y_train), (X_test, y_test) = cifar10.load_data()
Dann, Wir zeigen Ihnen, wie Sie ein anständiges CNN-Modell bauen können (um die 78-80% in der Validierung) für CIFAR-10. Beachten Sie, wie die Werte der Formen aktualisiert wurden von (28, 28, 1) ein (32, 32, 3) je nach größe der bilder:
Das habe ich im Modell geändert:
- Die Anzahl der Conv2D-Ebenen wurde erhöht, um ein tieferes Modell zu erstellen
- Größere Anzahl von Filtern, um mehr Funktionen zu kennen
- hinzugefügter Abbruch für RegulierungDie Regularisierung ist ein administrativer Prozess, der darauf abzielt, die Situation von Personen oder Organisationen zu formalisieren, die außerhalb des gesetzlichen Rahmens tätig sind. Dieses Verfahren ist unerlässlich, um Rechte und Pflichten zu gewährleisten, sowie zur Förderung der sozialen und wirtschaftlichen Inklusion. In vielen Ländern, Die Regularisierung wird in Migrationskontexten angewendet, Arbeit und Steuern, denjenigen, die sich in irregulären Situationen befinden, den Zugang zu Leistungen zu ermöglichen und sich vor möglichen Sanktionen zu schützen....
- Dichtere Schichten hinzugefügt
Genauigkeit des Trainings und der Validierung in allen Altersstufen:
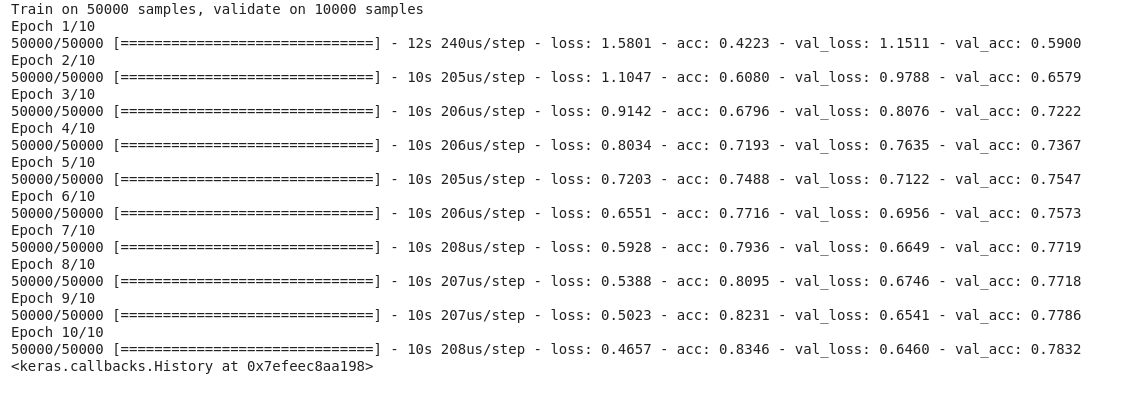
Sie können diese Leistung leicht in den Schatten stellen, indem Sie das ältere Modell tunen. Sobald Sie CIFAR-10 . beherrschen, In Keras ist auch CIFAR-100 erhältlich, mit dem Sie mehr üben können. Da hat es 100 Lektionen, Es wird keine leichte Aufgabe sein!
Kategorisieren von ImageNet-Bildern mit CNN
Nachdem Sie nun MNIST und CIFAR-10 gemeistert haben, Lass uns dieses Problem auf eine höhere Ebene bringen. Hier, wir werden uns den berühmten ImageNet-Datensatz ansehen.

ImageNet ist der DatenbankEine Datenbank ist ein organisierter Satz von Informationen, mit dem Sie, Effizientes Verwalten und Abrufen von Daten. Einsatz in verschiedenen Anwendungen, Von Unternehmenssystemen bis hin zu Online-Plattformen, Datenbanken können relational oder nicht-relational sein. Das richtige Design ist entscheidend für die Optimierung der Leistung und die Gewährleistung der Informationsintegrität, und erleichtert so eine fundierte Entscheidungsfindung in verschiedenen Kontexten.... Hauptgrund hinter dem ImageNet Large-Scale Reconnaissance Challenge (ILSVRC). Das ist wie bei Olympia Computer Vision. Das ist der Wettbewerb, der es geschafft hat CNN zum ersten Mal und jedes Jahr beliebt, Top-Forschungsteams aus Industrie und Wissenschaft konkurrieren mit ihren besten Algorithmen zu Computer-Vision-Aufgaben.
Über den ImageNet-Datensatz
Der ImageNet-Datensatz hat mehr als 14 Millionen Bilder, handbeschriftet in 20.000 Kategorien.
Was ist mehr, im Gegensatz zu den MNIST- und CIFAR-10-Datensätzen, die wir bereits besprochen haben, die Bilder in ImageNet haben eine AuflösungDas "Auflösung" bezieht sich auf die Fähigkeit, feste Entscheidungen zu treffen und gesetzte Ziele zu erreichen. Im persönlichen und beruflichen Kontext, Dabei geht es darum, klare Ziele zu definieren und einen Aktionsplan zu entwickeln, um diese zu erreichen. Entschlossenheit ist entscheidend für persönliches Wachstum und Erfolg in verschiedenen Lebensbereichen, denn es ermöglicht Ihnen, Hindernisse zu überwinden und sich auf das zu konzentrieren, was wirklich wichtig ist.... anständig (224 x 224) und das fordert uns heraus: 14 Millionen Bilder, jeder von 224 von 224 Pixel. Die Verarbeitung eines Datensatzes dieser Größe erfordert viel Rechenleistung an CPUs, GPU und RAM.
Der Nachteil: das ist vielleicht zu viel für einen alltäglichen Laptop. Dann, Was ist die Problemumgehung? Wie kann ein Enthusiast mit dem ImageNet-Datensatz arbeiten??
Hier kommt der Imagenette-Datensatz von Fast.ai ins Spiel.
Imagenette ist ein Datensatz, der aus der großen Bildersammlung von ImageNet stammt. Der Grund für die Einführung von Imagenette ist, dass Forscher und Studenten mit Bildern auf ImageNet-Ebene üben können, ohne so viele Computerressourcen zu benötigen..
In den Worten von Jeremy Howard selbst:
"Mir (Jeremy Howard, nämlich) Ich habe Imagenette in erster Linie entwickelt, weil ich einen kleinen Vision-Datensatz wollte, mit dem ich schnell sehen kann, ob meine Algorithmus-Ideen eine Chance haben, zu funktionieren. Sie tun es normalerweise nicht, Aber das Testen auf Imagenet dauert lange, bis ich es herausgefunden habe, zumal ich mich für Algorithmen interessiere, die besonders gut in der Ende des Trainings.
Aber ich denke, das kann auch für andere ein nützlicher Datensatz sein „.
Und das werden wir auch zum Üben nutzen!
1. Laden Sie den Imagenette-Datensatz herunter
So erhalten Sie den Datensatz (Befehle für Ihr Terminal):
$ wget https://s3.amazonaws.com/fast-ai-imageclas/imagenette2.tgz
$ tar -xf imagenette2.tgz
Nachdem Sie den Datensatz heruntergeladen haben, Sie werden feststellen, dass Sie zwei Ordner haben: „Bahn“ Ja „val“. Diese enthalten jeweils das Trainings- und Validierungsset. In jedem Ordner, es gibt separate Ordner für jede Klasse. Hier ist die Zuordnung der Klassen:
Diese Klassen haben dieselbe ID im ursprünglichen ImageNet-Datensatz. Jede der Klassen hat ungefähr 1000 Bilder, somit, allgemein, ist ein ausgewogener Datensatz.

2. Laden von Bildern mit ImageDataGenerator
Keras hat diese nützliche Funktion zum Laden großer Bilder (wie die, die wir hier haben) ohne RAM-Maximierung, mache es in kleinen Chargen. ImageDataGenerator in Kombination mit fit_generator bietet diese Funktionalität:
Der ImageDataGenerator selbst leitet die Klassenbezeichnungen und die Anzahl der Klassen aus den Ordnernamen ab.

3. Erstellen eines grundlegenden CNN-Modells für die Bildklassifizierung
Lassen Sie uns ein grundlegendes CNN-Modell für unseren Imagenette-Datensatz erstellen (zum Zweck der Klassifizierung von Bildern):
Wenn wir die Validierungspräzision des Vorgängermodells vergleichen, werde das erkennen, obwohl es eine tiefere Architektur ist als die, die wir bisher verwendet haben, wir können nur eine Validierungsgenauigkeit von etwa 40-50%.

Das kann viele Gründe haben, da unser Modell nicht komplex genug ist, um die zugrunde liegenden Muster der Bilder zu lernen, oder vielleicht sind die Trainingsdaten zu klein, um genau zwischen den Klassen zu verallgemeinern.
Steig auf: Transfer-Lernen.
4. Uso de Transfer Learning (VGG16) um die Genauigkeit zu verbessern
VGG16 ist eine CNN-Architektur, die der erste Zweitplatzierte in der 2014 ImageNet-Herausforderung. Es wurde von der Visual Graphics Group in Oxford entworfen und hat 16 Schichten insgesamt, mit 13 Faltungsschichten. Wir werden die zuvor trainierten Gewichte dieses Modells laden, damit wir die nützlichen Funktionen, die dieses Modell gelernt hat, für unsere Aufgabe verwenden können..
VGG16 Gewichte herunterladen
aus keras.applications importieren VGG16

# include top sollte False sein, um die Softmax-Schicht zu entfernen
pretrained_model = VGG16(include_top=Falsch, Gewichte="imagenet")
pretrained_model.summary()
Hier ist die Architektur des Modells:

Generieren Sie Funktionen aus VGG16
Lassen Sie uns nützliche Funktionen extrahieren, die VGG16 bereits aus den Bildern in unserem Datensatz kennt:
aus keras.utils importieren nach_categorical
# Zug- und Val-Merkmale extrahieren
vgg_features_train = pretrained_model.predict(Bahn)
vgg_features_val = pretrained_model.predict(val)
# OHE-Zielspalte
train_target = to_categorical(train.labels)
val_target = to_categorical(Wertetiketten)
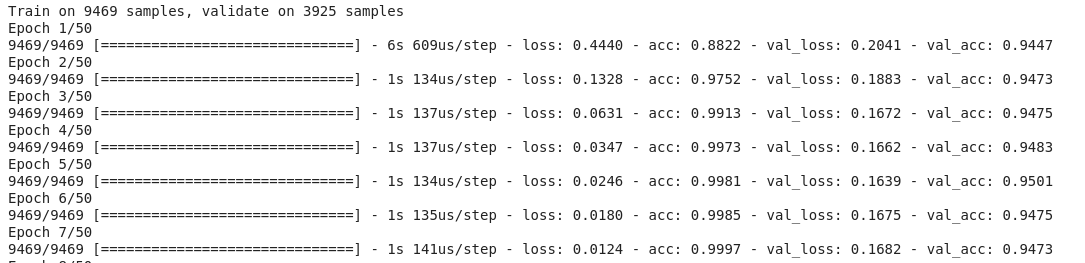
Beachten Sie, wie schnell Ihr Modell zu konvergieren beginnt. Alleine 10 Epochen, hat eine Validierungsgenauigkeit von mehr als 94%. Ist es nicht erstaunlich?
Falls Sie den Imagenette-Datensatz beherrschen, Fastai hat auch zwei Varianten veröffentlicht, die Klassen enthalten, die Sie nur schwer klassifizieren können:
- Imagewoof: 10 Arten von Hunderassen, ein schwieriger zu klassifizierendes Problem
- Imagen Net („wang“): Eine Kombination aus Imagenette und Imagewoof und ein paar Tricks, die das Problem komplizierter machen
Wohin von hier aus?
Zusätzlich zu den oben genannten Datensätzen, Sie können auch die folgenden Datensätze verwenden, um Computer Vision Algorithmen. Eigentlich, betrachte es als Herausforderung. Können Sie Ihr Wissen über CNN anwenden, um die Benchmark-Punktzahl in diesen Datensätzen zu übertreffen??
- Mode MNIST – Datensatz ähnlich wie MNIST für Bekleidung und Bekleidung. Statt Ziffern, die bilder zeigen eine art von kleidung (T-Shirt, Hose, Handtasche, etc.)
- Caltech 101 – Ein weiterer herausfordernder Datensatz, den ich für die Bildklassifizierung gefunden habe
Ich schlage das auch vor, bevor Sie sich für Transfer-Lernen entscheiden, Versuchen Sie, Ihre grundlegenden CNN-Modelle zu verbessern. Sie können von VGG16-Architekturen lernen, ZFNet, etc. für einige Hinweise zum Hyperparameter-Tuning und Sie können dasselbe verwenden ImageDataGenerator um Ihre Bilder zu vergrößern und die Größe des Datensatzes zu erhöhen.





