
Dieser Artikel wurde im Rahmen der Data Science Blogathon.
Einführung
Zu den Hauptzielen der Validierung eines Modells gehört das Testen der konzeptionellen Solidität des Modells und der kontinuierlichen Zweckmäßigkeit., einschließlich Identifizierung potenzieller Risiken und Einschränkungen. Diese Tests müssen eine wirksame Herausforderung für das bestehende Produktionsmodell zum Nutzen seiner Verbesserung darstellen., Risikominderung. Die Daten für diese Übung stammen aus hier.
Validierungsrahmen
Die folgenden Tests wurden durchgeführt, um die Ergebnisse des Modells zu validieren:
- Modellvariablen: NS, Linearität und VIF
- 3. Modell fit: AUROC-Grafik, Gini, KS und Gain und Lift
- 4. Modelltests: Sensitivitätsanalyse
- 5. Stabilitätskoeffizient: Signalstabilität und Koeffizientenstabilität
2.1 Datenprüfungen
Abhängigen Variablen
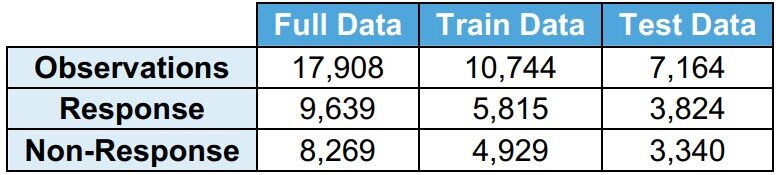
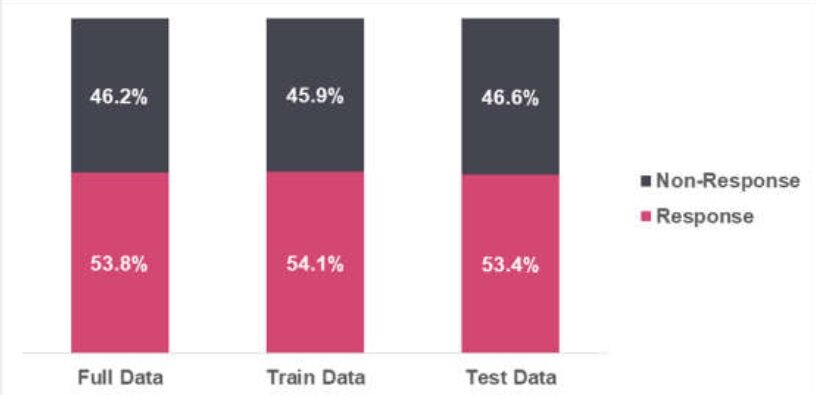
Es wird beobachtet, dass die Antwortverteilung (Y = 1) und keine antwort (Y = 0) es ist sehr ähnlich zwischen vollständigen Daten, Zugdaten und Testdaten.
· Die Antwort (Y = 1) zeigt an, dass der Antragsteller das Darlehen beantragt hat
· Unbeantwortet (Y = 0) zeigt an, dass der Antragsteller das Darlehen nicht beantragt hat
Unabhängige Variablen
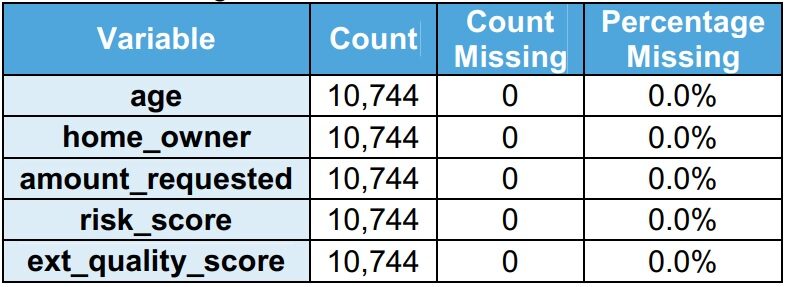
Zu den unabhängigen Variablen gehören persönliche und finanzielle Informationen. Risikobewertungen werden verwendet, um das Modell zu entwickeln. Es gibt 5 unabhängige Variablen im Modell.
Es wird beobachtet, dass im Zugdatensatz keine fehlenden Werte vorhanden sind.
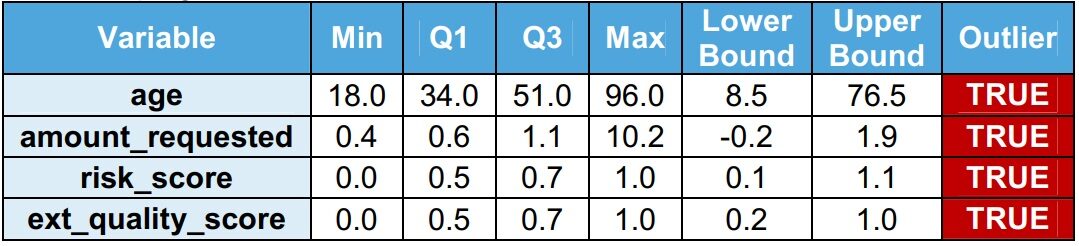
Es wird beobachtet, dass es Ausreißer im Zugdatensatz gibt. Der Bereich zwischen Quartilen (IQR = Q3 – Q1) wird verwendet, um die Verkaufsstellen zu identifizieren. Ausreißer sind Werte größer als die Obergrenze (Q1 + 1,5 x IQR) oder Werte niedriger als die untere Grenze (Q1 – 1,5 x IQR). Das Validierungsteam empfiehlt, Ausreißer vor der Entwicklung des Modells zu adressieren.
2.2. Modellvariablen
Informationswert (NS)
von statsmodels.stats.outliers_influence import variance_inflation_factor
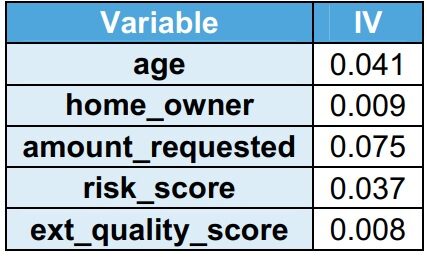
El poder explicativo de la VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... se captura mediante IV. Mit zunehmender Aussagekraft der Variablen, erhöht IV. Es wird beobachtet, dass alle Variablen IV . haben <0.1, weist darauf hin, dass sie im Zugdatensatz eine geringe Aussagekraft haben.
Linearität
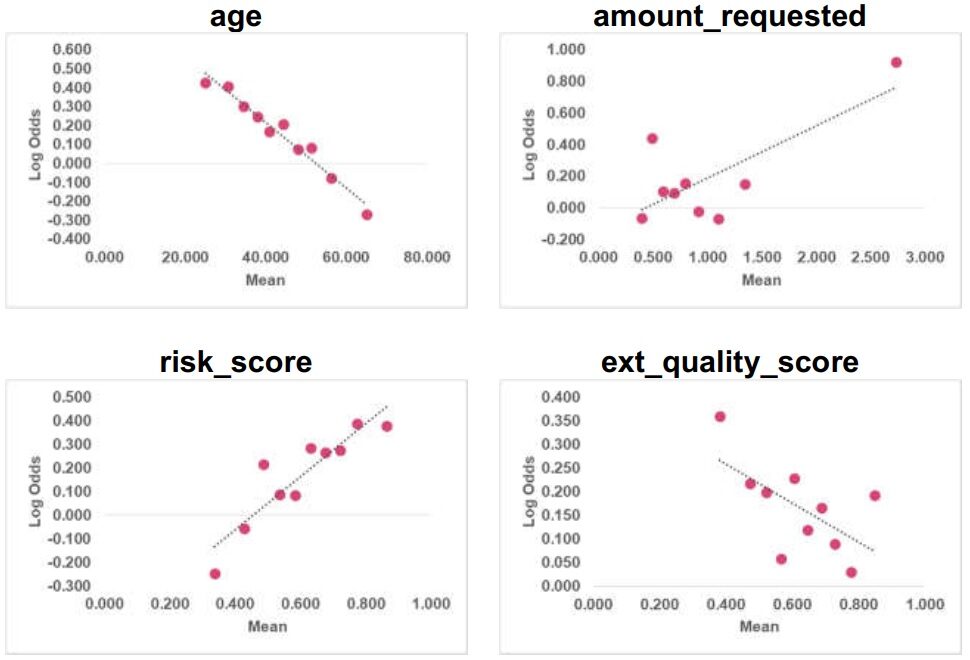
Paso 1: machen 10 Container für jede numerische Variable
Paso 2: für jedes Intervall, Berechnen Sie den Mittelwert der Variablen und die entsprechenden Log-Wahrscheinlichkeiten
Die Linearität der numerischen Variablen wird überprüft (Alter, angeforderter Betrag, risk_score und quality_score_ext) in den Zugdaten. es wird beobachtet, dass es wirkt & risk_score son lineales y number_requested & ext_quality_score kein Sohn lineales. Das Validierungsteam empfiehlt, die Transformationen zu testen, um eine lineare Beziehung zu erhalten.
Abweichungsinformationsfaktor (LEBHAFT)
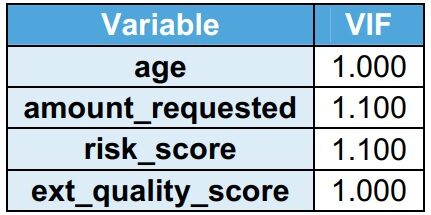
VIF zeigt Multikollinearität zwischen unabhängigen Variablen an. Es wird beobachtet, dass sein VIF kleiner ist als 2 en el conjunto de datos de AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen..... VIF kleiner als 2 zeigt keine Multikollinearität an. Hausbesitzer ist eine Flagge, Daher, nicht berücksichtigt für VIF.
2.3 Modell fit
AU-ROC
sklearn.metrics.auc(x, Ja)
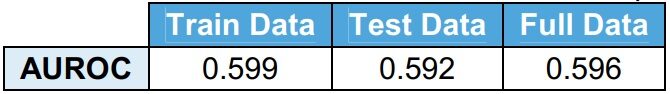
Die Fläche unter der Empfänger-Operator-Kurve (AUROC) wird verwendet, um die Vorhersagekraft des Modells zu messen. AUROC = 0,50 zeigt an, dass es keine Vorhersagekraft gibt und AUROC = 1,00 zeigt perfekte Vorhersagekraft an. Mit Zugdaten entwickeltes Modell wird mit Testdaten und vollständigen Daten ausgeführt. Es wird beobachtet, dass es keine signifikanten Abweichungen der AUROC-Werte gibt.
Es wird beobachtet, dass AUROC kleiner ist als 0,6. Dies deutet darauf hin, dass das Modell keine gute Vorhersagekraft hat.. Das Validierungsteam empfiehlt die Verwendung zusätzlicher Variablen, um die Anpassung des Modells zu verbessern.
Gini
Formel: Gini = 2 x AUROC – 1
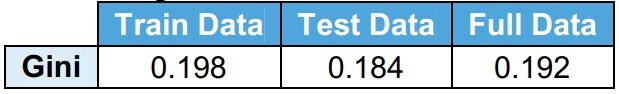
Gini se deriva von AUROC. Gini = 0.0 zeigt an, dass es keine Vorhersagekraft gibt und Gini = 1.0 zeigt perfekte Vorhersagekraft an. Mit Zugdaten entwickeltes Modell wird mit Testdaten und vollständigen Daten ausgeführt. Es wird beobachtet, dass es keine signifikanten Abweichungen bei den Gini-Werten gibt.
Kansas
scipy.stats.ks_2samp
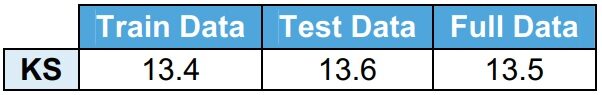
Der Kolmogorov-Smirnov-Test (KS) misst die Trennung zwischen dem kumulativen % von Ereignissen und dem kumulativen % von keinen Ereignissen. Es wird beobachtet, dass die Statistiken der KS-Tests niedriger sind als 40, was darauf hinweist, dass das Modell nicht in der Lage ist, Ereignisse und Nicht-Ereignisse zu trennen.
Gewinn- und Höhendiagramme
Paso 1: Berechnen Sie die Wahrscheinlichkeit jeder Beobachtung.
Paso 2: Ordne diese Wahrscheinlichkeiten in absteigender Reihenfolge.
Paso 3: Konstruieren Sie Dezile, wobei jede Gruppe fast die 10% der Beobachtungen.
Paso 4: Berechnen Sie die Rücklaufquote in jedem Dezil für Gut (Responder), Ein bisschen (Nicht-Responder) und insgesamt.
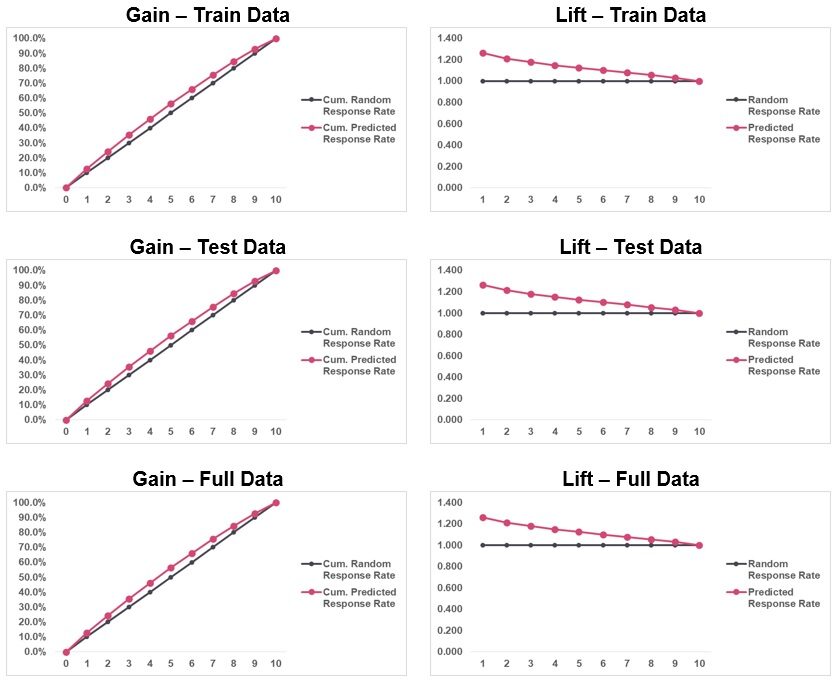
Gewinn- und Höhendiagramme sind Datenvisualisierungstools, die die Fähigkeit des Klassifikators vergleichen, die Antwortrate zu erfassen. Es wird beobachtet, dass die vorhergesagte kumulative Ansprechrate sehr nahe an der kumulativen zufälligen Ansprechrate liegt. Zeigt an, dass das Modell eine geringe Vorhersagekraft hat. Das Validierungsteam empfiehlt die Verwendung zusätzlicher Variablen, um die Anpassung des Modells zu verbessern.
2.4 Modelltests
Sensitivitätsanalyse
Paso 1: alle Variablen normalisieren
Paso 2: Führen Sie die logistische Regression zwischen der abhängigen Variablen und der ersten aus
Paso 3: Führen Sie die logistische Regression zwischen der abhängigen Variablen und der zweiten aus
Paso 4: Wiederholen Sie den vorherigen Schritt für den Rest der Variablen
Paso 5: der Koeffizient der Variablen gibt die Sensitivität zwischen der Variablen und den logarithmischen Wahrscheinlichkeiten der abhängigen Variablen an
Die Sensitivität des Modells gegenüber den unabhängigen numerischen Variablen wird getestet. An den Zugdaten wird die Sensitivität geprüft. Das Ziel dieser Übung besteht darin, die empfindlichsten Variablen zu identifizieren. Es wird beobachtet, dass Alter und risk_score die empfindlichsten Variablen sind und ext_quality_score die am wenigsten empfindliche Variable ist.

2.5. Koeffizientenstabilität
Koeffizientenstabilität
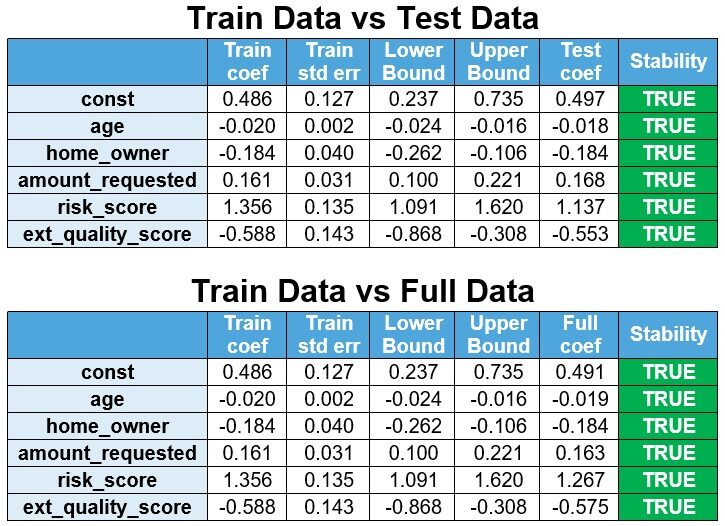
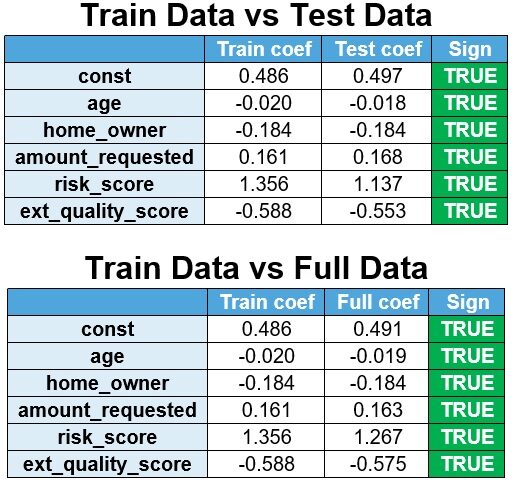
Das Modell wird aus den Testdaten neu geschätzt und die vollständigen Daten und die Koeffizienten werden mit den Zugdaten verglichen. Liegen die Koeffizienten des neu geschätzten Modells innerhalb des Konfidenzintervalls der 95% (Zugbeiwert ± 1,96 x Err std de tren), dann sind die Koeffizienten stabil.
Die untere Grenze ist definiert als Train Coef – 1,96 x Err std of train und die obere Grenze ist definiert als Coef of train + 1,96 x Err std de tren. Es wird beobachtet, dass die Koeffizienten stabil sind.
Signalstabilität
Das Modell wird aus den Testdaten neu geschätzt und die vollständigen Daten und die Koeffizienten werden mit den Zugdaten verglichen.
Es wird beobachtet, dass die Zeichen stabil sind.
Fazit
Die Validierung ergab, dass das Modell stabil ist. Aber trotzdem, Es wurden drei schwerwiegende Befunde erhoben:
· Finden 1 (Eingabedaten) – Es wird beobachtet, dass es Ausreißer im Zugdatensatz gibt. Das Validierungsteam empfiehlt, Ausreißer vor der Entwicklung des Modells zu adressieren.
· Finden 2 (Eingabedaten) – Beachten Sie, dass der Betrag_angefordert & ext_quality_score kein Sohn lineales. Das Validierungsteam empfiehlt, die Transformationen zu testen, um eine lineare Beziehung zu erhalten.
· Ergebnis 3 (Modell fit) – AUROC wird als niedrig beobachtet, Gini ist niedrig und KS ist niedrig, was darauf hinweist, dass das Modell nicht in der Lage ist, Ereignisse und Nicht-Ereignisse zu trennen. Das Validierungsteam empfiehlt die Verwendung zusätzlicher Variablen, um die Anpassung des Modells zu verbessern.
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





